# Hymaïa : datadictionnaire et blog complets
> Définitions Data & IA et articles de blog dans leur intégralité, par Hymaïa (cabinet de conseil et formation Data & IA à Paris). Voir aussi https://www.hymaia.com/llms.txt pour l'index complet du site.
## Datadictionnaire
### Qu'est-ce que /goal en Agentic Coding ?
Source : https://www.hymaia.com/qu-est-ce-que/goal-programmation-declarative/
/goal est une commande de Claude Code qui applique la programmation déclarative aux agents IA : on définit un objectif mesurable plutôt qu'une suite d'instructions. Un évaluateur juge chaque itération, transmet la dernière raison d'échec à l'agent et relance le cycle jusqu'à ce que l'objectif soit atteint.
**/goal** est une commande d'Agentic Coding, popularisée par Claude Code, qui applique la programmation déclarative aux agents IA. Plutôt que de décrire à l'agent la suite d'étapes à suivre, on lui donne un objectif mesurable à atteindre. L'agent gère lui-même le chemin pour y parvenir, itère tant que nécessaire, et s'arrête dès que le but est vérifié comme atteint.
### De l'instruction à l'objectif : programmation impérative vs déclarative
La plupart des interactions avec un agent de coding restent impératives : le développeur détaille les étapes ("ouvre ce fichier, modifie cette fonction, lance ces tests"), un peu comme il écrirait lui-même le code pas à pas. Cette approche fonctionne bien pour des tâches courtes, mais elle demande une supervision constante dès que la tâche s'étale sur plusieurs itérations.
/goal inverse la logique : on ne décrit plus le "comment" mais le "quoi". On formule une ligne d'arrivée — par exemple "réduire le temps d'exécution de la suite de tests de 30 %" ou "supprimer les faux positifs de ce skill sans casser les tests existants" — et l'agent explore lui-même les moyens d'y parvenir. C'est le même changement de paradigme que celui qui distingue un langage déclaratif (SQL, Terraform) d'un langage impératif (Python, Bash) : on spécifie le résultat souhaité, pas la séquence d'opérations pour y arriver.
### Comment fonctionne /goal
Techniquement, /goal met en place une boucle d'itérations pilotée par un évaluateur. À chaque tour, l'agent produit une tentative, puis l'évaluateur détermine si l'objectif est atteint :
- **Si oui**, la boucle s'arrête : l'objectif mesurable a été vérifié comme atteint.
- **Si non**, l'itération continue : l'évaluateur transmet à l'agent la raison précise du dernier échec, qui sert de contexte pour la tentative suivante.
Ce mécanisme de feedback ciblé — ne renvoyer que la dernière raison d'échec plutôt que l'historique complet — permet de garder chaque itération concentrée sur ce qui reste à corriger, plutôt que de saturer le contexte de l'agent avec des tentatives précédentes déjà résolues. Le détail du fonctionnement de l'évaluateur est décrit dans la [documentation officielle de Claude Code](https://code.claude.com/docs/fr/goal#how-evaluation-works).
### Un objectif mesurable, condition indispensable
/goal n'est pas adapté à toutes les tâches. Son efficacité dépend entièrement de la capacité à formuler un objectif vérifiable automatiquement par l'évaluateur : un test qui passe, une métrique chiffrée, un nombre de tokens, un temps d'exécution. Un objectif flou ("améliore la qualité du code") ne donne à l'évaluateur aucun critère d'arrêt fiable, et la boucle risque de tourner sans converger ou de s'arrêter prématurément sur une fausse impression de réussite.
Dans la pratique, on borne aussi la boucle par des garde-fous explicites : nombre maximal d'itérations, périmètre de fichiers autorisés, tolérance zéro sur certains critères (aucune violation de test, aucun faux positif). Ces contraintes évitent qu'un agent laissé à lui-même ne dérive en cherchant à satisfaire l'objectif par des moyens non désirés.
### Cas d'usage concrets
/goal trouve sa place sur des tâches d'optimisation bornées, où le succès se mesure objectivement :
- **Amélioration des performances** : réduire le temps d'exécution d'une suite de tests ou d'un pipeline de build jusqu'à un seuil cible.
- **Optimisation de la consommation de tokens** : fiabiliser un skill ou un agent en réduisant ses appels d'outils et sa consommation de tokens, sans dégrader sa justesse.
- **Correction bornée** : faire converger un agent vers un état "tests verts" ou "zéro régression" sur une fonctionnalité donnée.
### Liens avec l'écosystème agentic engineering
/goal s'inscrit dans une famille plus large de mécanismes de pilotage des agents IA, aux côtés de commandes complémentaires orientées temps ou événement plutôt qu'état à atteindre. Son évaluateur reprend les principes de l'évaluation IA (LLM-as-a-judge, critères de réussite explicites) appliqués non plus à une réponse isolée mais à une boucle d'agent complète. La gestion fine du feedback transmis à chaque itération relève du context engineering : on choisit délibérément de ne renvoyer que l'information la plus utile — la dernière raison d'échec — plutôt que tout l'historique. Et lorsque l'objectif dépasse les capacités d'un agent unique, /goal peut piloter une orchestration multi-agents, chaque itération pouvant déléguer des sous-tâches à des agents spécialisés.
---
### Qu'est-ce que /loop en Agentic Coding ?
Source : https://www.hymaia.com/qu-est-ce-que/loop-automatisation-recurrente/
/loop est une commande de Claude Code qui répète un prompt à intervalle régulier au sein d'une même session : on précise une durée (5 secondes, 5 minutes, 10 minutes...) et une instruction, relancée automatiquement à chaque échéance jusqu'à 7 jours maximum.
**/loop** est une commande d'Agentic Coding, disponible dans Claude Code, qui exécute un même prompt à intervalle régulier. On écrit `/loop`, on ajoute un intervalle (5 secondes, 5 minutes, 10 minutes, peu importe l'unité) et un prompt : ce prompt est relancé à chaque échéance, sans intervention manuelle.
### Comment fonctionne /loop
La commande prend deux paramètres : un intervalle de temps et une instruction. Une fois lancée, l'agent exécute le prompt une première fois, attend l'intervalle défini, puis relance exactement le même prompt, et ainsi de suite. C'est un mécanisme volontairement simple, pensé pour de la surveillance ou de la répétition de tâche, pas pour de l'orchestration complexe.
### Les deux limites à connaître
/loop reste scopée à la session dans laquelle elle a été lancée : si la session est fermée, la boucle s'arrête avec elle. Même session ouverte, /loop ne tourne jamais plus de 7 jours consécutifs.
Quand une boucle doit continuer à tourner même session fermée, /loop n'est plus l'outil adapté : il faut passer par `/schedule`, qui persiste indépendamment de la session. En contrepartie, `/schedule` impose un intervalle minimum d'une heure, là où /loop accepte des intervalles de quelques secondes.
### /loop ou /schedule : comment choisir
Le choix se fait sur deux critères : la fréquence recherchée et la durée de vie de la tâche.
- **Vérification rapprochée, le temps d'une session** : `/loop` avec un intervalle court (secondes à minutes), par exemple pour surveiller la fin d'un build ou relancer un test tant qu'il échoue.
- **Tâche récurrente sur plusieurs jours ou semaines, indépendante de la session** : `/schedule`, avec un intervalle d'au moins une heure, par exemple pour un rapport quotidien ou une vérification hebdomadaire.
### Liens avec l'écosystème agentic engineering
/loop appartient à la même famille de commandes que `/goal`, qui pilote elle aussi une boucle d'itérations, mais sur un critère différent : `/loop` relance le prompt sur une base temporelle fixe, tandis que `/goal` relance l'agent jusqu'à ce qu'un objectif mesurable soit atteint, sans notion de délai entre les tentatives. Le choix entre les deux dépend de la nature de la condition d'arrêt : une échéance de temps pour `/loop`, un état vérifiable pour `/goal`.
---
### Qu'est-ce que le protocole A2A (Agent-to-Agent) ?
Source : https://www.hymaia.com/qu-est-ce-que/a2a-protocol/
Le protocole A2A (Agent-to-Agent) est un standard ouvert proposé par Google en avril 2025 pour permettre à des agents IA de différents fournisseurs de communiquer et collaborer. Complémentaire du MCP (Model Context Protocol), il standardise la découverte, la négociation et l'échange de tâches entre agents.
Le **protocole A2A** (Agent-to-Agent) est une spécification ouverte publiée par Google en avril 2025, conçue pour permettre à des agents IA hétérogènes — développés par des équipes différentes, tournant sur des plateformes différentes, utilisant des LLMs différents — de se découvrir, communiquer et collaborer sur des tâches.
### Le problème de l'interopérabilité
L'écosystème des agents IA se développe rapidement, mais chaque framework (LangChain, CrewAI, AutoGen, Semantic Kernel) définit ses propres conventions pour la communication entre agents. Un agent construit avec CrewAI ne peut pas nativement collaborer avec un agent construit avec LangGraph. Cette fragmentation freine le déploiement de systèmes multi-agents à l'échelle de l'entreprise, où des équipes différentes développent des agents spécialisés avec des technologies différentes.
Le protocole A2A vise à jouer pour les agents IA le rôle que HTTP a joué pour le web : un standard commun qui permet l'interopérabilité indépendamment des implémentations sous-jacentes.
### Architecture du protocole
Le protocole A2A repose sur plusieurs mécanismes :
**Agent Card.** Chaque agent publie une "carte d'agent" — un document JSON décrivant ses capacités, ses compétences, les types de tâches qu'il peut traiter, et les modalités d'interaction qu'il supporte (texte, fichiers, données structurées). Cette carte permet à d'autres agents (ou à un orchestrateur) de découvrir dynamiquement les agents disponibles et de choisir le bon agent pour une tâche donnée.
**Task (tâche).** L'unité de travail dans le protocole A2A. Un agent client envoie une tâche à un agent distant, qui la traite et retourne un résultat. Les tâches ont un cycle de vie explicite (soumise, en cours, terminée, échouée) avec des mises à jour en temps réel via Server-Sent Events ou polling.
**Message et Part.** Les échanges au sein d'une tâche sont structurés en messages, eux-mêmes composés de "parts" (parties). Une part peut être du texte, un fichier, des données structurées ou une référence à une ressource externe. Cette modularité permet des échanges riches au-delà du simple texte.
**Négociation de capacités.** Avant de déléguer une tâche, l'agent client peut interroger l'agent distant sur ses capacités spécifiques (langues supportées, formats acceptés, latence estimée) pour vérifier la compatibilité.
### A2A et MCP : complémentaires, pas concurrents
La confusion est fréquente entre A2A et le MCP (Model Context Protocol) d'Anthropic. Les deux protocoles opèrent à des niveaux différents :
- Le **MCP** standardise la connexion entre un agent et ses **outils** (bases de données, APIs, systèmes de fichiers). C'est un protocole agent-vers-outil.
- Le **A2A** standardise la communication entre **agents**. C'est un protocole agent-vers-agent.
Un agent peut utiliser le MCP pour accéder à ses outils locaux, et le A2A pour déléguer une sous-tâche à un autre agent spécialisé. Les deux protocoles sont conçus pour coexister dans une architecture d'IA agentique complète.
### Cas d'usage
**Entreprise multi-équipes.** L'équipe RH développe un agent de recrutement, l'équipe finance un agent de gestion budgétaire, l'équipe juridique un agent de conformité. Grâce au A2A, un processus d'embauche peut orchestrer les trois agents : vérifier le budget du poste, évaluer la conformité de l'offre, et publier l'annonce — sans que les équipes aient besoin de coordonner leurs implémentations techniques.
**Marketplace d'agents.** Les fournisseurs SaaS peuvent exposer leurs fonctionnalités sous forme d'agents A2A, créant un écosystème où des agents tiers collaborent de manière standardisée.
**Supply chain.** Des agents appartenant à des organisations différentes (fournisseur, transporteur, distributeur) collaborent sur le suivi et l'optimisation de la chaîne logistique via un protocole commun.
### Adoption et écosystème
Google a lancé le A2A avec le soutien de plus de 50 partenaires technologiques, dont Salesforce, SAP, Deloitte et plusieurs fournisseurs de frameworks d'agents. La spécification est ouverte et hébergée sur GitHub. Plusieurs implémentations de référence existent en Python et JavaScript.
L'adoption reste au stade initial : la plupart des déploiements en production utilisent encore des intégrations point-à-point entre agents. Le succès du A2A dépendra de sa capacité à démontrer une valeur concrète par rapport à ces intégrations ad hoc, en particulier dans les systèmes de compound AI systems où l'orchestration de multiples composants est un enjeu central.
### Limites et défis
La sécurité inter-agents est un sujet ouvert : comment un agent vérifie-t-il l'identité et les autorisations d'un agent distant ? Le protocole spécifie des mécanismes d'authentification, mais la confiance entre agents de différentes organisations reste un défi. La gestion des erreurs dans des chaînes de délégation longues (agent A → agent B → agent C) pose aussi des questions de résilience et de débogage.
---
### Qu'est-ce que l'Agentic Analytics ?
Source : https://www.hymaia.com/qu-est-ce-que/agentic-analytics/
L'Agentic Analytics désigne des systèmes où des agents IA autonomes explorent la donnée, décomposent une question complexe en dizaines de requêtes, et produisent une analyse gouvernée, avec une supervision humaine minimale plutôt qu'un pilotage manuel de chaque étape.
L'**Agentic Analytics** désigne des systèmes où des agents IA autonomes explorent la donnée, planifient une investigation en plusieurs étapes et produisent une analyse gouvernée, avec une supervision humaine minimale plutôt qu'un pilotage manuel de chaque requête. Contrairement au BI classique, qui attend qu'un analyste écrive une requête, ces systèmes surveillent en continu, décomposent une question complexe et déclenchent l'analyse eux-mêmes.
### En quoi ça diffère du BI classique et de l'analytics augmentée
Le **BI classique** repose sur des rapports statiques et des requêtes manuelles : un analyste formule une question, écrit du SQL, produit un dashboard. L'**analytics augmentée** ajoute une couche d'assistance (suggestions, résumés automatiques) mais laisse l'analyste piloter chaque étape. L'**Agentic Analytics** change de registre : le système planifie une investigation entière, l'exécute de façon autonome, et ne sollicite l'humain qu'au cadrage initial et à la validation finale.
Une question comme "pourquoi notre ARR dérive-t-il ?" n'entre pas dans une seule requête SQL. Il faut la décomposer en dizaines de sous-questions, chacune traduite en requête, avant de synthétiser les résultats. C'est précisément ce que l'Agentic Analytics automatise.
### L'architecture type
Un système d'Agentic Analytics s'appuie généralement sur six briques complémentaires :
- **Données.** Un accès unifié aux sources structurées et non structurées, avec des pipelines fiables et des métadonnées riches.
- **Orchestration.** La coordination de workflows multi-étapes, souvent via un agent superviseur qui délègue à des agents spécialisés.
- **Raisonnement IA.** Les modèles de langage qui interprètent les résultats intermédiaires et décident des prochaines étapes.
- **Couche sémantique.** Le **Semantic Layer** qui garantit que chaque agent utilise la même définition d'une métrique, sans quoi l'automatisation multiplie les incohérences au lieu de les réduire.
- **Action.** Le déclenchement de workflows, d'alertes ou de rapports une fois l'investigation terminée.
- **Boucle de rétroaction.** Un mécanisme d'apprentissage continu qui améliore le système à partir des investigations passées.
### Les principes qui rendent un système fiable
Au-delà de l'architecture, quatre principes de conception distinguent un système d'Agentic Analytics fiable d'un prototype fragile :
- **Mémoire externe.** Plutôt que de tout faire tenir dans la fenêtre de contexte d'un agent, l'état de l'investigation vit dans un fichier externe (souvent un simple fichier Markdown), lisible et modifiable par un humain. Cela évite la dégradation de performance et l'explosion des coûts liées à un contexte qui grossit sans cesse.
- **Décomposition en tâches atomiques.** Un LLM excelle sur une tâche unique et bien cadrée, beaucoup moins sur un enchaînement de six étapes. Découper l'investigation en dizaines de requêtes unitaires, chacune confiée à un agent dédié avec une fenêtre de contexte fraîche, réduit drastiquement les erreurs.
- **Orchestration par agents spécialisés.** Un agent orchestrateur lit le plan, appelle un sous-agent pour chaque tâche, et passe au suivant une fois le résultat consigné. Chaque sous-agent ne voit que ce dont il a besoin pour sa tâche, ce qui limite les hallucinations et les coûts.
- **Supervision humaine en début et en fin.** L'humain cadre l'investigation au départ (objectif, contexte, pièges à éviter) et valide les résultats à l'arrivée, mais n'intervient pas à chaque étape intermédiaire. C'est ce qui distingue l'autonomie encadrée du pilotage automatique sans filet.
### Le cas Photoroom : l'Insight Factory
Juliette Duizabo, Head of Data chez Photoroom, a présenté lors du Hymaday Agentic Analytics (voir le replay) le système qu'elle a construit pour appliquer ces principes : l'Insight Factory.
Le principe : une question complexe reçue sur Slack devient un fichier d'investigation Markdown, construit en 15 minutes de dialogue avec un agent (le "brief builder") qui pose toutes les questions de cadrage nécessaires. Une fois le plan de tâches validé, un agent orchestrateur prend le relais : il appelle un sous-agent par tâche, chacun avec une fenêtre de contexte neuve, qui exécute une requête SQL, consigne son résultat dans le fichier, et s'arrête là. Une fois toutes les tâches faites, un dernier agent synthétise les résultats en un rapport.
Chaque étape est écrite dans des fichiers versionnés (le plan, les requêtes SQL, la synthèse), ce qui rend l'ensemble auditable : Juliette peut relire exactement ce que chaque agent a fait et sur quelle base, ou relancer la même investigation trimestre après trimestre. Les résultats sont concrets : une investigation qui prenait plusieurs jours se fait désormais en quelques heures, pour un coût moyen d'environ 30 dollars, avec une équipe data de trois personnes pour 140 collaborateurs.
Le même principe s'applique au-delà des investigations ponctuelles : chez Photoroom, un agent surveille chaque nuit les tests dbt qui échouent, ouvre une pull request corrective et ne notifie l'équipe qu'une fois les tests repassés au vert.
### Prérequis et risques
L'Agentic Analytics ne fonctionne que si les fondations data sont solides. Sans données propres, testées et documentées, l'automatisation ne réduit pas les erreurs : elle les multiplie, à la vitesse d'un LLM. Les prérequis critiques sont connus :
- **Qualité et gouvernance des données.** Des pipelines fiables, des métadonnées riches, un Semantic Layer testé et versionné.
- **Contrôles d'accès et pistes d'audit.** Qui peut lancer une investigation, sur quelles données, avec quel budget de tokens.
- **Confiance et explicabilité.** Un raisonnement traçable, une limite claire de l'autonomie, des points de validation humaine sur les décisions à fort impact.
- **Maîtrise des coûts.** Un système agentique peut multiplier les appels LLM ; sans limite par tâche, les coûts dérivent vite à l'échelle d'une organisation entière.
### Cas d'usage concrets
- **Root cause analysis autonome** : comprendre pourquoi un KPI dérive, en décomposant la question en dizaines de requêtes plutôt qu'en laissant un analyste y passer plusieurs jours.
- **Détection de fraude en continu** : surveiller des flux de transactions et déclencher une alerte dès qu'un pattern suspect apparaît.
- **Diagnostic de baisse de conversion** : identifier automatiquement les segments, pays ou plateformes responsables d'une baisse de performance.
- **Maintenance prédictive** : croiser des signaux opérationnels pour anticiper une panne avant qu'elle ne survienne.
- **Bug fixing automatisé sur les pipelines de données** : détecter un test qui échoue, proposer un correctif, et ne solliciter l'humain qu'en cas de doute.
---
### Qu'est-ce qu'un agent IA et comment fonctionne-t-il ?
Source : https://www.hymaia.com/qu-est-ce-que/agents-ia/
Un agent IA est un système d'intelligence artificielle capable de percevoir son environnement, raisonner et agir de manière autonome pour accomplir des objectifs, sans intervention humaine constante.
Un agent IA est un programme informatique qui va au-delà de la simple génération de texte : il perçoit son environnement, raisonne sur les informations disponibles et exécute des actions de manière autonome pour atteindre un objectif défini. Là où un chatbot suit des scripts et où un assistant IA exécute des tâches à la demande, l'agent IA prend des initiatives, s'adapte aux imprévus et enchaîne plusieurs étapes sans qu'un humain intervienne à chaque fois.
### Chatbot, assistant, agent : trois niveaux d'autonomie
La distinction entre ces trois types de systèmes repose sur leur degré d'autonomie. Le chatbot, apparu dans les années 1960, reste une interface conversationnelle réactive : il répond à des questions selon des règles prédéfinies ou un modèle de langage, mais ne prend aucune initiative. L'assistant IA ajoute l'accès à des outils externes (recherche web, calcul, bases de données) et peut enchaîner quelques actions, mais toujours sous la supervision directe de l'utilisateur.
L'agent IA franchit un cap en combinant trois capacités fondamentales : la perception (il observe et comprend son environnement via des données, des API ou des capteurs), le raisonnement (il analyse la situation et planifie une séquence d'actions), et l'action (il exécute ces actions de façon autonome, en s'adaptant si les résultats ne correspondent pas aux attentes).
### Comment fonctionne un agent IA
Un agent IA s'appuie sur un LLM comme moteur de raisonnement, mais y ajoute plusieurs composants. Un module de planification décompose un objectif complexe en sous-tâches. Un système de mémoire (court terme et long terme) lui permet de garder le contexte au fil des interactions. Et un ensemble d'outils — API, bases de données, services web — lui donne la capacité d'agir concrètement sur son environnement.
Le cycle de fonctionnement suit une boucle perception-raisonnement-action. L'agent reçoit une tâche, analyse le contexte disponible, décide de la prochaine action, l'exécute, observe le résultat, puis ajuste sa stratégie si nécessaire. Ce cycle se répète jusqu'à ce que l'objectif soit atteint ou qu'une limite soit rencontrée.
Le protocole MCP (Model Context Protocol), initié par Anthropic et largement adopté, standardise la connexion entre agents IA et outils externes. Au lieu de développer une intégration sur mesure pour chaque outil, MCP fournit une interface uniforme qui simplifie le développement et favorise l'interopérabilité.
### Systèmes multi-agents
Quand une tâche dépasse les capacités d'un seul agent, on peut orchestrer plusieurs agents spécialisés en système multi-agents. Un agent orchestrateur coordonne des agents spécialisés — l'un en recherche d'information, l'autre en rédaction, un troisième en vérification — comme un chef de projet répartit le travail dans une équipe. Le protocole A2A (Agent-to-Agent) de Google complète MCP en standardisant la communication entre agents.
Cette approche apporte une spécialisation accrue, une meilleure gestion des tâches complexes et une forme de contrôle mutuel entre agents. Elle introduit aussi des risques spécifiques : une hallucination peut se propager d'un agent à l'autre si les mécanismes de vérification sont insuffisants.
### Cas d'usage concrets
Les agents IA trouvent des applications dans de nombreux domaines. En gestion des opérations, un agent peut surveiller un inventaire, passer des commandes automatiquement quand le stock est bas et négocier les prix avec des fournisseurs. En ingénierie logicielle, des agents de coding comme Cursor ou Claude Code assistent les développeurs en générant, testant et déboguant du code de manière autonome. En support client, les agents gèrent des demandes complexes nécessitant plusieurs étapes (vérification de compte, diagnostic technique, résolution) sans escalade humaine.
### Limites et vigilance
Les agents IA héritent des limites des LLM qui les alimentent : hallucinations, biais, sensibilité au prompt engineering. L'autonomie amplifie ces risques car un agent peut enchaîner des actions basées sur un raisonnement erroné avant qu'un humain ne détecte le problème. La consommation de tokens (et donc d'énergie) est aussi significativement plus élevée que pour un simple appel à un LLM, ce qui pose des questions d'IA responsable.
La mise en place de guardrails IA — limites d'actions, validation humaine sur les décisions à fort impact, monitoring des comportements — reste indispensable pour un déploiement fiable en entreprise.
---
### Qu'est-ce que l'AI Act, le règlement européen sur l'IA ?
Source : https://www.hymaia.com/qu-est-ce-que/ai-act/
L'AI Act est le règlement européen qui encadre le développement et l'utilisation des systèmes d'intelligence artificielle dans l'UE, avec des obligations graduées selon le niveau de risque.
L'AI Act (Artificial Intelligence Act) est le premier cadre réglementaire au monde dédié spécifiquement à l'intelligence artificielle. Adopté par le Parlement européen en mars 2024 et publié au Journal officiel de l'UE en juillet 2024, ce règlement établit des règles harmonisées pour le développement, la mise sur le marché et l'utilisation des systèmes d'IA dans l'Union européenne.
### Une approche par les risques
Le principe structurant de l'AI Act est la classification des systèmes d'IA selon quatre niveaux de risque, chacun entraînant des obligations proportionnées :
**Risque inacceptable** — Ces systèmes sont purement et simplement interdits. Cela inclut le scoring social par les autorités publiques, la manipulation comportementale exploitant des vulnérabilités (âge, handicap), la reconnaissance faciale en temps réel dans l'espace public (sauf exceptions strictes liées à la sécurité) et la catégorisation biométrique basée sur des caractéristiques sensibles.
**Risque élevé** — Ces systèmes sont autorisés mais soumis à des obligations strictes : évaluation de conformité, documentation technique détaillée, système de gestion des risques, supervision humaine, marquage CE et enregistrement dans une base de données européenne. Sont concernés les systèmes utilisés en recrutement, éducation, justice, santé, crédit scoring ou gestion des infrastructures critiques.
**Risque limité** — Les systèmes comme les chatbots ou les générateurs de contenu par IA générative doivent respecter des obligations de transparence : informer l'utilisateur qu'il interagit avec une IA et signaler les contenus générés artificiellement (deepfakes notamment).
**Risque minimal** — La grande majorité des systèmes d'IA (filtres anti-spam, jeux vidéo, systèmes de recommandation) peuvent être utilisés librement, sans obligation réglementaire spécifique.
### Obligations spécifiques pour les modèles de fondation
L'AI Act introduit des règles dédiées aux modèles d'IA à usage général (GPAI), comme les LLM. Tous les fournisseurs de GPAI doivent fournir une documentation technique et respecter le droit d'auteur. Les modèles présentant un "risque systémique" (seuil fixé à 10^25 FLOPS d'entraînement) ont des obligations renforcées : tests adverses, évaluation des risques systémiques, signalement d'incidents et mesures de cybersécurité.
### Calendrier d'application
L'entrée en vigueur est progressive :
- Février 2025 : interdiction des pratiques à risque inacceptable
- Août 2025 : règles sur les modèles GPAI et création des autorités de supervision
- Août 2026 : application complète pour les systèmes à haut risque
- Août 2027 : application aux systèmes d'IA intégrés dans des produits réglementés
### Sanctions
Les amendes sont calibrées pour être dissuasives : jusqu'à 35 millions d'euros ou 7 % du chiffre d'affaires annuel mondial pour les violations les plus graves (pratiques interdites), 15 millions ou 3 % pour les obligations sur les GPAI, et 7,5 millions ou 1 % pour les informations fausses fournies aux autorités.
### Impact pour les entreprises
Toute organisation qui développe, déploie ou distribue un système d'IA sur le marché européen est concernée, quel que soit son lieu d'établissement — une portée extraterritoriale directement inspirée du RGPD. En pratique, les entreprises doivent cartographier leurs systèmes d'IA existants, évaluer leur niveau de risque et mettre en place une gouvernance IA adaptée. Cette démarche rejoint les enjeux plus larges d'IA responsable et de data governance, en plaçant la transparence et la maîtrise des risques au centre de la stratégie IA.
---
### Qu'est-ce qu'un AI Champion en entreprise ?
Source : https://www.hymaia.com/qu-est-ce-que/ai-champion/
Un AI Champion est un collaborateur formé pour accélérer l'adoption de l'intelligence artificielle au sein de son équipe ou département. Il fait le pont entre l'expertise technique et les métiers, identifie les cas d'usage pertinents et accompagne ses collègues dans la prise en main des outils IA.
Un **AI Champion** est un collaborateur désigné ou volontaire qui joue le rôle de référent IA au sein de son équipe, département ou business unit. Sa mission : faciliter l'adoption de l'intelligence artificielle en servant de relais entre les équipes techniques (data scientists, ML engineers, AI engineers) et les équipes métiers qui utilisent — ou pourraient utiliser — ces technologies au quotidien.
### Un rôle de pont, pas d'expert technique
L'AI Champion n'est pas un data scientist ni un ingénieur IA. C'est un professionnel métier qui possède une compréhension suffisante de l'IA pour identifier des opportunités concrètes dans son périmètre de travail. Il sait traduire un besoin métier en cas d'usage IA réaliste, et inversement, vulgariser les capacités et limites d'un modèle auprès de ses collègues.
Cette position intermédiaire est stratégique. Beaucoup de projets IA échouent non pas par manque de technologie, mais par manque de connexion entre les équipes qui construisent les solutions et celles qui doivent les utiliser. L'AI Champion comble ce fossé.
### Les responsabilités concrètes d'un AI Champion
Le périmètre d'un AI Champion varie selon les organisations, mais couvre généralement plusieurs axes :
**Identification de cas d'usage.** L'AI Champion repère les tâches répétitives, les goulots d'étranglement ou les processus manuels susceptibles d'être automatisés ou augmentés par l'IA. Il évalue la faisabilité et l'impact potentiel de chaque cas avant de le remonter aux équipes techniques.
**Accompagnement des équipes.** Il forme ses collègues aux outils IA disponibles dans l'entreprise, organise des démonstrations, partage les bonnes pratiques et aide à surmonter les résistances au changement. Ce rôle de facilitation est fondamental pour ancrer l'usage de l'IA dans les habitudes de travail.
**Remontée de feedback.** L'AI Champion collecte les retours terrain sur les outils déployés : ce qui fonctionne, ce qui freine, ce qui manque. Ce feedback alimente l'amélioration continue des solutions et oriente la roadmap des équipes data et IA.
**Veille et partage.** Il se tient informé des évolutions des outils et pratiques IA, teste de nouvelles fonctionnalités et partage ses découvertes au sein de son réseau interne.
### Pourquoi le rôle d'AI Champion est devenu indispensable
L'émergence de l'IA générative a considérablement élargi le périmètre des collaborateurs concernés par l'IA. Là où les projets de machine learning traditionnels impliquaient surtout des profils techniques, les outils comme ChatGPT, Copilot ou les agents IA touchent désormais tous les métiers : marketing, finance, RH, juridique, opérations.
Cette démocratisation crée un besoin massif d'accompagnement. Sans AI Champions, les organisations font face à deux risques symétriques :
- **La sous-utilisation** : les outils IA sont déployés mais peu adoptés, faute de formation et d'accompagnement adaptés au contexte métier.
- **L'usage non maîtrisé** : les collaborateurs utilisent l'IA sans cadre (données confidentielles partagées avec des outils publics, décisions prises sur la base d'hallucinations non détectées).
L'AI Champion permet de naviguer entre ces deux écueils en ancrant l'adoption dans un cadre structuré.
### Le lien avec la Data Literacy et l'AI Ops
Le rôle d'AI Champion s'inscrit dans une démarche plus large de **Data Literacy** — la capacité collective d'une organisation à comprendre et utiliser les données. Un programme d'AI Champions renforce cette culture data en la rendant tangible et opérationnelle au niveau des équipes.
Du côté opérationnel, l'AI Champion interagit avec les pratiques d'**AI Ops** : il est souvent le premier à détecter qu'un modèle en production ne répond plus aux attentes métiers, à signaler un problème de qualité des prédictions ou à identifier un besoin de réentraînement.
### Mettre en place un réseau d'AI Champions
Un programme d'AI Champions efficace repose sur plusieurs éléments :
- **La sélection** : privilégier des profils curieux, influents dans leur équipe et à l'aise avec le changement. Le titre hiérarchique importe peu — c'est la capacité d'entraînement qui compte.
- **La formation** : doter les champions d'une compréhension solide des fondamentaux de l'IA (types de modèles, limites, biais, prompt engineering) sans viser l'expertise technique.
- **L'animation** : créer une communauté de champions qui échangent régulièrement, partagent leurs succès et leurs échecs, et s'entraident.
- **Le mandat** : donner aux champions un temps dédié et un mandat clair de leur management, pour éviter que le rôle ne soit perçu comme une charge supplémentaire sans reconnaissance.
### AI Champion et transformation organisationnelle
Le réseau d'AI Champions est un levier de transformation à la fois bottom-up et top-down. Bottom-up parce que les cas d'usage émergent du terrain. Top-down parce que le programme nécessite un sponsoring de la direction et une coordination avec la stratégie IA de l'entreprise.
Les organisations qui réussissent leur transformation IA sont souvent celles qui investissent autant dans les compétences humaines que dans la technologie. L'AI Champion incarne cette conviction : la technologie seule ne suffit pas, c'est l'appropriation par les métiers qui crée la valeur.
---
### Qu'est-ce qu'un AI copilot ?
Source : https://www.hymaia.com/qu-est-ce-que/ai-copilot/
Un AI copilot est un assistant IA intégré dans un outil métier qui augmente la productivité de l'utilisateur en suggérant, corrigeant et automatisant des tâches dans son flux de travail. À la différence d'un agent IA autonome, le copilot assiste l'humain qui garde le contrôle des décisions.
Un **AI copilot** est un système d'intelligence artificielle embarqué directement dans un outil de travail (IDE, suite bureautique, CRM, outil de design) pour assister l'utilisateur dans ses tâches quotidiennes. Le terme "copilot" -- emprunt à l'aviation -- traduit une idée précise : l'IA n'est pas aux commandes, elle assiste le pilote.
### L'origine du terme
Le terme s'est imposé dans l'industrie avec le lancement de **GitHub Copilot** en juin 2022, un assistant de code développé par GitHub (Microsoft) et OpenAI. Basé sur le modèle Codex, puis sur GPT-4, GitHub Copilot suggère des complétions de code en temps réel dans l'éditeur du développeur. Microsoft a ensuite généralisé la marque "Copilot" à l'ensemble de ses produits : Microsoft 365 Copilot (Word, Excel, PowerPoint, Teams), Copilot in Windows, Copilot Studio (pour créer ses propres copilots).
D'autres acteurs ont suivi avec leurs propres assistants intégrés : Cursor (éditeur de code avec IA native), Notion AI, Figma AI, Adobe Firefly dans Creative Cloud, Salesforce Einstein Copilot.
### Comment fonctionne un copilot
Un copilot repose sur trois mécanismes fondamentaux :
**1\. L'accès au contexte de travail.** Le copilot a accès au document, au code ou aux données sur lesquelles l'utilisateur travaille. C'est ce qui le distingue d'un chatbot générique : il voit ce que l'utilisateur voit. Dans un IDE, il lit le fichier en cours, les fichiers voisins, les dépendances. Dans une suite bureautique, il accède au document, aux emails liés, à l'agenda.
**2\. La génération proactive de suggestions.** Plutôt que d'attendre une question, le copilot anticipe. Il propose une complétion de code, un paragraphe suivant, une formule Excel, un résumé de meeting. L'utilisateur accepte, modifie ou rejette la suggestion d'un raccourci clavier. Ce flux de travail -- proposition/validation -- est au cœur de l'expérience copilot.
**3\. L'interaction conversationnelle.** En complément des suggestions proactives, le copilot offre généralement une interface de chat où l'utilisateur peut poser des questions, demander des modifications ou des explications. "Refactorise cette fonction", "résume ce document en 3 points", "explique cette formule".
### Copilot vs agent : une distinction importante
La frontière entre copilot et agent IA mérite d'être clarifiée, car les deux termes sont parfois confondus :
**Le copilot assiste.** Il suggère, l'humain décide. Le copilot ne prend pas d'action sans validation. Il fonctionne dans la boucle de travail de l'utilisateur (human-in-the-loop). Son périmètre d'action est limité à l'outil dans lequel il est intégré.
**L'agent agit.** Il reçoit un objectif et exécute de façon autonome, en enchaînant plusieurs actions, utilisant des outils, et prenant des décisions intermédiaires. Un agent peut naviguer entre plusieurs systèmes et effectuer des tâches sans supervision constante.
En pratique, la distinction est un spectre. Certains copilots évoluent vers plus d'autonomie (GitHub Copilot Workspace qui peut modifier plusieurs fichiers), et certains agents conservent des points de validation humaine. Le curseur entre autonomie et contrôle humain est un choix de design produit qui dépend du contexte et du niveau de risque.
### Impact sur la productivité
Les données disponibles montrent un impact réel mais nuancé :
- GitHub rapporte que les développeurs utilisant Copilot acceptent environ 30 % des suggestions proposées et codent plus rapidement sur les tâches répétitives.
- Microsoft indique que les utilisateurs de Microsoft 365 Copilot passent moins de temps en meetings grâce aux résumés automatiques et à la génération de comptes-rendus.
- Les gains les plus importants concernent les tâches répétitives et peu créatives : boilerplate code, mise en forme, synthèse de documents longs, première ébauche de contenu.
Les limites apparaissent sur les tâches à forte expertise : un copilot peut générer du code fonctionnel mais architecturalement discutable, ou produire un résumé qui passe à côté des nuances stratégiques d'un document.
### Déploiement en entreprise
Le déploiement de copilots en entreprise soulève des questions que le LLMOps doit adresser :
**Confidentialité des données.** Le copilot a accès à des documents internes, du code propriétaire, des données clients. Où ces données sont-elles traitées ? Microsoft 365 Copilot traite les données dans le périmètre du tenant, mais les copilots basés sur des API tierces envoient les données à l'extérieur.
**Adoption et formation.** Un copilot mal compris est sous-utilisé ou mal utilisé. Les équipes doivent apprendre à formuler des requêtes efficaces (prompt engineering), à évaluer les suggestions (esprit critique), et à identifier les situations où le copilot est utile vs contreproductif.
**Coût.** Microsoft 365 Copilot coûte 30 USD par utilisateur et par mois. GitHub Copilot Business coûte 19 USD. À l'échelle d'une organisation, le ROI doit être démontré sur des cas d'usage concrets.
**Gouvernance.** L'AI Act classe les systèmes d'IA selon leur niveau de risque. Un copilot qui assiste un médecin ou un juriste n'a pas les mêmes obligations qu'un copilot de rédaction de contenu marketing. La data governance doit définir les règles d'usage par contexte.
### L'avenir des copilots
La tendance est à l'intégration toujours plus profonde dans les outils existants, plutôt qu'à la création d'outils IA séparés. L'objectif est que l'IA soit invisible, intégrée dans le flux de travail, et non une application supplémentaire à ouvrir. Chaque outil métier aura son copilot, alimenté par les données de l'organisation via des architectures RAG et des protocoles comme MCP.
---
### Qu'est-ce que l'AI Death Cycle ?
Source : https://www.hymaia.com/qu-est-ce-que/ai-death-cycle/
L'AI Death Cycle est le cercle vicieux dans lequel les projets IA échouent faute de fondations data solides, renforçant le scepticisme de l'organisation, réduisant les investissements et dégradant les conditions de succès des projets suivants. Comprendre ce cycle est la première étape pour en sortir.
L'**AI Death Cycle** désigne le cercle vicieux dans lequel tombent de nombreuses organisations lorsqu'elles tentent de déployer des projets d'intelligence artificielle sans disposer des fondations nécessaires. Le cycle se nourrit de lui-même : chaque échec renforce les conditions du suivant, jusqu'à ce que l'organisation renonce — temporairement ou durablement — à investir dans l'IA.
### Les étapes du cycle
Le mécanisme de l'AI Death Cycle suit une séquence prévisible :
**1\. Lancement sur des fondations fragiles.** L'organisation lance un projet IA ambitieux — prédiction de la demande, scoring client, automatisation d'un processus — sans avoir vérifié que les données nécessaires existent, sont accessibles et sont de qualité suffisante. Le projet démarre souvent sous pression (un concurrent a lancé quelque chose, la direction veut montrer des résultats) sans investissement préalable sur l'infrastructure data.
**2\. Résultats décevants.** Le projet rencontre des obstacles prévisibles : données manquantes ou incohérentes, absence de pipeline de données fiable, difficulté à mettre le modèle en production, écart entre les performances en POC et les performances en conditions réelles. Le livrable final ne tient pas ses promesses — quand il est livré.
**3\. Perte de confiance.** L'échec du projet alimente le scepticisme des métiers et de la direction. "L'IA, ça ne marche pas chez nous", "on a investi pour rien", "nos données ne sont pas prêtes". Les sponsors internes se désengagent. Les équipes métiers, échaudées, deviennent réticentes à participer aux projets suivants.
**4\. Réduction des investissements.** Le budget data et IA est réduit ou redirigé. Les recrutements sont gelés. Les initiatives de **Data Governance**, de nettoyage de données ou de modernisation de la **Data Platform** — jugées trop coûteuses et trop peu visibles — passent à la trappe.
**5\. Dégradation continue des fondations.** Sans investissement, la qualité des données stagne ou se dégrade. Les compétences data se diluent. L'infrastructure vieillit. Et quand l'organisation décide de retenter un projet IA — sous une nouvelle impulsion, avec un nouveau prestataire — les conditions de succès sont encore pires qu'au premier essai.
Et le cycle recommence.
### Pourquoi le cycle est si fréquent
Plusieurs facteurs expliquent la prévalence de l'AI Death Cycle :
**Le biais du POC.** Beaucoup d'organisations confondent la réussite d'un proof of concept avec la capacité à industrialiser une solution IA. Un POC peut fonctionner avec un jeu de données nettoyé manuellement par un data scientist. La production exige des pipelines automatisés, un monitoring continu, une gestion du **Data Drift** — tout un écosystème **MLOps** que le POC n'a pas testé.
**L'inversion des priorités.** L'IA est sexy, les fondations data ne le sont pas. Les organisations investissent dans l'algorithme avant d'investir dans la donnée, alors que la hiérarchie des besoins est claire : sans données fiables, pas de modèles fiables.
**L'absence de diagnostic préalable.** Les projets IA sont lancés sans évaluation sérieuse de l'**AI Readiness** de l'organisation. Les prérequis en termes de données, compétences, infrastructure et culture ne sont pas vérifiés. Le projet est condamné avant de commencer.
**La pression du marché.** La médiatisation de l'IA — amplifiée par l'IA générative — crée une urgence perçue qui pousse à l'action avant la réflexion. "Nos concurrents utilisent l'IA, il faut qu'on s'y mette" se traduit par des projets lancés trop vite, sur des bases trop fragiles.
### Comment sortir du cycle
Briser l'AI Death Cycle demande un changement de posture fondamental : accepter que les fondations doivent précéder les applications.
**Investir d'abord dans les données.** Avant de lancer un projet IA, s'assurer que les données nécessaires existent, sont documentées, accessibles et de qualité mesurée. Cela implique souvent un investissement dans la **Data Governance**, la **Data Platform** et les compétences de **Data Engineering**.
**Cadrer les attentes.** Distinguer clairement ce qu'un projet IA peut livrer à court terme (une automatisation ciblée, un gain de productivité mesurable) de ce qu'il ne peut pas livrer (une transformation radicale en 3 mois). Les projets qui réussissent sont souvent ceux dont l'ambition initiale est modeste mais réaliste.
**Construire des victoires rapides.** Commencer par des cas d'usage à fort impact et faible complexité technique pour démontrer la valeur de l'IA et reconstruire la confiance interne. Ces premiers succès justifient les investissements structurels qui suivront.
**Mesurer et communiquer.** Mettre en place des indicateurs de succès clairs dès le départ et communiquer les résultats — y compris les apprentissages tirés des échecs. La transparence sur ce qui fonctionne et ce qui ne fonctionne pas est plus efficace que l'optimisme aveugle.
**Développer les compétences.** Former des **AI Champions** dans les équipes métiers, investir dans la **Data Literacy** à tous les niveaux, recruter ou développer les profils techniques nécessaires (**Data Engineers**, **ML Engineers**, **Data Product Managers**).
### L'AI Death Cycle comme outil de diagnostic
Le concept d'AI Death Cycle est utile non seulement pour comprendre les échecs passés, mais aussi comme grille de diagnostic préventif. Si une organisation reconnaît les symptômes — projets qui s'essoufflent, sponsors qui se désengagent, données dont personne ne veut prendre la responsabilité — elle peut identifier à quelle étape du cycle elle se trouve et agir en conséquence.
---
### Qu'est-ce que l'AI Governance ?
Source : https://www.hymaia.com/qu-est-ce-que/ai-governance/
L'AI Governance désigne le cadre organisationnel — politiques, processus, rôles et comités — qui encadre le développement et l'utilisation de l'IA dans une organisation. Elle couvre la gestion des risques, la conformité réglementaire, l'éthique et la transparence des systèmes IA.
L'**AI Governance** (gouvernance de l'IA) est l'ensemble des politiques, processus, structures organisationnelles et mécanismes de contrôle mis en place pour encadrer le développement, le déploiement et l'utilisation des systèmes d'intelligence artificielle au sein d'une organisation. Elle répond à une question simple mais fondamentale : comment s'assurer que l'IA est utilisée de manière responsable, conforme et alignée avec les objectifs de l'entreprise ?
### Pourquoi un cadre de gouvernance spécifique à l'IA ?
La **Data Governance** existe depuis des années pour encadrer la gestion des données. Mais l'IA introduit des problématiques nouvelles qui dépassent le périmètre de la gouvernance des données classique :
- **L'opacité des modèles** : un modèle de deep learning peut prendre des décisions qu'aucun humain n'est capable d'expliquer complètement. Comment gouverner ce qu'on ne comprend pas entièrement ?
- **Les biais algorithmiques** : un modèle entraîné sur des données historiques peut reproduire et amplifier des discriminations existantes.
- **L'autonomie croissante** : avec les agents IA capables d'agir sans supervision humaine directe, la question du contrôle et de la responsabilité se pose avec une acuité nouvelle.
- **La vitesse de déploiement** : l'IA générative permet à n'importe quel collaborateur de créer des contenus, d'analyser des données ou de prendre des décisions assistées par l'IA, souvent sans que l'organisation en ait pleinement conscience.
### Les piliers de l'AI Governance
Un cadre d'AI Governance robuste s'articule typiquement autour de plusieurs piliers :
**Politiques d'usage.** Quels usages de l'IA sont autorisés, encadrés ou interdits ? Quelles données peuvent être partagées avec quels outils ? Ces politiques doivent être suffisamment précises pour guider les comportements au quotidien, mais suffisamment flexibles pour ne pas bloquer l'innovation.
**Classification des risques.** Tous les systèmes IA ne présentent pas le même niveau de risque. Un chatbot de FAQ interne et un algorithme de scoring crédit n'appellent pas les mêmes contrôles. L'AI Governance implique de catégoriser les systèmes selon leur impact potentiel et d'adapter les exigences en conséquence — une approche que l'**AI Act** européen a formalisée avec ses quatre niveaux de risque (minimal, limité, élevé, inacceptable).
**Transparence et explicabilité.** Comment documenter les décisions prises par les systèmes IA ? Comment rendre ces décisions compréhensibles pour les parties prenantes ? Cela inclut la tenue de registres des modèles déployés, la documentation des données d'entraînement et des choix de conception, et la mise en place de mécanismes d'explication adaptés au public (technique, métier, régulateur, utilisateur final).
**Supervision humaine.** Définir à quel moment et de quelle manière un humain doit intervenir dans le processus décisionnel assisté par l'IA. Le principe de "human in the loop" (humain dans la boucle) ou "human on the loop" (humain en supervision) selon le niveau de risque.
**Audit et conformité.** Mettre en place des mécanismes de vérification régulière : les modèles fonctionnent-ils comme prévu ? Les biais sont-ils surveillés ? Les performances restent-elles acceptables ? Le phénomène de **Data Drift** — la dégradation progressive des performances d'un modèle quand les données évoluent — illustre bien la nécessité d'un suivi continu.
### AI Governance et AI Act
L'entrée en application progressive de l'**AI Act** européen (à partir de 2025) rend l'AI Governance non plus optionnelle mais réglementairement nécessaire pour de nombreuses organisations. Le règlement impose notamment :
- L'interdiction de certains usages (scoring social, manipulation subliminale)
- Des obligations renforcées pour les systèmes à haut risque (évaluation de conformité, documentation technique, surveillance post-déploiement)
- Des exigences de transparence pour les systèmes d'IA générative
Les organisations qui ont déjà structuré leur AI Governance seront mieux préparées à répondre à ces exigences. Celles qui ne l'ont pas fait devront accélérer.
### La dimension organisationnelle
L'AI Governance n'est pas qu'une affaire de documents et de procédures. Elle implique des choix organisationnels concrets :
- **Qui décide ?** La création d'un comité d'AI Governance (ou AI Board) rassemblant des représentants métiers, techniques, juridiques et éthiques.
- **Qui exécute ?** L'identification de responsables opérationnels — parfois appelés AI Governance Officers — chargés de faire vivre le cadre au quotidien.
- **Qui contrôle ?** La mise en place d'audits internes ou externes, avec des indicateurs de suivi mesurables.
Cette structuration rappelle celle de la **Data Governance**, dont l'AI Governance est en quelque sorte l'extension naturelle au domaine de l'IA. Les organisations qui disposent déjà d'une gouvernance data mature ont un avantage : elles peuvent étendre leurs structures existantes (comités, rôles, processus) pour couvrir les spécificités de l'IA.
### Le lien avec l'IA Responsable
L'AI Governance et l'**IA Responsable** sont deux concepts complémentaires. L'IA Responsable définit les principes éthiques (équité, transparence, respect de la vie privée, durabilité environnementale). L'AI Governance fournit le cadre opérationnel pour traduire ces principes en pratiques concrètes et vérifiables. Sans gouvernance, l'IA Responsable reste un engagement de façade. Sans principes éthiques, la gouvernance se réduit à de la conformité administrative.
---
### Qu'est-ce que l'AI Ops et quel est son rôle ?
Source : https://www.hymaia.com/qu-est-ce-que/ai-ops/
L'AI Ops désigne l'ensemble des pratiques et le rôle dédié à structurer, accélérer et piloter l'adoption de l'intelligence artificielle à l'échelle d'une organisation.
L'AI Ops est un rôle émergent qui s'inscrit dans la lignée des métiers "Ops" (DevOps, Product Ops, Sales Ops, MLOps), avec pour mission de structurer et accélérer l'adoption de l'IA à l'échelle de l'organisation. Comme le Product Ops optimise la chaîne de valeur Produit, l'AI Ops crée les conditions pour que l'IA soit utilisée de manière pertinente, efficace et responsable dans toute l'entreprise.
### Les cinq responsabilités de l'AI Ops
**1\. Créer un environnement favorable à l'adoption**
L'AI Ops diffuse une culture IA dans l'organisation en standardisant les pratiques, en structurant l'onboarding sur les outils et en fournissant les ressources de formation nécessaires. Ce volet s'apparente au travail d'un programme de data literacy appliqué spécifiquement à l'IA : rendre chaque collaborateur capable d'identifier où l'IA peut l'aider dans son quotidien.
**2\. Mettre en place les process et les outils**
Sélection et recommandation des outils IA adaptés, automatisation des workflows d'intégration, coaching des équipes sur les bonnes pratiques. L'AI Ops ne développe pas les solutions IA — il facilite leur adoption en levant les freins organisationnels et techniques.
**3\. Aligner IA et stratégie d'entreprise**
L'AI Ops assure la cohérence entre les initiatives IA et les objectifs business, pilote les indicateurs de performance et orchestre la communication entre les équipes techniques, le management et les parties prenantes externes. Sans cet alignement, les projets IA restent des expérimentations isolées.
**4\. Mesurer et piloter l'impact**
Monitoring des usages, mesure du ROI des initiatives IA, collecte des retours utilisateurs, identification des opportunités d'optimisation. L'AI Ops installe une boucle de feedback continue qui permet de passer de l'intuition à la décision basée sur des données concrètes.
**5\. Identifier les bons cas d'usage**
C'est peut-être la responsabilité la plus stratégique. L'AI Ops évalue la pertinence des différentes approches selon les besoins : LLM pour le traitement du langage, agents IA pour l'automatisation complexe, ML classique pour l'analyse prédictive, ou parfois simplement une règle métier sans IA du tout. L'AI Ops anime des ateliers d'idéation avec les équipes métier, évalue la faisabilité technique et l'impact business, et oriente vers la solution la plus adaptée.
### L'AI Champion : relais dans les équipes
L'AI Ops s'appuie sur un réseau d'AI Champions — des collaborateurs volontaires qui deviennent les référents IA dans leurs équipes respectives. Ces champions facilitent le partage des bonnes pratiques, remontent les besoins terrain et accélèrent l'adoption par leurs pairs. Ils forment le maillage humain sans lequel aucune transformation IA ne prend racine.
### La clé : des ateliers bien préparés
Un facteur de succès souvent sous-estimé réside dans la qualité de préparation des ateliers d'idéation. Demander aux participants de réfléchir en amont à leurs irritants, préparer des démonstrations concrètes adaptées à leur contexte métier, commencer par le concret plutôt que la théorie : ces détails font la différence entre un atelier qui inspire et un atelier qui transforme les pratiques. La démonstration initiale est le moment où le "l'IA ne peut pas faire ça" se transforme en "explorons les possibilités". Et sans un point de suivi fixé dans la semaine qui suit, même les meilleures idées restent au stade de l'intention.
### AI Ops : un rôle ou une pratique ?
Comme le DevOps n'est pas qu'un poste mais une culture de collaboration entre développement et opérations, l'AI Ops gagne à être vu comme un ensemble de pratiques plutôt que comme un rôle unique. Selon l'organisation, ces pratiques peuvent être portées par les équipes Data, Produit, Ops ou Métier — voire par une approche hybride. L'essentiel est de briser les silos et d'installer une responsabilité partagée dans la transformation IA.
Les qualités clés pour porter ces pratiques : une compréhension des enjeux techniques et business de l'IA, des capacités pédagogiques et de conduite du changement, une approche pragmatique orientée impact, et une vision transverse de l'organisation.
---
### Qu'est-ce qu'un AI Product Manager ?
Source : https://www.hymaia.com/qu-est-ce-que/ai-product-manager/
L'AI Product Manager est un profil qui combine les compétences du product management avec une compréhension approfondie de l'IA et du machine learning. Il pilote la conception de produits intégrant de l'intelligence artificielle en faisant le lien entre les équipes techniques, business et les utilisateurs.
L'**AI Product Manager** est un rôle qui se situe à l'intersection du product management, de la data science et de l'ingénierie IA. Là où un Product Manager classique conçoit des produits numériques en s'appuyant sur des fonctionnalités déterministes (un bouton fait toujours la même chose), l'AI Product Manager doit intégrer des composantes probabilistes : un modèle de machine learning ou un LLM qui peut donner des résultats différents à chaque exécution, avec un taux de fiabilité à gérer plutôt qu'un comportement garanti.
### Un rôle né d'une nécessité
L'émergence de l'AI Product Manager répond à un constat : de nombreux projets IA échouent non pas par manque de compétences techniques, mais par manque de cadrage produit. Un modèle de machine learning performant en laboratoire peut s'avérer inutile en production s'il ne résout pas un vrai problème utilisateur, si l'expérience autour du modèle est mal conçue, ou si les cas limites n'ont pas été anticipés.
Le Data Product Manager, qui existait avant la vague de l'IA générative, se concentrait sur la valorisation des données : data products, dashboards, pipelines analytiques. L'AI Product Manager élargit ce périmètre aux produits qui embarquent des modèles d'IA comme composante centrale de l'expérience.
### Les compétences distinctives
**Compréhension technique de l'IA — sans être data scientist.** L'AI Product Manager n'entraîne pas de modèles, mais il doit comprendre les concepts clés : comment fonctionne un LLM, ce qu'est le fine-tuning, les limites du RAG, les métriques d'évaluation d'un modèle, les compromis entre précision et rappel. Cette compréhension lui permet de dialoguer efficacement avec les équipes techniques et de prendre des décisions de cadrage éclairées.
**Gestion de l'incertitude.** Un produit IA ne garantit pas un résultat déterministe. L'AI Product Manager doit définir des seuils de performance acceptables, concevoir des mécanismes de fallback quand le modèle échoue, et communiquer clairement aux utilisateurs et aux stakeholders que "90 % de fiabilité" ne signifie pas "100 %".
**Design de l'expérience utilisateur autour de l'IA.** Comment présenter les résultats d'un modèle à un utilisateur ? Faut-il afficher un score de confiance ? Comment gérer les hallucinations côté UX ? Comment recueillir du feedback utilisateur pour améliorer le modèle ? Ces questions de design sont spécifiques aux produits IA et relèvent de l'AI Product Manager.
**Éthique et IA responsable.** L'AI Product Manager doit s'assurer que le produit respecte les principes d'IA responsable : biais dans les données et les résultats, transparence sur l'utilisation de l'IA, conformité avec l'AI Act européen, protection des données personnelles. Ces sujets ne sont pas optionnels — ils conditionnent la viabilité légale et la confiance des utilisateurs.
### Le quotidien d'un AI Product Manager
Le travail concret varie selon l'organisation, mais inclut typiquement :
- **Discovery et cadrage.** Identifier les opportunités où l'IA apporte une valeur réelle (pas un gadget), estimer la faisabilité technique avec les data scientists et ML engineers, définir les métriques de succès.
- **Spécification des cas d'usage.** Rédiger des spécifications qui intègrent les particularités de l'IA : données d'entraînement nécessaires, comportement attendu sur les edge cases, métriques de qualité du modèle, stratégie de fallback.
- **Pilotage des itérations.** Les projets IA sont intrinsèquement itératifs. L'AI Product Manager cadre les expérimentations, analyse les résultats d'évaluation avec l'équipe, et décide quand un modèle est prêt pour la production.
- **Go-to-market et adoption.** Communiquer sur les capacités et les limites du produit, former les utilisateurs, recueillir le feedback, piloter l'amélioration continue.
### Où se forment les AI Product Managers ?
Le rôle étant récent, les parcours sont variés. Beaucoup viennent du product management classique et montent en compétence sur l'IA. D'autres viennent de la data science et développent leurs compétences produit. Les formations spécialisées se multiplient pour accélérer cette montée en compétence — elles permettent d'acquérir en quelques jours les fondamentaux techniques et méthodologiques nécessaires pour piloter un produit IA.
### La différence avec un Product Manager "classique"
Un Product Manager peut intégrer de l'IA dans son produit sans devenir AI Product Manager. La différence est une question de centralité : quand l'IA est un composant périphérique (une suggestion, un filtre de spam), les compétences PM classiques suffisent. Quand l'IA est le coeur de la proposition de valeur (un assistant conversationnel, un moteur de recommandation, un outil de génération), les spécificités de l'IA (incertitude, évaluation, boucle de feedback, éthique) deviennent le quotidien — et justifient un rôle dédié.
L'essor de l'IA agentique accentue ce besoin : concevoir un produit où des agents IA agissent de manière autonome exige une compréhension fine des capacités, limites et risques des systèmes agentiques.
---
### Qu'est-ce que l'AI Readiness ?
Source : https://www.hymaia.com/qu-est-ce-que/ai-readiness/
L'AI Readiness (maturité IA) mesure la capacité d'une organisation à adopter et exploiter l'intelligence artificielle de manière effective. Elle évalue la maturité sur plusieurs axes : qualité des données, compétences internes, culture d'entreprise, infrastructure technique et gouvernance.
L'**AI Readiness** — qu'on traduit parfois par "maturité IA" ou "état de préparation à l'IA" — désigne la capacité globale d'une organisation à intégrer l'intelligence artificielle dans ses processus, ses produits et sa prise de décision. Ce n'est pas une métrique unique mais un diagnostic multidimensionnel qui évalue si les fondations nécessaires sont en place pour que les projets IA réussissent.
### Pourquoi évaluer son AI Readiness ?
La majorité des projets IA qui échouent ne butent pas sur la technologie. Ils échouent parce que l'organisation n'était pas prête : données inaccessibles ou de mauvaise qualité, absence de compétences pour maintenir les modèles en production, résistance culturelle, ou manque de sponsoring de la direction.
Ce constat est au cœur du concept d'**AI Death Cycle** : des projets IA lancés sur des fondations fragiles échouent, ce qui renforce le scepticisme interne, réduit les investissements futurs, et dégrade encore davantage les conditions de succès. Évaluer son AI Readiness permet de briser ce cercle vicieux en identifiant les prérequis manquants avant de lancer des projets.
### Les axes d'évaluation
Un diagnostic d'AI Readiness couvre typiquement cinq à sept dimensions. Voici les axes les plus courants :
**Données.** La qualité, l'accessibilité et la gouvernance des données constituent le socle de tout projet IA. Les questions clés : les données sont-elles documentées ? Existe-t-il un catalogue de données ? La qualité est-elle mesurée et suivie ? Les équipes métiers peuvent-elles accéder aux données dont elles ont besoin ? Une **Data Governance** mature est un prérequis direct.
**Compétences.** L'organisation dispose-t-elle des profils nécessaires ? Data scientists, ML engineers, data engineers, mais aussi des profils hybrides comme les **Data Product Managers** ou les **AI Champions** capables de faire le lien entre technique et métier. Au-delà des experts, le niveau de **Data Literacy** de l'ensemble des collaborateurs entre en jeu.
**Infrastructure technique.** La **Data Platform** est-elle capable de supporter des workloads IA ? Cela inclut la capacité de stockage et de calcul, les outils de versioning de données et de modèles, les pipelines d'entraînement et de déploiement, et les pratiques de **MLOps** pour industrialiser le cycle de vie des modèles.
**Culture et organisation.** L'IA est-elle perçue comme un levier stratégique ou comme un gadget technologique ? Le management soutient-il activement les initiatives IA ? Les équipes métiers sont-elles impliquées dans la définition des cas d'usage ? La culture de l'expérimentation est-elle encouragée ? Cette dimension, souvent sous-estimée, est fréquemment le facteur discriminant entre succès et échec.
**Gouvernance et éthique.** L'organisation a-t-elle défini un cadre pour encadrer l'utilisation de l'IA ? Les questions de biais, de transparence, de conformité réglementaire (notamment avec l'**AI Act**) sont-elles traitées ? Une **AI Governance** formalisée est un marqueur de maturité avancée.
**Stratégie et cas d'usage.** Les projets IA sont-ils alignés avec la stratégie business ? Existe-t-il un portefeuille de cas d'usage priorisés selon leur impact et leur faisabilité ? Ou les initiatives IA partent-elles dans toutes les directions sans cohérence ?
### Les niveaux de maturité
La plupart des cadres d'AI Readiness distinguent plusieurs niveaux de maturité, typiquement :
- **Exploration** : l'organisation expérimente l'IA de manière ponctuelle, souvent via des POC (proof of concept) isolés. Pas de stratégie IA formalisée.
- **Expérimentation structurée** : quelques cas d'usage sont identifiés et suivis. Les premières compétences sont en place. Les données commencent à être organisées.
- **Industrialisation** : des modèles sont en production avec des processus de monitoring. Les rôles sont définis. La gouvernance existe.
- **Transformation** : l'IA est intégrée dans les processus métiers à l'échelle. La culture data est ancrée. L'organisation est capable d'itérer rapidement sur de nouveaux cas d'usage.
La plupart des organisations se situent entre les niveaux 1 et 2. L'objectif d'un diagnostic d'AI Readiness n'est pas de viser immédiatement le niveau 4, mais d'identifier les actions concrètes pour progresser d'un niveau au suivant.
### Comment conduire un diagnostic d'AI Readiness
Un diagnostic d'AI Readiness combine généralement :
- **Des entretiens qualitatifs** avec les parties prenantes clés (direction, DSI, métiers, data team) pour comprendre la perception, les attentes et les freins.
- **Un audit des données et de l'infrastructure** pour évaluer objectivement l'état des fondations techniques.
- **Une cartographie des compétences** pour identifier les gaps entre les profils existants et ceux nécessaires.
- **Un benchmark** par rapport au secteur d'activité et à la taille de l'organisation.
Le livrable est une feuille de route priorisée : quels chantiers lancer en premier pour maximiser les chances de succès des projets IA à venir.
### AI Readiness et stratégie d'entreprise
L'AI Readiness n'est pas un exercice technique réservé à la DSI. C'est un diagnostic stratégique qui engage la direction générale. Les organisations les plus matures sur l'IA sont celles où le diagnostic de readiness a été porté au niveau du COMEX, avec des décisions d'investissement sur les données, les compétences et la culture qui en découlent.
---
### Qu'est-ce que l'analyse des erreurs en Machine Learning ?
Source : https://www.hymaia.com/qu-est-ce-que/error-analysis/
L'analyse des erreurs est une methode systematique pour identifier, categoriser et corriger les faiblesses d'un modele de Machine Learning. Elle guide les iterations d'amelioration en ciblant les sous-populations ou le modele echoue le plus.
L''**Analyse des erreurs** est un terme utilisé principalement dans le domaine du machine learning et de l'analyse statistique pour désigner le processus d'identification et d'analyse des causes des erreurs dans les modèles de prédictions. Ce processus est essentiel pour améliorer la précision et la performance des modèles en permettant aux développeurs et aux analystes de comprendre où et pourquoi les erreurs se produisent.
L'analyse des erreurs implique généralement l'examen des cas où les prédictions du modèle divergent significativement des résultats attendus ou corrects. Elle aide à identifier les faiblesses du modèle, telles que les biais dans les données, les insuffisances des features sélectionnées, ou les limitations des algorithmes utilisés. Cette démarche est cruciale pour l'itération des modèles, guidant les ajustements nécessaires pour améliorer leur fiabilité et leur applicabilité dans des scénarios réels.
---
### Qu'est-ce qu'un Analytics Engineer ?
Source : https://www.hymaia.com/qu-est-ce-que/analytics-engineer/
L'Analytics Engineer applique les bonnes pratiques du Software Engineering (tests, CI/CD, versioning) à la transformation des données, comblant le fossé entre Data Engineer et Data Analyst.
L'Analytics Engineer est un profil hybride qui se situe à l'intersection du Data Engineer et du Data Analyst. Sa mission : appliquer les principes du génie logiciel à la transformation et à la modélisation des données, pour que les équipes métier accèdent plus vite à des données fiables et exploitables. En d'autres termes, l'Analytics Engineer accélère le "Time to Insight" — le temps entre la question business et la réponse data.
### Un rôle né d'un besoin concret
Historiquement, les Data Engineers construisent les pipelines d'ingestion et les infrastructures de stockage, tandis que les Data Analysts explorent les données et produisent des analyses. Entre les deux, un vide : la transformation des données brutes en modèles analytiques propres, testés et documentés. C'est ce vide que l'Analytics Engineer comble.
Le terme a été popularisé par dbt Labs (anciennement Fishtown Analytics) avec la création de l'outil dbt (data build tool) au milieu des années 2010. L'idée fondatrice : le SQL, langage que tout analyste maîtrise, peut devenir aussi rigoureux que du code applicatif si on lui applique les bonnes pratiques du Software Engineering.
### Ce que fait concrètement un Analytics Engineer
**Modélisation des données** — L'Analytics Engineer conçoit les modèles de données qui alimentent les tableaux de bord et les analyses. Il structure les données en couches (staging, intermediate, marts) selon des conventions claires, en s'assurant que chaque transformation est compréhensible et maintenable.
**Tests et validation** — Chaque modèle est accompagné de tests automatisés : tests de non-nullité, d'unicité, d'intégrité référentielle, et tests personnalisés sur les règles métier. Ces tests s'exécutent à chaque modification, garantissant que les données en sortie restent fiables dans le temps.
**CI/CD et versioning** — Le code de transformation est versionné dans Git, revu par les pairs via des pull requests, et déployé automatiquement via des pipelines CI/CD. Ce workflow, directement emprunté au développement logiciel, élimine les transformations ad hoc et les "fichiers Excel qui traînent".
**Documentation** — L'Analytics Engineer documente chaque modèle, chaque champ, chaque transformation. Cette documentation est générée automatiquement à partir du code (un avantage majeur de dbt), ce qui assure qu'elle reste à jour. C'est une contribution directe à la data governance de l'organisation.
### L'écosystème d'outils
L'outil de référence du métier est dbt, qui permet d'écrire des transformations SQL modulaires avec tests, documentation et gestion des dépendances intégrés. L'Analytics Engineer travaille sur une data platform moderne — souvent un data warehouse cloud (BigQuery, Snowflake, Redshift) — et s'inscrit dans l'écosystème du Modern Data Stack qui sépare clairement ingestion, stockage, transformation et visualisation.
### Différences avec les rôles voisins
Par rapport au Data Engineer, l'Analytics Engineer se concentre sur la couche de transformation et de modélisation plutôt que sur l'infrastructure et l'ingestion. Il travaille principalement en SQL (là où le Data Engineer utilise Python, Spark et des outils d'orchestration) et son output principal est un modèle de données, pas un pipeline d'ingestion.
Par rapport au Data Analyst, l'Analytics Engineer se focalise sur la construction des fondations analytiques plutôt que sur l'analyse elle-même. Il crée les datasets que le Data Analyst exploitera ensuite pour produire des insights, des rapports et du data storytelling. L'Analytics Engineer rend le Data Analyst plus efficace en lui fournissant des données propres, testées et documentées.
### Compétences clés
L'Analytics Engineer maîtrise le SQL avancé (window functions, CTEs, modélisation dimensionnelle), Git et les workflows de développement collaboratif, les principes de modélisation de données (Star Schema, Data Vault), et bien sûr dbt. Une compréhension du domaine métier est aussi indispensable : sans elle, impossible de modéliser les données de façon pertinente.
---
### Qu'est-ce que l'architecture Transformer ?
Source : https://www.hymaia.com/qu-est-ce-que/architecture-transformer/
L'architecture Transformer est un type de réseau de neurones basé sur le mécanisme d'attention, introduit par Google en 2017. Elle constitue le fondement technique de tous les grands modèles de langage actuels (GPT, Claude, Llama, Mistral) et a transformé le traitement du langage naturel.
L'**architecture Transformer** est un modèle de réseau de neurones conçu pour traiter des séquences de données (texte, code, images) en s'appuyant sur un mécanisme appelé **attention**. Présentée dans le papier "Attention Is All You Need" publié par des chercheurs de Google en juin 2017, cette architecture a remplacé les approches précédentes (réseaux récurrents, LSTM) et sert de fondation à la quasi-totalité des LLMs actuels.
### Le mécanisme d'attention
Le coeur du Transformer est le mécanisme de **self-attention** (auto-attention). Pour chaque mot (ou plus précisément chaque token) d'une séquence, le modèle calcule un score d'attention avec tous les autres tokens de la séquence. Ce score détermine à quel point chaque token doit "faire attention" aux autres pour comprendre le contexte.
Exemple concret : dans la phrase "Le chat qui était sur le toit a sauté", quand le modèle traite le mot "a sauté", le mécanisme d'attention lui permet d'identifier que le sujet est "chat" (et non "toit"), même si plusieurs mots les séparent. Les architectures précédentes (RNN, LSTM) traitaient les tokens séquentiellement et perdaient cette information sur les longues distances.
Le Transformer utilise une variante appelée **multi-head attention** : plutôt qu'un seul calcul d'attention, le modèle effectue plusieurs calculs en parallèle (les "têtes"), chacun capturant un type de relation différent (syntaxique, sémantique, positionnelle). Les résultats sont ensuite combinés.
### Architecture encodeur-décodeur
Le Transformer original comprend deux parties :
**L'encodeur.** Il prend une séquence en entrée et produit une représentation numérique riche de chaque token, enrichie par le contexte de tous les autres tokens. BERT (Google, 2018) utilise uniquement un encodeur — il excelle en compréhension de texte (classification, extraction d'entités).
**Le décodeur.** Il génère une séquence de sortie token par token, en utilisant à la fois l'attention sur les tokens déjà générés et (optionnellement) l'attention sur la sortie de l'encodeur. Les modèles GPT d'OpenAI utilisent uniquement un décodeur — ils excellent en génération de texte.
Les LLMs modernes (GPT-4, Claude, Llama, Mistral) sont tous des modèles "decoder-only" : ils fonctionnent uniquement avec la partie décodeur, entraînée à prédire le token suivant dans une séquence. Cette approche, plus simple architecturalement, s'est révélée étonnamment puissante quand on augmente la taille du modèle et des données d'entraînement.
### Pourquoi le Transformer a tout changé
**Parallélisation.** Contrairement aux réseaux récurrents qui traitent les tokens un par un (séquentiellement), le Transformer traite tous les tokens d'une séquence simultanément lors de l'entraînement. Cela permet d'exploiter massivement les GPU modernes et d'entraîner des modèles sur des corpus gigantesques en un temps raisonnable.
**Scalabilité.** L'architecture se comporte remarquablement bien quand on augmente sa taille (nombre de paramètres), la quantité de données d'entraînement et la puissance de calcul. Cette propriété, formalisée sous le nom de "lois d'échelle" (scaling laws) par les chercheurs d'OpenAI en 2020, est la raison pour laquelle les modèles sont passés de millions à des centaines de milliards de paramètres.
**Gestion du contexte long.** Le mécanisme d'attention permet théoriquement à chaque token de "voir" tous les autres tokens de la séquence, quel que soit leur distance. C'est ce qui permet les fenêtres de contexte larges (128K tokens pour GPT-4, 200K pour Claude) et rend possible le RAG et d'autres techniques d'augmentation contextuelle.
### Les composants techniques
Au-delà de l'attention, le Transformer comprend plusieurs mécanismes :
- **Embeddings positionnels** : le modèle n'a pas de notion naturelle d'ordre des mots (contrairement aux RNN). Des vecteurs de position sont ajoutés aux embeddings de chaque token pour encoder sa place dans la séquence.
- **Feed-forward networks** : après chaque couche d'attention, un réseau de neurones classique traite chaque token indépendamment, ajoutant de la capacité de représentation.
- **Layer normalization** : une technique de stabilisation qui permet d'empiler de nombreuses couches (GPT-4 en compterait plus de 100) sans que l'entraînement diverge.
- **Tokenization** : le texte brut est d'abord découpé en tokens par un tokenizer (BPE, SentencePiece) avant d'être traité par le Transformer.
### Variantes et évolutions
L'architecture originale de 2017 a donné naissance à de nombreuses variantes :
- **Sparse attention** : au lieu de calculer l'attention entre tous les tokens (coût quadratique), seul un sous-ensemble de paires est considéré, réduisant le coût computationnel.
- **Flash Attention** : optimisation de l'implémentation du calcul d'attention pour mieux utiliser la hiérarchie mémoire des GPU, développée par Tri Dao à Stanford.
- **Mixture of Experts (MoE)** : plutôt qu'un seul réseau feed-forward, plusieurs "experts" spécialisés sont disponibles et un routeur sélectionne les plus pertinents pour chaque token. Mistral (avec Mixtral) et vraisemblablement GPT-4 utilisent cette approche.
### Au-delà du texte
L'architecture Transformer s'est étendue bien au-delà du traitement du langage naturel. Vision Transformers (ViT) l'appliquent aux images, DALL-E et Stable Diffusion l'utilisent pour la génération d'images, et les modèles multimodaux (GPT-4o, Gemini) traitent texte, images et audio dans une architecture Transformer unifiée.
---
### Qu'est-ce qu'AWS (Amazon Web Services) ?
Source : https://www.hymaia.com/qu-est-ce-que/aws/
AWS (Amazon Web Services) est la plateforme de cloud computing d'Amazon, leader mondial du marché avec plus de 200 services couvrant le calcul, le stockage, les bases de données, l'IA et le machine learning.
AWS (Amazon Web Services) est la division cloud d'Amazon et le leader mondial du cloud computing avec environ 31 % de parts de marché en 2024, devant Microsoft Azure (25 %) et Google Cloud Platform (11 %). Lancée en 2006 avec deux services (S3 pour le stockage et EC2 pour le calcul), la plateforme propose aujourd'hui plus de 200 services managés couvrant l'ensemble des besoins informatiques des entreprises.
### Les services fondamentaux
L'offre AWS s'organise autour de plusieurs catégories de services :
**Calcul** — EC2 (machines virtuelles), Lambda (serverless), ECS/EKS (conteneurs). Ces services permettent d'exécuter n'importe quelle charge de travail, du simple script au cluster de calcul haute performance.
**Stockage** — S3 (stockage objet, devenu un standard de fait), EBS (disques attachés aux instances), Glacier (archivage longue durée). S3 à lui seul stocke des trillions d'objets pour des millions de clients.
**Bases de données** — RDS (bases relationnelles managées : PostgreSQL, MySQL), DynamoDB (NoSQL), Redshift (data warehouse). Chaque type de donnée a un service optimisé.
**Réseau** — VPC (réseaux privés virtuels), CloudFront (CDN), Route 53 (DNS). L'infrastructure réseau d'AWS couvre 34 régions géographiques et plus de 100 zones de disponibilité à travers le monde.
### AWS pour la data et l'IA
AWS propose un écosystème complet pour les cas d'usage data et IA, ce qui en fait un pilier des data platforms modernes :
**Data engineering** — Glue (ETL serverless), EMR (clusters Spark managés), Kinesis (streaming temps réel), Athena (requêtage SQL sur S3). Ces services permettent de construire des pipelines de données à grande échelle sans gérer l'infrastructure sous-jacente.
**Machine learning** — SageMaker est la plateforme ML intégrée d'AWS, couvrant la préparation des données, l'entraînement, le déploiement et le monitoring des modèles. SageMaker s'intègre avec les pratiques MLOps pour industrialiser le cycle de vie des modèles.
**IA générative** — Amazon Bedrock donne accès à des LLM de plusieurs fournisseurs (Anthropic Claude, Meta Llama, Mistral, Amazon Titan) via une API unifiée, avec des fonctionnalités de RAG (Retrieval-Augmented Generation) et de fine-tuning intégrées.
### Le modèle économique
AWS fonctionne sur un modèle de paiement à l'usage (pay-as-you-go) : les entreprises ne paient que pour les ressources consommées, sans investissement initial en infrastructure. Ce modèle a transformé l'économie de l'informatique en remplaçant les dépenses d'investissement (CAPEX) par des dépenses opérationnelles (OPEX), rendant possible pour une startup de disposer de la même puissance de calcul qu'une grande entreprise.
Des options de réservation (Reserved Instances, Savings Plans) permettent de réduire les coûts de 30 à 70 % pour les charges de travail prévisibles. La contrepartie : sans gouvernance rigoureuse, les coûts cloud peuvent rapidement devenir difficiles à maîtriser — le FinOps (gestion financière du cloud) est devenu une discipline à part entière.
### Certifications AWS
AWS propose un programme de certifications structuré en quatre niveaux : Cloud Practitioner (fondamentaux), Associate (architecte, développeur, SysOps), Professional (architecte, DevOps) et Specialty (data analytics, machine learning, sécurité). Ces certifications sont reconnues dans l'industrie et valident des compétences pratiques sur la plateforme.
### AWS dans l'écosystème cloud
Face à Azure et GCP, AWS se distingue par la profondeur de son catalogue de services, la maturité de son écosystème (documentation, communauté, partenaires) et son avance historique. Azure est souvent privilégié dans les environnements Microsoft, GCP pour ses capacités en data analytics (BigQuery) et en IA. Le choix dépend du contexte technique, des compétences disponibles et de la stratégie cloud de l'entreprise.
---
### Qu'est-ce qu'une base de données vectorielle ?
Source : https://www.hymaia.com/qu-est-ce-que/base-de-donnees-vectorielle/
Une base de données vectorielle est un système de stockage optimisé pour indexer et rechercher des vecteurs d'embeddings. Elle permet la recherche sémantique en trouvant les éléments les plus proches dans un espace mathématique, et constitue une brique fondamentale des architectures RAG.
Une **base de données vectorielle** (vector database) est un système de gestion de données conçu pour stocker, indexer et interroger des vecteurs de haute dimension. Contrairement aux bases relationnelles qui comparent des valeurs exactes, une base vectorielle recherche les éléments les plus _similaires_ à une requête donnée, en mesurant la proximité entre vecteurs dans un espace mathématique.
### Comment fonctionnent les vecteurs
Pour comprendre les bases vectorielles, il faut d'abord saisir la notion d'embedding. Un modèle d'embedding transforme un texte, une image ou toute donnée en un vecteur -- une liste de nombres (par exemple, 1 536 dimensions pour le modèle text-embedding-ada-002 d'OpenAI). Deux contenus sémantiquement proches produisent des vecteurs proches dans cet espace.
Par exemple, les phrases "comment cuire des pâtes" et "recette de spaghetti" sont éloignées en termes de mots-clés, mais proches en termes de sens. Leurs embeddings seront donc voisins dans l'espace vectoriel, ce que les bases classiques à mots-clés ne peuvent pas capturer.
### L'indexation : le défi technique
Chercher le vecteur le plus proche parmi des millions de vecteurs en 1 536 dimensions serait extrêmement lent avec une comparaison exhaustive. Les bases vectorielles utilisent des algorithmes d'indexation approximative pour accélérer la recherche :
- **HNSW (Hierarchical Navigable Small World)** : construit un graphe multicouche pour naviguer rapidement vers les voisins les plus proches. C'est l'algorithme le plus répandu.
- **IVF (Inverted File Index)** : partitionne l'espace en clusters et ne cherche que dans les clusters les plus proches de la requête.
- **Product Quantization** : compresse les vecteurs pour réduire l'empreinte mémoire tout en maintenant une bonne précision.
Ces techniques permettent de passer de recherches en O(n) à des recherches quasi-instantanées, même sur des millions de documents.
### Les bases vectorielles disponibles
Le marché des bases vectorielles s'est structuré autour de plusieurs catégories :
**Bases vectorielles natives** : construites spécifiquement pour les vecteurs.
- Pinecone : service managé (cloud), facile à démarrer, sans gestion d'infrastructure.
- Weaviate : open source, supporte le stockage hybride (vecteurs + données structurées).
- Qdrant : open source, écrit en Rust, performant pour les volumes importants.
- Chroma : open source, léger, souvent utilisé pour le prototypage rapide.
- Milvus : open source, conçu pour les déploiements à grande échelle.
**Extensions vectorielles sur bases existantes** : ajoutent des capacités vectorielles à des bases traditionnelles.
- pgvector : extension PostgreSQL, pratique quand on veut garder une seule base de données.
- Elasticsearch kNN : ajout de la recherche vectorielle au moteur de recherche.
Le choix dépend du volume, de la latence cible, des contraintes d'hébergement et de la maturité de l'équipe. Pour un prototype, Chroma ou pgvector suffisent. Pour de la production à grande échelle, Pinecone, Qdrant ou Weaviate offrent des garanties plus robustes.
### Le rôle dans le RAG
Les bases vectorielles sont la brique centrale des architectures RAG (Retrieval-Augmented Generation). Le flux typique est le suivant :
1\. **Ingestion** : les documents sont découpés en segments (chunks), transformés en embeddings, puis indexés dans la base vectorielle.
2\. **Requête** : la question de l'utilisateur est transformée en embedding, puis la base retourne les k segments les plus similaires.
3\. **Génération** : ces segments sont injectés dans le contexte du LLM, qui génère une réponse fondée sur ces informations.
Cette architecture permet au LLM de répondre sur des données qu'il n'a jamais vues pendant son entraînement, sans nécessiter de fine-tuning. C'est le pilier du context engineering appliqué à la récupération d'informations.
### Recherche hybride
La recherche purement vectorielle a ses limites. Pour un identifiant produit, un nom propre ou un code précis, la recherche par mots-clés reste plus efficace. Les bases vectorielles modernes proposent donc la **recherche hybride**, qui combine recherche sémantique (vecteurs) et recherche lexicale (BM25, mots-clés) puis fusionne les résultats.
Cette approche hybride améliore significativement la qualité des résultats dans les systèmes RAG en production, et fait partie des bonnes pratiques recommandées en context engineering.
### Au-delà du texte
Bien que les cas d'usage texte dominent, les bases vectorielles fonctionnent avec tout type d'embedding : images (CLIP), audio, code source. Elles constituent ainsi l'infrastructure de base pour toute application d'IA multimodale qui nécessite de la recherche par similarité.
---
### Qu'est-ce que Caveman en Agentic Coding ?
Source : https://www.hymaia.com/qu-est-ce-que/caveman/
Caveman est un utilitaire qui réduit la verbosité des réponses de Claude Code en le poussant à s'exprimer de façon terne et simpliste, à la manière d'un homme des cavernes. Là où RTK réduit les tokens en entrée, Caveman s'attaque aux tokens en sortie, sans toucher au raisonnement interne du modèle.
**Caveman** est un utilitaire d'Agentic Coding qui s'attaque à la consommation de tokens en sortie de Claude Code. Là où RTK réduit les tokens qui entrent dans le contexte, Caveman agit sur le versant opposé : les tokens que le modèle produit dans sa réponse.
### Le constat de départ
Claude Code peut se montrer très verbeux dans l'expression de ses réponses. Cette verbosité a un coût direct, puisque les tokens en sortie sont généralement les plus chers dans la facturation d'un LLM.
### Comment Caveman fonctionne
La solution retenue par Caveman est simple : rappeler à Claude Code de s'exprimer de façon terne et simpliste, presque comme un homme des cavernes -- d'où son nom. Le style de réponse est délibérément appauvri pour ne garder que l'essentiel.
Un point important pour la qualité du résultat : cette réduction ne touche pas le raisonnement interne du modèle (le thinking), seulement l'output visible par l'utilisateur. Le modèle continue de réfléchir normalement, seule la formulation de sa réponse finale est comprimée.
### Ce qu'on observe à l'usage
Dans l'ensemble, Caveman se montre plutôt efficace pour réduire la production de tokens. On observe cependant quelques pertes de qualité ponctuelles, notamment quand on demande à Claude de produire un contenu textuel travaillé -- de la documentation ou une présentation HTML, par exemple. Ce n'est pas systématique, mais Caveman peut dans ces cas-là dégrader la qualité du texte produit, puisque l'exigence de concision entre en tension avec un contenu qui a justement besoin de développement.
---
### Qu'est-ce que ChatGPT et comment fonctionne-t-il ?
Source : https://www.hymaia.com/qu-est-ce-que/chatgpt/
ChatGPT est l'application d'IA conversationnelle développée par OpenAI, basée sur les modèles GPT. Son lancement fin 2022 a déclenché l'adoption massive de l'IA générative dans le grand public et en entreprise.
ChatGPT est une application d'intelligence artificielle conversationnelle développée par OpenAI, qui permet d'interagir en langage naturel avec un LLM (Large Language Model) de la famille GPT (Generative Pre-trained Transformer). Lancé le 30 novembre 2022, ChatGPT a atteint 100 millions d'utilisateurs en deux mois — un record absolu pour une application grand public, dépassant TikTok (9 mois) et Instagram (2,5 ans).
### L'évolution des modèles GPT
ChatGPT a connu plusieurs générations de modèles, chacune marquant un saut de capacités :
**GPT-3.5** (novembre 2022) — Le modèle de lancement. Capable de conversations cohérentes, de rédaction, de résumé et de traduction, il a surpris par sa fluidité malgré des erreurs factuelles fréquentes. C'est ce modèle qui a provoqué le "moment ChatGPT" et mis l'IA générative à la portée de tous.
**GPT-4** (mars 2023) — Un saut qualitatif majeur : meilleure compréhension des nuances, capacité de raisonnement renforcée, gestion d'instructions complexes. GPT-4 a aussi introduit la multimodalité avec la capacité d'analyser des images en entrée.
**GPT-4o** (mai 2024) — Le "o" signifie "omni". Ce modèle traite nativement texte, images et audio dans une architecture unifiée, avec des temps de réponse réduits. Il a rendu les capacités avancées accessibles aux utilisateurs gratuits.
**o1 et o3** (2024-2025) — Les modèles de raisonnement d'OpenAI, conçus pour résoudre des problèmes complexes en "réfléchissant" étape par étape avant de répondre. Particulièrement performants en mathématiques, code et raisonnement logique.
### Comment fonctionne ChatGPT
ChatGPT repose sur un LLM entraîné en deux phases. D'abord, un pré-entraînement sur un corpus massif de textes (livres, sites web, articles) permet au modèle d'acquérir des connaissances linguistiques et factuelles. Ensuite, un fine-tuning par apprentissage par renforcement à partir de feedback humain (RLHF) aligne les réponses sur les attentes des utilisateurs : être utile, honnête et inoffensif.
L'architecture sous-jacente est le Transformer, introduit par Google en 2017. Ce mécanisme d'attention permet au modèle de pondérer l'importance de chaque mot par rapport aux autres dans une phrase, capturant le contexte avec une efficacité sans précédent.
### Impact sur l'adoption de l'IA
ChatGPT a provoqué un basculement culturel. Avant novembre 2022, l'IA était un sujet de spécialistes ; après, elle est devenue un outil du quotidien. Cet effet a été amplifié par la course à l'armement entre acteurs : Google (Gemini), Anthropic (Claude), Meta (Llama), Mistral, et bien d'autres ont lancé des modèles concurrents, accélérant le rythme d'innovation.
En entreprise, ChatGPT a déclenché une vague d'expérimentation — parfois incontrôlée. Le phénomène du shadow AI (utilisation d'outils IA non approuvés par la DSI) a poussé les organisations à structurer leur approche via des stratégies d'adoption IA, des programmes de data literacy et des politiques de gouvernance adaptées.
### Limites et précautions
ChatGPT partage les limites inhérentes aux LLM. Les hallucinations — réponses plausibles mais factuellement fausses — restent un problème fondamental. Le modèle ne "sait" pas ce qu'il sait : il génère du texte statistiquement probable, ce qui peut produire des affirmations incorrectes formulées avec assurance.
Autres limites à connaître : une date de coupure des connaissances (le modèle n'a pas accès aux événements récents sauf via la recherche web), des biais hérités des données d'entraînement, et une sensibilité au prompt engineering — la façon de formuler la question influence significativement la qualité de la réponse.
Pour un usage professionnel fiable, les approches de RAG (Retrieval-Augmented Generation) permettent d'ancrer les réponses dans des données vérifiées, tandis que les guardrails IA limitent les comportements non souhaités.
### ChatGPT en entreprise
OpenAI propose ChatGPT Enterprise et ChatGPT Team, des versions avec des garanties de confidentialité (les conversations ne sont pas utilisées pour l'entraînement), des contrôles d'administration et des limites d'usage étendues. Ces offres répondent aux exigences de sécurité et de conformité des organisations, notamment dans le contexte de l'AI Act.
---
### Qu'est-ce qu'un Citizen Data Scientist ?
Source : https://www.hymaia.com/qu-est-ce-que/citizen-data-scientist/
Un Citizen Data Scientist est un professionnel métier capable d'utiliser des techniques d'analyse de données et de machine learning grâce à des outils no-code/low-code, sans formation spécialisée en data science.
Le Citizen Data Scientist est un collaborateur dont le métier principal n'est pas la data science, mais qui est capable d'exploiter des techniques analytiques avancées — statistiques, modélisation prédictive, voire machine learning — pour répondre à des problématiques business concrètes. Le terme a été popularisé par Gartner au milieu des années 2010 pour décrire cette montée en compétence des profils métier rendue possible par la démocratisation des outils d'analyse.
### Ce qui distingue le Citizen Data Scientist
Le Citizen Data Scientist n'est pas un Data Analyst avec un nouveau titre. Le Data Analyst a une formation dédiée à l'analyse de données et en fait son activité principale. Le Citizen Data Scientist, lui, est avant tout un expert de son domaine métier (finance, marketing, RH, supply chain) qui utilise la data comme un levier complémentaire pour améliorer ses décisions et ses processus.
Cette ancrage métier est sa force principale : il connaît intimement les problèmes à résoudre, les contraintes opérationnelles et le contexte dans lequel les résultats seront utilisés. Un Data Scientist professionnel produit souvent des modèles techniquement performants mais déconnectés de la réalité terrain — le Citizen Data Scientist fait le chemin inverse, partant du besoin métier pour chercher la solution data la plus simple qui fonctionne.
### Les outils de la démocratisation
L'essor du Citizen Data Scientist est directement lié à l'apparition d'outils no-code et low-code qui rendent l'analyse avancée accessible sans écrire une ligne de Python :
**Plateformes d'AutoML** — Des outils comme Dataiku, DataRobot ou H2O permettent de construire des modèles prédictifs via des interfaces visuelles. L'utilisateur charge ses données, sélectionne une variable cible, et la plateforme teste automatiquement plusieurs algorithmes pour recommander le meilleur modèle.
**BI avancée** — Les outils de business intelligence modernes (Power BI, Tableau, Looker) intègrent des fonctionnalités d'analyse prédictive et de clustering directement dans l'interface de visualisation.
**IA générative comme accélérateur** — Avec l'arrivée des LLM et d'outils comme ChatGPT, les Citizen Data Scientists peuvent désormais écrire du code Python ou SQL en langage naturel, analyser des jeux de données complexes et obtenir des interprétations statistiques sans maîtriser les langages de programmation. Ce changement a considérablement élargi le champ des possibles.
### Le rôle dans la stratégie data de l'entreprise
Les Citizen Data Scientists sont un levier de data literacy à l'échelle de l'organisation. Ils démontrent par l'exemple que la data n'est pas réservée aux équipes techniques, et ils créent un effet d'entraînement dans leurs équipes. Leur existence réduit la pression sur les équipes Data Science centrales, souvent sous-dimensionnées face au volume de demandes.
Dans une approche de Data Mesh, les Citizen Data Scientists peuvent devenir les porteurs de data products au sein de leurs domaines métier, en prenant la responsabilité de la qualité et de l'exploitation des données de leur périmètre.
### Risques et encadrement nécessaire
La démocratisation de la data science comporte des risques réels qu'il faut anticiper :
**Qualité des analyses** — Sans formation aux biais statistiques, un Citizen Data Scientist peut produire des analyses techniquement correctes mais méthodologiquement fausses (surapprentissage, biais de sélection, corrélations prises pour des causalités). Un cadre de validation par des experts reste indispensable pour les analyses à fort impact.
**Gouvernance des données** — L'accès élargi aux données nécessite des règles claires sur ce qui peut être utilisé, par qui et dans quel contexte. C'est un enjeu direct de data governance.
**Shadow analytics** — Comme le shadow AI pour les outils d'IA, les analyses non encadrées peuvent produire des résultats contradictoires entre équipes, créant de la confusion plutôt que de la clarté.
Le meilleur cadre combine autonomie pour les analyses exploratoires et quotidiennes, avec une validation par les équipes Data Science pour les décisions à fort enjeu ou les modèles mis en production.
---
### Qu'est-ce que le Claude Agent SDK ?
Source : https://www.hymaia.com/qu-est-ce-que/claude-agent-sdk/
Le Claude Agent SDK fournit les primitives pour construire sa propre version personnalisée de Claude Code ou ajouter un comportement agentique à une application IA : créer des agents, surcharger les prompts, ajouter de nouveaux outils. Il repose sur le même cœur que Claude Code, avec accès aux skills, aux workflows dynamiques et plus encore.
Le **Claude Agent SDK** donne les primitives nécessaires pour construire sa propre version personnalisée de Claude Code, ou pour ajouter un comportement agentique à une application IA existante. Concrètement, il permet de créer ses propres agents, de surcharger les prompts et d'ajouter de nouveaux outils.
### Le même cœur que Claude Code
L'intérêt principal du Claude Agent SDK est de reposer sur le même moteur que Claude Code. Toutes les fonctionnalités qui font le cœur de Claude Code restent disponibles : les skills, les workflows dynamiques, et plus largement l'ensemble des mécanismes d'orchestration agentique. On ne repart pas de zéro pour construire un comportement agentique : on part du même socle, en le personnalisant.
### Une configuration minimale
Le Claude Agent SDK est particulièrement simple à mettre en route. Il suffit d'avoir Claude Code installé pour être prêt à l'utiliser : la clé API et le compte Anthropic sont déjà configurés et branchés, sans étape de configuration supplémentaire.
### Un usage qui dépasse le mode interactif
Le Claude Agent SDK ne se limite pas à une utilisation interactive. Il peut être configuré avec un prompt statique et utilisé directement au sein d'un CLI, ce qui le rend adapté à des scénarios où l'agent doit s'exécuter de façon autonome, sans échange conversationnel avec un utilisateur.
---
### Qu'est-ce que le Cloud Computing ?
Source : https://www.hymaia.com/qu-est-ce-que/cloud/
Le Cloud Computing permet d'accéder à des ressources informatiques (serveurs, stockage, bases de données, IA) via Internet, sans posséder ni gérer l'infrastructure physique sous-jacente.
Le Cloud Computing est un modèle de mise à disposition de ressources informatiques — puissance de calcul, stockage, bases de données, réseau, logiciels — via Internet, à la demande et avec un paiement à l'usage. Au lieu d'acheter et de gérer des serveurs physiques dans un datacenter, les entreprises louent ces ressources auprès de fournisseurs cloud qui se chargent de l'infrastructure, de la maintenance et de la sécurité.
### Les trois modèles de service
Le cloud se décline en trois modèles de service, chacun offrant un niveau d'abstraction croissant :
**IaaS (Infrastructure as a Service)** — Le fournisseur met à disposition l'infrastructure brute : serveurs virtuels, stockage, réseau. L'entreprise garde le contrôle sur le système d'exploitation, les middlewares et les applications. Exemple : une machine virtuelle EC2 sur AWS ou une VM sur Azure. C'est le modèle le plus flexible mais aussi celui qui demande le plus de compétences techniques.
**PaaS (Platform as a Service)** — Le fournisseur gère l'infrastructure et la plateforme d'exécution. L'entreprise se concentre sur le développement et le déploiement de ses applications, sans se soucier des mises à jour de l'OS ou du dimensionnement des serveurs. Exemples : Google App Engine, Azure App Service, Heroku.
**SaaS (Software as a Service)** — L'application est entièrement gérée par le fournisseur et accessible via un navigateur web. L'entreprise utilise le logiciel sans rien gérer de l'infrastructure. Exemples : Google Workspace, Salesforce, Slack, Notion. C'est le modèle le plus répandu : la plupart des entreprises utilisent du SaaS quotidiennement sans même le considérer comme du "cloud".
### Les trois principaux fournisseurs
Le marché du cloud public est dominé par trois hyperscalers qui concentrent plus de 65 % des parts de marché :
**AWS (Amazon Web Services)** — Leader historique avec environ 31 % de parts de marché en 2024. Le catalogue de services le plus étendu (200+), une communauté massive et une avance en maturité. Choix fréquent des startups et des entreprises tech-first.
**Microsoft Azure** — Deuxième acteur (environ 25 %). Privilégié dans les environnements Microsoft (Active Directory, Office 365, .NET) et les grandes entreprises déjà clientes de l'écosystème Microsoft. Fort en IA grâce au partenariat avec OpenAI.
**Google Cloud Platform (GCP)** — Troisième (environ 11 %). Reconnu pour l'excellence de ses services data et analytics (BigQuery est une référence en data warehousing), ses capacités en IA/ML (Vertex AI) et son expertise en Kubernetes (créé par Google).
### Le cloud comme fondation des data platforms
Le cloud a transformé la façon dont les entreprises construisent leurs data platforms. Avant le cloud, monter une infrastructure data nécessitait des mois et des investissements lourds. Aujourd'hui, une équipe peut provisionner un data warehouse, des pipelines de données et des outils de machine learning en quelques heures.
Les services managés cloud permettent de déployer des clusters Spark sans gérer les serveurs (EMR sur AWS, Dataproc sur GCP), d'entraîner des modèles de ML à grande échelle (SageMaker, Vertex AI), de stocker des données à coût réduit dans des data lakes (S3, GCS), et d'exécuter des workflows MLOps complets sans infrastructure dédiée.
Le Modern Data Stack repose entièrement sur le cloud : des outils comme Snowflake, Databricks, dbt Cloud et Fivetran fonctionnent en SaaS ou PaaS, permettant aux équipes data de se concentrer sur la valeur métier plutôt que sur l'infrastructure.
### Cloud souverain et enjeux de conformité
La localisation des données est un enjeu de plus en plus sensible, notamment en Europe avec le RGPD et les exigences de souveraineté numérique. Les trois hyperscalers américains sont soumis au CLOUD Act, qui permet aux autorités américaines d'accéder aux données stockées par des entreprises américaines, même si les serveurs sont en Europe.
En réponse, des initiatives de cloud souverain émergent : S3NS (Thales + Google), Bleu (Orange/Capgemini + Microsoft), et des acteurs européens comme OVHcloud et Scaleway. L'enjeu d'IA souveraine est directement lié : entraîner et déployer des modèles d'IA sur des infrastructures non soumises à des juridictions extra-européennes.
### Le FinOps : maîtriser les coûts
Le passage au cloud remplace les dépenses d'investissement (CAPEX) par des dépenses opérationnelles (OPEX), ce qui apporte de la flexibilité mais complique la prévisibilité budgétaire. Le FinOps est la discipline qui vise à optimiser les dépenses cloud en temps réel, en responsabilisant chaque équipe sur sa consommation. Sans gouvernance FinOps, les factures cloud peuvent rapidement dépasser les prévisions.
---
### Qu'est-ce qu'un Compound AI System ?
Source : https://www.hymaia.com/qu-est-ce-que/compound-ai-systems/
Un Compound AI System est un système d'IA composé de plusieurs composants orchestrés (LLMs, retrievers, outils, code) pour résoudre des tâches complexes. Plutôt que de tout confier à un seul modèle, cette approche modulaire combine les forces de chaque composant pour obtenir de meilleurs résultats.
Un **Compound AI System** (système d'IA composé) est une architecture qui combine plusieurs composants — modèles de langage, modules de recherche, outils logiciels, bases de données, code déterministe — pour accomplir une tâche que chaque composant seul ne pourrait pas réaliser avec la même qualité. Le concept a été formalisé par des chercheurs du Berkeley AI Research (BAIR) lab début 2024, en réaction à la tendance dominante du "tout-LLM".
### L'argument contre le modèle unique
L'approche naïve de l'IA générative consiste à envoyer une question à un LLM et à lui faire confiance pour la réponse. Cette approche atteint rapidement ses limites :
- Le LLM ne dispose pas de données à jour (ses connaissances s'arrêtent à sa date d'entraînement).
- Il ne peut pas effectuer de calculs fiables (les opérations arithmétiques complexes génèrent des erreurs).
- Il ne peut pas interroger des systèmes externes (bases de données, APIs).
- Il hallucine quand l'information lui manque.
Plutôt que d'attendre un modèle hypothétique qui résoudrait tous ces problèmes, l'approche Compound AI Systems propose d'assembler des composants spécialisés, chacun excellent dans son domaine.
### Anatomie d'un Compound AI System
Un système composé typique comprend plusieurs couches :
**Le LLM comme raisonneur.** Le modèle de langage joue le rôle de moteur de raisonnement et de génération de texte. Il comprend les intentions de l'utilisateur, planifie les étapes nécessaires et formule les réponses. Mais il ne fait pas tout seul.
**Le retriever.** Un module de recherche sémantique ou un système RAG fournit au LLM des informations contextuelles tirées de documents, de bases vectorielles ou de knowledge graphs. Le retriever comble le manque de connaissances à jour du modèle.
**Les outils (tools).** Des fonctions logicielles que le LLM peut appeler : calculatrice, interpréteur de code, client API, requêteur SQL. Ces outils apportent des capacités déterministes là où le LLM serait approximatif.
**Les guardrails.** Des mécanismes de contrôle en entrée et en sortie qui vérifient la conformité, filtrent les contenus inappropriés et valident la cohérence factuelle (grounding).
**L'orchestrateur.** Un composant qui coordonne l'ensemble : il décide quel composant appeler, dans quel ordre, et comment combiner les résultats. L'orchestrateur peut être un simple script, un graphe d'exécution (comme LangGraph) ou un agent IA autonome.
### Exemples concrets
**Un assistant de recherche juridique.** L'utilisateur pose une question sur la conformité d'un contrat. L'orchestrateur (1) envoie la question au retriever pour trouver les articles de loi pertinents, (2) transmet ces articles et la question au LLM pour analyse, (3) passe la réponse par un guardrail de vérification factuelle, (4) formate le résultat avec des citations sourcées.
**Un système de reporting financier.** L'utilisateur demande "Quelle est l'évolution de notre marge brute ce trimestre ?". L'orchestrateur (1) traduit la question en requête SQL via le LLM, (2) exécute la requête sur la base de données, (3) passe les résultats au LLM pour analyse et commentaire, (4) génère un graphique via un outil de visualisation.
**Un pipeline RAG avancé.** Le système combine recherche sémantique (embeddings), reranking (un modèle spécialisé reclasse les résultats par pertinence), et génération augmentée — trois composants distincts, chacun optimisable indépendamment.
### Pourquoi c'est mieux qu'un seul modèle
**Optimisation composant par composant.** Chaque pièce du système peut être améliorée indépendamment. Le retriever peut passer d'une recherche vectorielle simple à un GraphRAG sans modifier le LLM. Le LLM peut être remplacé par un modèle plus performant sans toucher au reste.
**Contrôle et explicabilité.** Les étapes intermédiaires sont observables : quels documents ont été récupérés ? Quels outils ont été appelés ? Quelles vérifications ont été faites ? Cette traçabilité facilite le débogage et la conformité réglementaire (AI Act).
**Coût maîtrisé.** On peut utiliser un modèle léger et économique pour le routage ou la classification, et un modèle puissant uniquement quand le raisonnement complexe est nécessaire.
**Fiabilité accrue.** Les composants déterministes (calculatrice, SQL) éliminent les approximations du LLM dans les domaines où la précision est requise.
### Compound AI Systems et IA agentique
Les agents IA sont une forme de Compound AI System où le LLM joue le rôle d'orchestrateur, décidant dynamiquement quels outils appeler et dans quel ordre. La distinction principale : dans un Compound AI System statique, le flux d'exécution est prédéfini (un graphe fixe) ; dans un système agentique, le LLM détermine le flux à l'exécution en fonction du contexte.
Les architectures multi-agents, où plusieurs agents spécialisés collaborent via des protocoles comme le A2A, représentent l'extension naturelle de cette approche vers des systèmes distribués.
### Outillage et frameworks
Plusieurs frameworks facilitent la construction de Compound AI Systems : LangChain et LlamaIndex pour l'assemblage de pipelines RAG, LangGraph et CrewAI pour l'orchestration de flux complexes, DSPy (Stanford) pour l'optimisation automatique des prompts dans un pipeline multi-étapes.
---
### Qu'est-ce que le context engineering ?
Source : https://www.hymaia.com/qu-est-ce-que/context-engineering/
Le context engineering consiste à concevoir et optimiser l'ensemble du contexte fourni à un LLM pour obtenir des réponses fiables. Au-delà du prompt, il intègre la sélection dynamique d'informations, la gestion de la mémoire et l'orchestration des sources de données.
Le **context engineering** désigne l'ensemble des pratiques visant à concevoir et optimiser le contexte fourni aux grands modèles de langage (LLM) pour maximiser la qualité de leurs réponses. Si le prompt engineering se concentre sur la formulation d'une instruction, le context engineering embrasse un périmètre bien plus large : il s'agit de déterminer quelles informations le modèle reçoit, dans quel ordre, sous quelle forme, et à quel moment.
### Du prompt engineering au context engineering
Le prompt engineering a constitué la première approche pour interagir efficacement avec les LLM. Rédiger un bon prompt -- avec des exemples, des consignes de format, un rôle -- reste utile. Mais cette approche atteint ses limites dès que l'on dépasse le cas d'usage conversationnel simple.
En production, un système d'IA ne se résume pas à un prompt statique. Il doit intégrer des documents internes, l'historique des interactions, des résultats d'appels d'API, des préférences utilisateur, voire des sorties d'autres modèles. C'est là que le context engineering prend le relais : il orchestre toutes ces sources pour construire un contexte pertinent à chaque requête.
Andrej Karpathy, ancien directeur de l'IA chez Tesla, a contribué à populariser cette distinction en soulignant que la performance d'un système LLM dépend moins de la qualité du modèle que de la qualité du contexte qu'on lui fournit.
### Les composantes du context engineering
Le context engineering s'articule autour de plusieurs mécanismes complémentaires :
**La sélection d'informations pertinentes.** Plutôt que de tout envoyer au modèle, on sélectionne dynamiquement les éléments nécessaires. C'est le principe du RAG (Retrieval-Augmented Generation), où un système de recherche identifie les documents pertinents dans une base de données vectorielle avant de les injecter dans le contexte du LLM.
**La gestion de la mémoire.** Un LLM n'a pas de mémoire native entre les sessions. Le context engineering définit comment stocker, résumer et rappeler les interactions passées. On distingue généralement la mémoire à court terme (conversation en cours), la mémoire à moyen terme (résumé des échanges récents) et la mémoire à long terme (préférences et faits durables stockés dans une base de données).
**La structuration du contexte.** L'ordre et le format des informations influencent directement la qualité des réponses. Les études montrent que les LLM accordent plus d'attention aux informations placées en début et en fin de contexte (effet "lost in the middle"). Le context engineering prend en compte ces biais pour organiser les informations de manière optimale.
**L'orchestration des sources.** Dans un système agentique, le contexte peut provenir de multiples sources : bases de données, API, fichiers, sorties d'autres agents. Le context engineering définit les règles de priorité, de filtrage et d'agrégation entre ces sources. Le protocole MCP (Model Context Protocol) d'Anthropic s'inscrit dans cette logique en standardisant la façon dont les outils externes fournissent du contexte aux modèles.
### Pourquoi le context engineering change la donne
La fenêtre de contexte des LLM a considérablement augmenté -- de 4 000 tokens pour GPT-3.5 à plus de 200 000 tokens pour Claude 3.5 et au-delà pour certains modèles récents. Mais une fenêtre plus grande ne signifie pas qu'on doive la remplir sans discernement. Au contraire, plus le contexte est grand, plus la qualité de sa curation devient déterminante.
Un context engineering rigoureux permet de :
- **Réduire les hallucinations** en fournissant au modèle les informations factuelles dont il a besoin, plutôt que de le laisser "inventer" des réponses.
- **Améliorer la pertinence** en adaptant le contexte au cas d'usage spécifique et au profil de l'utilisateur.
- **Maîtriser les coûts** en évitant d'envoyer des tokens inutiles, ce qui réduit la latence et la facture.
- **Fiabiliser les systèmes agentiques** en s'assurant que chaque agent dispose du bon contexte pour prendre des décisions pertinentes.
### Le context engineering en pratique
Concrètement, un AI Product Manager ou un ingénieur IA qui fait du context engineering va se poser des questions comme :
- Quelles données le modèle doit-il recevoir pour cette tâche ?
- Comment récupérer ces données en temps réel (RAG, API, cache) ?
- Comment gérer la limite de tokens sans perdre d'information critique ?
- Quel format (texte brut, JSON, markdown) optimise la compréhension du modèle ?
- Comment versionner et tester le contexte comme on versionne du code ?
Cette discipline est au cœur du travail des équipes qui déploient des LLM en production, qu'il s'agisse de chatbots, de copilots métier ou de systèmes multi-agents. Elle s'intègre naturellement dans les pratiques de LLMOps, où le contexte est traité comme un artefact à part entière, versionné, testé et monitoré.
### Liens avec l'écosystème IA
Le context engineering se situe à l'intersection de plusieurs disciplines connexes. Il s'appuie sur le RAG pour la récupération d'informations, sur les bases de données vectorielles pour le stockage des embeddings, et sur l'IA agentique pour l'orchestration multi-sources. Le fine-tuning constitue une approche complémentaire : là où le context engineering agit sur les entrées du modèle, le fine-tuning modifie le modèle lui-même. En pratique, les deux approches se combinent.
---
### Qu'est-ce que CRISP-ML(Q), la méthodologie ML ?
Source : https://www.hymaia.com/qu-est-ce-que/crisp-ml/
CRISP-ML(Q) est une méthodologie qui standardise le cycle de vie des projets de Machine Learning en 7 étapes, de la compréhension du problème au monitoring en production, avec un prisme qualité.
CRISP-ML(Q) (Cross-Industry Standard Process for Machine Learning with Quality Assurance) est un cadre méthodologique qui structure le développement de projets de Machine Learning en définissant des étapes claires, des livrables attendus et des critères de qualité à chaque phase. Publiée en 2021 par des chercheurs allemands (Studer et al.), cette méthodologie comble un manque : disposer d'un processus standardisé adapté aux spécificités du ML, là où les pratiques de développement logiciel classiques ne suffisent pas.
### Pourquoi une méthodologie spécifique au ML ?
Le développement de modèles de Machine Learning diffère fondamentalement du développement logiciel classique. Le code n'est qu'une partie du système : les données, les hyperparamètres, les métriques d'évaluation et l'environnement de déploiement sont tout aussi déterminants. Un modèle peut être techniquement performant en laboratoire et échouer en production à cause d'un data drift, d'un biais dans les données d'entraînement, ou d'un décalage entre les métriques techniques et la valeur business. CRISP-ML(Q) adresse ces risques en intégrant des points de contrôle qualité à chaque étape.
### Les 7 étapes de CRISP-ML(Q)
**1\. Compréhension du problème business**
Avant de toucher aux données ou aux algorithmes, CRISP-ML(Q) impose de cadrer précisément le problème à résoudre. Quels sont les objectifs business ? Quels critères de succès mesurables ? Quelles contraintes (latence, interprétabilité, coût) ? Cette étape produit un cahier des charges ML qui aligne les parties prenantes et évite le piège classique de construire un modèle performant qui ne répond pas au bon problème.
**2\. Compréhension des données**
Phase d'exploration et d'audit des données disponibles. L'équipe analyse la qualité des données (valeurs manquantes, incohérences, doublons), leur distribution, les corrélations potentielles et les biais éventuels. Cette étape détermine si les données existantes permettent effectivement de répondre au problème posé — et si non, quelles données collecter.
**3\. Préparation des données**
Les données brutes sont rarement exploitables en l'état. Cette phase couvre le nettoyage (traitement des valeurs aberrantes et manquantes), la transformation (normalisation, encodage des variables catégorielles), l'enrichissement (feature engineering) et la création des jeux d'entraînement, de validation et de test. C'est typiquement l'étape la plus longue d'un projet ML — souvent 60 à 80 % du temps total. L'utilisation d'un feature store peut accélérer cette phase en réutilisant des features déjà calculées pour d'autres projets.
**4\. Modélisation**
Sélection des algorithmes candidats, entraînement sur les données préparées, optimisation des hyperparamètres. CRISP-ML(Q) recommande de tester plusieurs approches (du modèle simple au complexe) et de documenter systématiquement les expérimentations et leurs résultats. Un ML Engineer ou un Data Scientist mène cette phase en utilisant des outils de tracking d'expériences (MLflow, Weights & Biases).
**5\. Évaluation**
Le modèle est évalué non seulement sur ses métriques techniques (précision, rappel, F1-score) mais aussi sur des critères business, de robustesse et d'équité. L'error analysis — l'étude détaillée des cas où le modèle se trompe — permet de comprendre ses faiblesses et de décider s'il est prêt pour la production. CRISP-ML(Q) insiste sur la distinction entre performance sur les données de test et performance attendue en conditions réelles.
**6\. Déploiement**
Le modèle validé est intégré dans le système de production. Cette phase couvre le packaging du modèle, la mise en place de l'infrastructure de serving (API, batch), l'intégration avec les systèmes existants et les tests en conditions réelles (A/B testing, shadow mode). Les pratiques MLOps prennent ici toute leur importance pour automatiser et fiabiliser le déploiement.
**7\. Monitoring et maintenance**
C'est la phase qui distingue le plus CRISP-ML(Q) de son ancêtre CRISP-DM. Une fois en production, le modèle doit être surveillé en continu : détection du data drift (les données entrantes changent de distribution), suivi des performances réelles, alerting en cas de dégradation. La maintenance inclut le ré-entraînement périodique, la mise à jour des données de référence et l'adaptation aux évolutions du contexte métier.
### CRISP-ML(Q) vs CRISP-DM
CRISP-ML(Q) est une adaptation de CRISP-DM (Cross-Industry Standard Process for Data Mining), publié en 1999 et longtemps utilisé comme référence pour les projets data. La différence majeure porte sur les phases de monitoring et de maintenance, absentes de CRISP-DM car le data mining classique ne nécessitait pas de modèles en production continue. CRISP-ML(Q) ajoute aussi le "Q" — Quality Assurance — en intégrant des contrôles qualité systématiques à chaque étape, pas seulement à l'évaluation.
### En pratique
CRISP-ML(Q) n'est pas une méthode rigide : les étapes peuvent être itérées, les retours en arrière sont fréquents (un problème détecté en évaluation renvoie souvent à la préparation des données). La méthodologie fournit un cadre de communication entre Data Scientists, ML Engineers, Product Managers et parties prenantes métier, en définissant un vocabulaire et des livrables communs.
---
### Qu'est-ce qu'un Data Analyst et quel est son rôle ?
Source : https://www.hymaia.com/qu-est-ce-que/data-analyst/
Le Data Analyst collecte, nettoie et analyse les données de l'entreprise pour produire des indicateurs, des rapports et des recommandations qui éclairent la prise de décision stratégique et opérationnelle.
Le Data Analyst est le professionnel qui transforme les données brutes en informations exploitables pour les décideurs. Sa mission : extraire, fiabiliser et analyser les données de l'entreprise afin de produire des indicateurs de performance (KPI), des rapports et des recommandations actionnables. C'est souvent le premier rôle data qu'une organisation recrute, car il répond au besoin fondamental de comprendre ce qui se passe dans l'entreprise à partir des données.
### Les responsabilités du Data Analyst
**Collecte et exploration des données** — Le Data Analyst identifie les sources de données pertinentes (bases de données internes, CRM, outils marketing, API externes), les interroge et les croise pour construire une vision cohérente. Cette phase implique de comprendre le modèle de données, de vérifier la qualité des informations et de détecter les anomalies ou les incohérences.
**Nettoyage et préparation** — Les données brutes sont rarement exploitables en l'état. Le Data Analyst traite les valeurs manquantes, corrige les erreurs de saisie, harmonise les formats et crée des variables dérivées. Cette étape représente souvent 60 à 80 % du temps de travail — un fait que les non-praticiens sous-estiment systématiquement.
**Analyse et modélisation** — Le coeur du métier. Le Data Analyst réalise des analyses descriptives (que s'est-il passé ?), diagnostiques (pourquoi ?) et parfois prédictives (que va-t-il se passer ?). Il utilise des techniques statistiques — agrégations, segmentation, corrélations, tests d'hypothèses, régressions — pour identifier des tendances, des patterns et des anomalies dans les données.
**Visualisation et reporting** — Le Data Analyst conçoit des tableaux de bord interactifs et des rapports visuels qui rendent les données accessibles aux équipes métier. C'est un exercice de data storytelling : il ne suffit pas de montrer des chiffres, il faut raconter une histoire qui guide la décision. Un bon tableau de bord répond à des questions business précises, pas à "montre-moi toutes les données".
**Recommandations** — Au-delà de l'analyse, le Data Analyst formule des recommandations actionnables. Il ne se contente pas de constater que le taux de churn a augmenté de 15 % : il identifie les segments concernés, les causes probables et les leviers d'action. C'est cette capacité à passer du "quoi" au "et maintenant ?" qui distingue un bon Data Analyst.
### Les outils du Data Analyst
**SQL** — La compétence fondamentale. Le Data Analyst passe une grande partie de son temps à écrire des requêtes SQL pour extraire et transformer des données. La maîtrise des jointures, des fonctions de fenêtrage (window functions), des CTE et des sous-requêtes est indispensable.
**Python ou R** — Pour les analyses avancées, l'automatisation de tâches répétitives et le traitement de données que SQL ne gère pas efficacement. Python (avec pandas, matplotlib, seaborn) est devenu le standard de facto, mais R reste utilisé dans certains domaines (statistiques académiques, biostatistiques).
**Outils de BI** — Power BI, Tableau, Looker, Metabase : ces outils permettent de créer des tableaux de bord interactifs sans coder. Le choix dépend de l'écosystème technique de l'entreprise et de la data platform en place.
**Tableur** — Excel et Google Sheets restent omniprésents pour les analyses rapides, les vérifications et la communication avec des interlocuteurs non techniques. Un Data Analyst qui méprise le tableur se coupe d'un outil de communication efficace.
### Différences avec les rôles voisins
**Data Analyst vs Data Scientist** — Le Data Scientist se concentre sur la modélisation prédictive et le machine learning, là où le Data Analyst se focalise sur l'analyse descriptive et diagnostique. Le Data Scientist construit des modèles ; le Data Analyst construit des analyses et des tableaux de bord. En pratique, la frontière est poreuse et dépend de la maturité data de l'organisation.
**Data Analyst vs Data Engineer** — Le Data Engineer construit et maintient l'infrastructure qui rend les données accessibles : pipelines d'ingestion, data warehouse, orchestration. Le Data Analyst exploite ces données pour produire des analyses. Sans Data Engineer, le Data Analyst passe trop de temps à extraire et préparer les données ; sans Data Analyst, les pipelines du Data Engineer ne servent à rien.
**Data Analyst vs Analytics Engineer** — L'Analytics Engineer, rôle plus récent popularisé par dbt, se concentre sur la transformation et la modélisation des données en amont, en appliquant les bonnes pratiques du génie logiciel (tests, versioning, documentation). Il fournit au Data Analyst des datasets propres et fiables, lui permettant de se concentrer sur l'analyse et les recommandations.
### Compétences clés
Au-delà des compétences techniques, un bon Data Analyst possède une pensée critique solide (remettre en question les données et les hypothèses), une capacité de communication adaptée à son audience (technique ou métier), une connaissance du domaine business, et de la rigueur méthodologique. La data literacy n'est pas qu'une compétence technique : c'est la capacité à poser les bonnes questions aux données et à interpréter les réponses avec nuance.
---
### Qu'est-ce que le Data as a Product ?
Source : https://www.hymaia.com/qu-est-ce-que/data-as-a-product/
Le Data as a Product est une approche qui consiste a traiter les donnees comme un produit a part entiere, avec un responsable, des utilisateurs et des standards de qualite. C'est l'un des 4 piliers du Data Mesh.
Le **Data as a Product** est un principe d'architecture et d'organisation qui applique les methodes du Product Management aux donnees d'entreprise. Plutot que de considerer les donnees comme un sous-produit des systemes operationnels, cette approche les traite comme des produits autonomes, concus pour repondre aux besoins de consommateurs identifies.
### Origine et lien avec le Data Mesh
Le concept a ete formalise par Zhamak Dehghani en 2019 dans le cadre du **Data Mesh**, dont il constitue l'un des quatre piliers fondateurs (aux cotes du Data Ownership par domaine, de la Self-Serve Data Platform et de la Federated Computational Governance). Mais le principe depasse le Data Mesh : toute organisation peut adopter une approche "data as a product" sans implementer l'ensemble du paradigme.
### Les proprietes d'un Data Product
Un Data Product de qualite respecte plusieurs proprietes, souvent resumees par l'acronyme DATSIS :
- **Decouvrable** : les consommateurs potentiels peuvent trouver le produit via un catalogue de donnees, avec une documentation claire sur son contenu, sa fraicheur et ses limites.
- **Accessible** : l'acces se fait via des interfaces standardisees (API, SQL, fichiers partages) sans necessiter l'intervention de l'equipe productrice.
- **Fiable (Trustworthy)** : des mecanismes de qualite garantissent l'exactitude, la completude et la coherence des donnees. Des SLA (Service Level Agreements) definissent les engagements de disponibilite et de fraicheur.
- **Semantiquement claire** : les donnees sont documentees avec des definitions metier non ambigues, des schemas versionnes et des exemples d'utilisation.
- **Interoperable** : le produit suit des conventions globales (nommage, formats, fuseaux horaires) qui permettent de le combiner avec d'autres Data Products sans friction.
- **Securisee** : les politiques d'acces et de confidentialite sont integrees au produit, conformement aux regles de **Data Governance** de l'organisation.
### Le Data Quantum : l'unite architecturale
Chaque Data Product s'incarne dans une unite logique appelee **Data Quantum**, qui encapsule l'ensemble des composants necessaires a son fonctionnement autonome : les donnees elles-memes, les metadonnees, le code de transformation, les politiques d'acces et l'infrastructure sous-jacente. Cette encapsulation garantit que le produit peut etre deploye, mis a jour et opere independamment.
### Comment ca fonctionne en pratique
Concretement, construire un Data Product implique de definir :
1\. **Un responsable produit** : souvent un **Data Product Manager** ou un **Data Steward** du domaine metier, qui priorise les evolutions en fonction des besoins des consommateurs.
2\. **Un contrat de donnees** : un Data Contract qui formalise le schema, les SLA de qualite et les regles d'acces. Ce contrat sert d'interface entre producteurs et consommateurs.
3\. **Une infrastructure en self-service** : hebergee sur une **Data Platform** qui fournit les briques de stockage, de transformation et de distribution sans que chaque equipe doive reinventer la roue.
4\. **Des metriques d'usage** : comme pour un produit logiciel, on mesure l'adoption (nombre de consommateurs), la satisfaction et la qualite percue.
### Pourquoi c'est important
L'approche Data as a Product resout un probleme recurrent : les donnees existent mais personne ne les utilise parce qu'elles sont mal documentees, difficiles d'acces ou de qualite incertaine. En appliquant les reflexes du Product Management (comprendre les utilisateurs, iterer, mesurer), les equipes produisent des donnees reellement exploitees.
Les organisations qui adoptent cette approche constatent generalement une reduction du temps de decouverte et d'acces aux donnees, une meilleure confiance dans les analyses et une diminution des pipelines de donnees "shadow" construits en contournant les systemes officiels.
### Cas d'usage concrets
- **Equipe Finance** qui publie un Data Product "Revenue par produit" avec un SLA de fraicheur J+1, consomme par les equipes Marketing, Direction et Data Analysts.
- **Equipe RH** qui expose un Data Product "Effectifs et competences" avec des regles d'acces differenciees selon le niveau hierarchique du consommateur.
- **Equipe Produit** qui maintient un Data Product "Evenements utilisateur" alimente en temps reel, consomme par les equipes Data Science pour la modelisation et par les Analytics Engineers pour le reporting.
---
### Qu'est-ce que le Data Business Model Canvas ?
Source : https://www.hymaia.com/qu-est-ce-que/data-business-model-canvas/
Le Data Business Model Canvas est un outil de cadrage qui adapte le Business Model Canvas d'Alex Osterwalder aux projets Data, en structurant la reflexion autour de 9 sections centrees sur la donnee.
Le **Data Business Model Canvas** est un framework visuel qui aide les equipes a structurer la phase de cadrage d'un projet Data. Inspire du Business Model Canvas classique d'Alex Osterwalder, il transpose les 9 blocs fondamentaux au contexte specifique de la valorisation des donnees.
### Pourquoi un canvas specifique a la Data
Le Business Model Canvas classique est concu pour modeliser une activite economique dans son ensemble. Mais lorsqu'une organisation cherche a creer de la valeur a partir de ses donnees, les questions changent : quelles donnees sont disponibles ? Comment les collecter ? Qui les consomme ? A quel cout ? Le Data Business Model Canvas apporte un cadre structure pour repondre a ces questions des le lancement d'un projet.
C'est un outil de **Data Governance** appliquee : il force les equipes a expliciter leurs hypotheses sur la valeur, les sources, les couts et les risques avant de commencer a construire quoi que ce soit.
### Les 9 sections du canvas
#### 1. Segments de clients Data
Identifier les consommateurs de donnees : equipes internes (Data Analysts, equipes metier, direction), clients externes, partenaires. Chaque segment a des besoins differents en termes de format, de fraicheur et de granularite.
#### 2. Proposition de valeur Data
Definir ce que les donnees apportent concretement : acceleration de la prise de decision, automatisation de processus, personnalisation client, reduction des risques. La proposition de valeur doit etre formulee du point de vue du consommateur, pas du producteur.
#### 3. Sources de donnees
Cartographier les sources internes (bases operationnelles, CRM, ERP, logs applicatifs) et externes (open data, API tierces, donnees partenaires). Cette section rejoint le travail de **Data Lineage** : comprendre d'ou viennent les donnees et comment elles sont produites.
#### 4. Acquisition des donnees
Decrire les mecanismes de collecte : ingestion batch, streaming, API, scraping, saisie manuelle. Les choix d'acquisition impactent directement la fraicheur et la fiabilite des donnees. Un **Data Engineer** est generalement implique dans la conception de ces pipelines.
#### 5. Traitement et transformation
Preciser les etapes de nettoyage, enrichissement, agregation et modelisation. C'est ici que se definit la chaine de transformation hebergee sur la **Data Platform** de l'organisation.
#### 6. Propriete et acces
Definir qui est responsable des donnees (Data Owner, **Data Steward**) et qui peut y acceder. Cette section couvre les politiques de **Data Governance**, les niveaux d'habilitation et la conformite reglementaire (RGPD, AI Act).
#### 7. Canaux de distribution
Identifier comment les donnees parviennent a leurs consommateurs : dashboards, API, exports CSV, data products en self-service, rapports automatises. L'approche **Data as a Product** influence directement ce bloc en poussant vers des interfaces standardisees et documentees.
#### 8. Modele de revenus Data
Evaluer la valeur economique : reduction de couts, generation de revenus directs (vente de donnees, monetisation d'insights), acceleration time-to-market, amelioration de la satisfaction client. Meme pour des projets internes, quantifier la valeur aide a prioriser.
#### 9. Structure de couts Data
Estimer les couts : infrastructure cloud, licences logicielles, temps des equipes (Data Engineers, Data Analysts, **Data Strategist**), maintenance des pipelines, gouvernance. Ce bloc permet d'evaluer la rentabilite du projet avant de le lancer.
### Comment l'utiliser
Le canvas se remplit idealement en atelier collaboratif avec les parties prenantes du projet : sponsor metier, equipe Data, equipe produit. Une session de 2 a 3 heures suffit pour une premiere iteration. Le resultat sert de document de reference pour aligner les attentes et prioriser les chantiers.
L'outil est particulierement utile dans les phases amont, quand les equipes hesitent entre plusieurs cas d'usage Data. En rendant visibles les hypotheses et les dependances, il permet d'identifier rapidement les projets a fort potentiel et ceux qui necessitent des prerequis (qualite des donnees, acces, competences).
### Lien avec d'autres frameworks
Le Data Business Model Canvas se combine naturellement avec d'autres outils de cadrage : le Lean Canvas pour la dimension produit, le Data Mesh pour l'organisation decentralisee, ou le CRISP-ML pour les projets de Machine Learning. Il ne remplace pas ces frameworks mais les complete en couvrant la dimension strategique et economique.
---
### Qu'est-ce qu'un Data Contract ?
Source : https://www.hymaia.com/qu-est-ce-que/data-contract/
Un Data Contract est un accord formel entre un producteur et un consommateur de données qui définit la structure, le format, la qualité attendue et les SLAs des données échangées. Il formalise les engagements de chaque partie et rend les dépendances data explicites et vérifiables.
Un **Data Contract** (contrat de données) est un accord explicite et versionné entre un producteur de données et un ou plusieurs consommateurs. Il spécifie précisément ce que le producteur s'engage à fournir — structure, format, fréquence de mise à jour, niveaux de qualité, temps de disponibilité — et ce que le consommateur peut attendre. C'est, en essence, une API contract appliquée au monde de la donnée.
### Le problème que résout le Data Contract
Dans la plupart des organisations, les dépendances entre producteurs et consommateurs de données sont implicites. Une équipe marketing utilise une table produite par l'équipe finance, sans qu'aucun accord formel ne définisse les règles du jeu. Quand le schéma de la table change, quand une colonne disparaît ou quand la granularité des données évolue, les pipelines en aval cassent — souvent sans que personne ne comprenne immédiatement pourquoi.
Ce problème s'aggrave avec la décentralisation de la gestion des données. Dans une architecture **Data Mesh**, où chaque domaine métier est responsable de ses propres données, la multiplication des interfaces entre domaines rend les dépendances implicites ingérables. Le Data Contract apporte une solution en rendant ces dépendances explicites, documentées et vérifiables automatiquement.
### Que contient un Data Contract ?
Un Data Contract couvre typiquement les éléments suivants :
**Le schéma des données.** La définition précise des champs : noms, types, formats, contraintes de nullabilité, valeurs autorisées. C'est le cœur technique du contrat — l'équivalent d'un schéma d'API.
**Les SLAs (Service Level Agreements).** Les engagements de qualité de service : fraîcheur des données (toutes les heures ? tous les jours ?), disponibilité (99,9 % ?), temps de réponse. Ces SLAs permettent au consommateur de dimensionner ses propres traitements en conséquence.
**Les règles de qualité.** Les contrôles que les données doivent satisfaire : unicité de certaines clés, plages de valeurs acceptables, taux de complétion minimum, cohérence entre champs. Ces règles sont vérifiables automatiquement — elles constituent des tests que le producteur exécute avant de publier ses données.
**Les métadonnées sémantiques.** La documentation métier des champs : que signifie "revenu" dans ce contexte ? Est-ce le revenu brut ou net ? Inclut-il les taxes ? Cette couche sémantique évite les malentendus qui mènent à des analyses erronées.
**Les conditions de changement.** Les règles de versioning : comment le producteur peut-il faire évoluer le contrat ? Quels types de changements sont rétrocompatibles ? Quel préavis est donné aux consommateurs avant un breaking change ?
**Le propriétaire et les contacts.** Qui est responsable du contrat côté producteur ? Qui contacter en cas de problème ? Cette identification claire des responsabilités est un principe fondamental de la **Data Governance**.
### Data Contract et Data Mesh
Le Data Contract est un complément naturel du **Data Mesh**. Dans une architecture Data Mesh, chaque domaine publie ses données "as a product" — les données sont traitées comme des produits avec des consommateurs identifiés et des engagements de qualité. Le Data Contract est le mécanisme qui formalise ces engagements.
Sans Data Contracts, le Data Mesh reste une intention organisationnelle sans garantie de fiabilité à l'interface entre domaines. Avec des Data Contracts, chaque domaine peut évoluer de manière autonome tout en garantissant la stabilité des interfaces — exactement comme les microservices communiquent via des API contracts.
### Mise en œuvre technique
Plusieurs approches existent pour implémenter des Data Contracts :
- **Fichiers YAML/JSON versionnés** dans un repository Git, définissant le schéma et les règles de qualité. Des outils comme Soda, Great Expectations ou dbt tests permettent de vérifier la conformité au contrat.
- **Registres de schémas** (schema registries) qui centralisent les définitions et contrôlent la compatibilité des évolutions.
- **Plateformes dédiées** comme Datacontract.com ou les fonctionnalités natives de certaines **Data Platforms** modernes.
L'approche la plus pragmatique pour commencer : un fichier YAML versionné dans le même repository que le code de production des données, avec des tests automatisés dans le pipeline CI/CD.
### Data Contract et Data Platform
Le Data Contract s'intègre dans l'écosystème technique de la **Data Platform**. Les outils d'orchestration (Airflow, Dagster, Prefect) peuvent vérifier la conformité au contrat à chaque exécution de pipeline. Les outils de catalogage (DataHub, Amundsen, OpenMetadata) peuvent exposer les contrats pour faciliter la découverte et la compréhension des données disponibles. Les **Feature Stores** peuvent s'appuyer sur des contrats pour garantir la cohérence des features servies aux modèles.
### Adoption progressive
Un piège fréquent est de vouloir contractualiser toutes les interfaces data d'un coup. L'approche recommandée est progressive :
1\. Identifier les interfaces critiques — celles dont la rupture cause le plus de dégâts.
2\. Formaliser un premier contrat simple (schéma + quelques règles de qualité).
3\. Automatiser la vérification.
4\. Étendre progressivement à d'autres interfaces et enrichir les contrats existants.
Le Data Contract n'est pas une fin en soi, mais un outil au service de la fiabilité et de la confiance dans les données — deux prérequis pour que les projets data et IA puissent tenir leurs promesses.
---
### Qu'est-ce que le Data Drift en Machine Learning ?
Source : https://www.hymaia.com/qu-est-ce-que/data-drift/
Le Data Drift designe le changement de distribution des donnees en entree d'un modele de Machine Learning au fil du temps, pouvant degrader ses performances sans que le modele lui-meme ait change.
Le **Data Drift** (derive des donnees) est un phenomene ou la distribution statistique des donnees d'entree d'un modele de Machine Learning evolue par rapport aux donnees sur lesquelles il a ete entraine. Le modele reste identique, mais les donnees qu'il recoit en production ne ressemblent plus a celles qu'il a appris a traiter.
### Pourquoi le Data Drift se produit
Les causes sont multiples et souvent liees a l'evolution naturelle de l'environnement :
- **Changements de comportement utilisateur** : les habitudes d'achat, de navigation ou de consommation evoluent avec les saisons, les tendances ou les crises economiques.
- **Modifications des processus metier** : un changement dans la politique de collecte de donnees, un nouveau formulaire client ou une migration de systeme modifient la forme des donnees.
- **Evolution des sources externes** : les API tierces changent de format, les fournisseurs de donnees modifient leurs methodes de calcul, les reglementations imposent de nouvelles contraintes.
- **Problemes techniques** : bugs dans les pipelines d'ingestion, changements de schema non documentes, erreurs de jointure entre tables.
### Data Drift vs Concept Drift
Ces deux notions sont souvent confondues mais designent des phenomenes distincts :
- **Data Drift** (covariate shift) : la distribution des variables d'entree (features) change, mais la relation entre ces variables et la cible reste la meme. Exemple : un modele de scoring credit entraine sur des clients de 25-45 ans recoit soudainement des dossiers de clients de 18-25 ans.
- **Concept Drift** : la relation entre les variables d'entree et la variable cible change. Le "concept" que le modele a appris n'est plus valide. Exemple : pendant le COVID-19, les patterns de consommation ont change si radicalement que les modeles de prevision de ventes sont devenus obsoletes, meme si les donnees d'entree avaient le meme format.
En pratique, les deux phenomenes peuvent se produire simultanement, et distinguer l'un de l'autre necessite une analyse fine des metriques de monitoring.
### Comment detecter le Data Drift
La detection repose sur des tests statistiques appliques aux distributions des features :
- **Tests statistiques** : test de Kolmogorov-Smirnov (KS) pour les variables continues, test du chi-deux pour les variables categorielles, Population Stability Index (PSI).
- **Monitoring des distributions** : comparaison des histogrammes et des statistiques descriptives (moyenne, variance, quantiles) entre les donnees d'entrainement et les donnees de production.
- **Alertes sur les metriques modele** : une degradation des performances (accuracy, precision, recall) peut signaler un drift sous-jacent, mais c'est un indicateur retarde.
Des outils de **MLOps** comme Evidently, Whylogs ou les modules de monitoring des cloud providers integrent ces mecanismes. Le **ML Engineer** est generalement responsable de la mise en place de ces pipelines de surveillance.
### Comment reagir face au Data Drift
Plusieurs strategies existent, selon la severite et la nature du drift :
1\. **Reentrainement periodique** : planifier des cycles de reentrainement reguliers (hebdomadaires, mensuels) pour que le modele s'adapte aux evolutions. C'est l'approche la plus courante, automatisee via des pipelines **MLOps**.
2\. **Reentrainement declenche** : configurer des seuils d'alerte sur les metriques de drift et declencher un reentrainement automatique quand ils sont depasses.
3\. **Fenetre glissante** : entrainer le modele uniquement sur les donnees les plus recentes, en abandonnant les donnees historiques devenues non representatives.
4\. **Analyse des causes racines** : avant de reentrainer, comprendre pourquoi le drift s'est produit. Parfois, le probleme vient d'un bug dans le pipeline de donnees ou d'un changement de schema — et la solution n'est pas de reentrainer mais de corriger la source.
L'**Error Analysis** est une methode complementaire : elle permet d'identifier sur quels segments de donnees le modele se degrade le plus, et de cibler les actions correctives.
### Lien avec la Data Governance
Le Data Drift est aussi un enjeu de **Data Governance** : documenter les schemas de donnees, versionner les datasets d'entrainement et maintenir un **Data Lineage** clair sont autant de pratiques qui facilitent la detection et la resolution des derives. Un **Feature Store** bien gere, en centralisant la definition et le calcul des features, reduit le risque de drift lie aux incoherences entre entrainement et production.
Le framework **CRISP-ML** integre explicitement la surveillance post-deploiement comme une phase du cycle de vie d'un modele, et le Data Drift en est l'un des indicateurs principaux.
---
### Qu'est-ce qu'un Data Engineer ?
Source : https://www.hymaia.com/qu-est-ce-que/data-engineer/
Le Data Engineer concoit, construit et maintient les pipelines et infrastructures de donnees qui permettent aux organisations de collecter, transformer et mettre a disposition leurs donnees a grande echelle.
Le **Data Engineer** est le professionnel responsable de la construction et de la maintenance des systemes qui permettent aux donnees de circuler de leurs sources jusqu'a leurs consommateurs. Son travail est le socle technique sur lequel reposent toutes les initiatives Data et IA d'une organisation.
### Responsabilites principales
Le quotidien d'un Data Engineer s'articule autour de plusieurs axes :
- **Conception de pipelines de donnees** : construire les flux qui extraient les donnees de systemes sources (bases de donnees, API, fichiers, evenements), les transforment et les chargent dans des systemes cibles. Ces pipelines peuvent fonctionner en **ingestion batch** (traitements planifies) ou en streaming (traitement en temps reel).
- **Modelisation et stockage** : definir les schemas de donnees, choisir les technologies de stockage adaptees (data warehouse, data lake, lakehouse) et organiser les donnees pour qu'elles soient exploitables par les equipes en aval.
- **Qualite et fiabilite** : mettre en place des tests de qualite, des mecanismes de detection d'anomalies et des alertes pour garantir que les donnees livrees sont completes, coherentes et fraiches.
- **Orchestration** : coordonner l'execution des pipelines avec des outils comme Airflow, Dagster ou Prefect, en gerant les dependances, les reprises sur erreur et la planification.
- **Infrastructure et performance** : optimiser les couts et les temps de traitement, gerer le dimensionnement des ressources sur le **Cloud** (AWS, GCP, Azure) et assurer la scalabilite des systemes.
### Competences techniques
Le Data Engineer maitrise un ensemble de technologies qui couvrent l'ensemble de la chaine de donnees :
- **Langages** : SQL (fondamental), Python (dominant pour l'orchestration et les transformations), parfois Scala ou Java pour les traitements distribues.
- **Frameworks de traitement** : **Spark** pour le traitement distribue a grande echelle, **dbt** pour les transformations SQL dans le data warehouse, Flink ou Kafka Streams pour le streaming.
- **Bases de donnees et stockage** : PostgreSQL, BigQuery, Snowflake, Redshift, Delta Lake, Apache Iceberg.
- **Orchestration** : Airflow, Dagster, Prefect, Mage.
- **Infrastructure** : Docker, Kubernetes, Terraform, services manages **AWS**/GCP/Azure.
- **Versionning et CI/CD** : Git, GitHub Actions, tests automatises sur les pipelines.
### Difference avec les roles proches
Le Data Engineer est souvent confondu avec d'autres roles de la data. Voici les distinctions principales :
- **Data Engineer vs Data Analyst** : le **Data Analyst** exploite les donnees pour produire des analyses et des insights metier. Le Data Engineer construit l'infrastructure qui rend ces analyses possibles. L'un est consommateur, l'autre producteur.
- **Data Engineer vs Analytics Engineer** : l'**Analytics Engineer** se concentre sur la couche de transformation dans le data warehouse, en utilisant des outils comme **dbt** pour modeliser les donnees metier. Le Data Engineer couvre un perimetre plus large, incluant l'ingestion, l'infrastructure et l'orchestration.
- **Data Engineer vs ML Engineer** : le **ML Engineer** se focalise sur la mise en production de modeles de Machine Learning. Le Data Engineer fournit les donnees et l'infrastructure que le ML Engineer consomme. Les deux roles se chevauchent sur les sujets de pipelines et de **Feature Store**.
### Ou travaille un Data Engineer
Le Data Engineer intervient generalement au sein d'une equipe **Data Platform** ou d'une equipe Data transverse. Dans une organisation en **Data Mesh**, il peut etre integre a une equipe de domaine metier, responsable de la production de **Data Products** pour ce domaine.
Ses interlocuteurs sont multiples : Data Analysts, Data Scientists, Analytics Engineers, Product Managers, equipes metier. Il sert de pont entre les systemes techniques et les besoins d'exploitation des donnees.
### Pourquoi le role est strategique
Sans Data Engineer, les donnees restent cloisonnees dans les systemes operationnels, inaccessibles et inexploitables. L'ensemble du **Modern Data Stack** repose sur le travail des Data Engineers : c'est leur infrastructure qui alimente les dashboards, les modeles de Machine Learning et les produits data.
La demande pour ce profil reste forte : les organisations qui investissent dans la data ont besoin de professionnels capables de construire des systemes fiables, scalables et maintenables.
---
### Qu'est-ce que la Data Governance ?
Source : https://www.hymaia.com/qu-est-ce-que/data-governance/
La Data Governance est le cadre strategique et operationnel qui definit les regles, les roles et les processus pour gerer les donnees d'une organisation de maniere fiable, securisee et conforme.
La **Data Governance** (gouvernance des donnees) designe l'ensemble des politiques, roles, processus et standards mis en place pour gerer les donnees comme un actif strategique de l'organisation. Elle repond a une question simple : qui est responsable de quoi en matiere de donnees, et selon quelles regles ?
### Pourquoi la Data Governance est necessaire
Sans gouvernance, les donnees deviennent un passif plutot qu'un actif. Les symptomes sont connus : personne ne sait quelle version d'un indicateur est la bonne, les equipes passent plus de temps a chercher et nettoyer les donnees qu'a les analyser, les risques de non-conformite reglementaire augmentent, et la confiance dans les donnees s'erode progressivement.
La Data Governance ne se resume pas a un projet IT. C'est un sujet organisationnel qui implique les equipes metier, la direction et les equipes techniques. Son objectif est de maximiser la valeur des donnees tout en minimisant les risques associes a leur utilisation.
### Les 9 domaines de la Data Governance
#### 1. Gestion des politiques
Definir des politiques claires pour la collecte, l'utilisation, la qualite, la securite et la retention des donnees. Ces politiques servent de cadre de reference pour l'ensemble de l'organisation.
#### 2. Gestion des donnees metier
Aligner la gestion des donnees avec les objectifs metier de l'entreprise. Cela implique de definir un vocabulaire commun (glossaire metier), d'identifier les donnees critiques et de prioriser les efforts de gouvernance en fonction de l'impact business.
#### 3. Gestion des responsabilites
Attribuer des roles clairs : **Data Owners** (responsables metier des donnees), **Data Stewards** (garants de la qualite et de la conformite au quotidien), comites de gouvernance. La regle d'or : chaque donnee doit avoir un responsable identifie.
#### 4. Gestion de la qualite des donnees
Mettre en place des mecanismes de verification, de nettoyage et de normalisation. La qualite se mesure selon plusieurs dimensions : exactitude, completude, coherence, fraicheur, unicite. Des outils de data quality (Great Expectations, Soda, Monte Carlo) automatisent ces controles.
#### 5. Gestion de la securite des donnees
Proteger les donnees contre les acces non autorises, les fuites et les attaques. Cela couvre le chiffrement, la gestion des identites, les logs d'acces et les tests de vulnerabilite.
#### 6. Gestion de la confidentialite
Assurer la conformite avec les reglementations de protection des donnees personnelles : RGPD en Europe, CCPA en Californie. L'**AI Act** ajoute une couche supplementaire pour les systemes d'IA qui traitent des donnees sensibles. La pseudonymisation, l'anonymisation et le consentement eclaire sont des outils concrets de cette gestion.
#### 7. Gestion de la documentation et des metadonnees
Maintenir un catalogue de donnees a jour, documenter les schemas, les definitions metier et les regles de transformation. Le **Data Lineage** — la tracabilite du parcours des donnees de la source a la consommation — est un composant de cette gestion.
#### 8. Gestion du cycle de vie des donnees
Definir les durees de conservation, les procedures d'archivage et de destruction. Les exigences varient selon les reglementations sectorielles (finance, sante, assurance) et les besoins metier.
#### 9. Gestion de la culture de la donnee
Promouvoir la **Data Literacy** au sein de l'organisation : former les collaborateurs, encourager l'utilisation des donnees dans la prise de decision, et ancrer les bonnes pratiques dans le quotidien des equipes. Sans appropriation par les metiers, la gouvernance reste un cadre theorique.
### Data Governance vs Data Management
Ces deux notions sont complementaires mais distinctes :
- La **Data Governance** definit le "quoi" et le "pourquoi" : les regles, les responsabilites, les principes directeurs.
- Le **Data Management** s'occupe du "comment" : les outils, les processus techniques, les operations quotidiennes de collecte, stockage et traitement.
La gouvernance est le cadre strategique, le management est l'execution operationnelle.
### Data Governance dans un contexte Data Mesh
Dans une organisation en **Data Mesh**, la gouvernance devient federee : chaque domaine metier applique les standards globaux sur ses propres donnees, plutot qu'une equipe centrale qui tente de tout controler. Le principe de **Federated Computational Governance** encode les regles de gouvernance dans des politiques automatisees (controles de qualite, gestion des acces, standards de nommage) appliquees de maniere uniforme sur l'ensemble des Data Products.
Cette approche est complementaire avec le concept d'**IA Responsable**, qui etend la gouvernance aux modeles d'IA : documentation des biais, tracabilite des decisions algorithmiques, evaluation de l'impact ethique.
### En pratique
Un programme de Data Governance reussi demarre petit : un domaine metier prioritaire, quelques indicateurs critiques, un Data Steward designe. L'erreur classique est de vouloir gouverner toutes les donnees d'un coup. Les organisations qui reussissent commencent par les donnees qui generent le plus de valeur ou de risque, prouvent la valeur de la gouvernance sur ce perimetre, puis etendent progressivement.
---
### Qu'est-ce que le Data Lineage ?
Source : https://www.hymaia.com/qu-est-ce-que/data-lineage/
Le Data Lineage retrace le parcours complet des donnees au sein d'une organisation : leur origine, les transformations subies et les systemes traverses, de la source jusqu'a la consommation finale.
Le **Data Lineage** (lignee des donnees) est la capacite a tracer et documenter le parcours des donnees depuis leur source d'origine jusqu'a leur utilisation finale. Il repond a trois questions fondamentales : d'ou viennent les donnees, comment ont-elles ete transformees, et ou sont-elles consommees ?
### Pourquoi le Data Lineage est indispensable
Sans Data Lineage, une organisation fait face a plusieurs problemes concrets :
- **Debugging aveugle** : quand un dashboard affiche un chiffre aberrant, les equipes passent des heures a remonter manuellement la chaine de transformation pour trouver l'erreur. Avec un lineage documente, la cause racine est identifiable en quelques minutes.
- **Impact inconnu des changements** : modifier un champ dans une table source peut casser des dizaines de rapports en aval. Le lineage permet d'evaluer l'impact d'un changement avant de le deployer.
- **Non-conformite reglementaire** : le RGPD et d'autres reglementations exigent de pouvoir expliquer comment les donnees personnelles sont traitees. Le Data Lineage fournit cette tracabilite.
- **Manque de confiance** : sans connaitre l'origine d'un indicateur, les equipes metier hesitent a s'appuyer dessus pour prendre des decisions.
### Les differents niveaux de granularite
Le Data Lineage peut s'exprimer a plusieurs niveaux :
- **Lineage au niveau des tables** : quelles tables alimentent quelles autres tables. C'est le niveau le plus courant et le plus facile a obtenir.
- **Lineage au niveau des colonnes** : quelle colonne source alimente quelle colonne cible, avec quelles transformations. Plus precis mais plus couteux a maintenir.
- **Lineage au niveau des valeurs** : pour une valeur specifique dans un rapport, retracer exactement quelles lignes et quelles transformations ont produit ce resultat. Rarement implemente en totalite, mais necessaire pour certains cas d'audit.
### Comment construire le Data Lineage
Plusieurs approches coexistent, souvent combinees :
- **Lineage automatique par les outils de transformation** : des outils comme **dbt** generent automatiquement le lineage au niveau des colonnes a partir des requetes SQL. C'est l'approche la plus fiable car elle est derivee directement du code.
- **Lineage par instrumentation des pipelines** : les orchestrateurs (Airflow, Dagster) et les moteurs de traitement (**Spark**) peuvent emettre des evenements de lineage via le standard OpenLineage.
- **Lineage par scanning des metadonnees** : des outils de catalogage (DataHub, Amundsen, Atlan, Collibra) scannent les bases de donnees, les entrepots et les outils BI pour reconstruire les relations.
- **Lineage manuel** : documentation humaine, souvent dans un wiki ou un catalogue. Peu fiable a grande echelle car rapidement obsolete.
### Outils et ecosysteme
L'ecosysteme du Data Lineage s'est structure autour de quelques categories :
- **Catalogues de donnees** : DataHub (open source, LinkedIn), Amundsen (open source, Lyft), Atlan, Alation, Collibra. Ils combinent catalogue, lineage et documentation.
- **Standard OpenLineage** : initiative open source qui definit un format commun pour les evenements de lineage, permettant l'interoperabilite entre outils.
- **Outils de transformation** : **dbt** integre nativement le lineage dans son DAG (Directed Acyclic Graph), rendant visible la chaine de transformation SQL.
### Data Lineage et Data Governance
Le Data Lineage est un composant technique de la **Data Governance**. Il materialise la tracabilite que la gouvernance exige : savoir qui a acces a quelles donnees, comment elles sont transformees, et ou elles sont consommees.
Pour un **Data Steward**, le lineage est un outil de travail quotidien : il permet de valider que les regles de qualite sont appliquees aux bons endroits, que les donnees sensibles sont correctement masquees tout au long de la chaine, et que les Data Contracts entre producteurs et consommateurs sont respectes.
Dans une architecture **Data Mesh**, le lineage prend une dimension supplementaire : il doit traverser les frontieres des domaines et montrer comment les **Data Products** d'un domaine alimentent ceux d'un autre. La **Data Platform** en self-service doit fournir cette visibilite de maniere automatisee.
### Cas d'usage concrets
- **Analyse d'impact** : avant de deprecier une table, identifier tous les dashboards, modeles ML et rapports qui en dependent.
- **Root cause analysis** : un KPI chute de 15% — remonter le lineage pour identifier si le probleme vient des donnees sources, d'une transformation ou d'un changement de definition.
- **Conformite RGPD** : repondre a une demande de droit d'acces en identifiant tous les systemes ou les donnees d'un individu sont stockees et traitees.
- **Onboarding** : un nouvel **Analytics Engineer** peut comprendre rapidement comment les donnees circulent dans l'organisation en explorant le lineage.
---
### Qu'est-ce que la Data Literacy ?
Source : https://www.hymaia.com/qu-est-ce-que/data-literacy/
La Data Literacy (litteratie des donnees) designe la capacite a lire, comprendre, analyser et communiquer avec les donnees. C'est une competence transversale, necessaire a tous les metiers.
La **Data Literacy** designe l'ensemble des competences qui permettent a un individu de travailler avec les donnees de maniere autonome et critique : les lire, les comprendre, les questionner, les analyser et les communiquer. Ce n'est pas une competence reservee aux data scientists ou aux analystes — c'est un socle commun que chaque collaborateur d'une organisation devrait maitriser a son niveau.
### Les competences qui composent la Data Literacy
La Data Literacy couvre un spectre large de competences, du plus basique au plus avance :
- **Lire les donnees** : comprendre un tableau, un graphique, un dashboard. Savoir ce que represente un axe, une legende, une echelle. Identifier les unites et les periodes.
- **Comprendre les donnees** : savoir d'ou viennent les donnees, comment elles sont collectees, quelles sont leurs limites. Distinguer une correlation d'une causalite. Reconnaitre les biais de selection et de survie.
- **Analyser les donnees** : poser les bonnes questions, filtrer, agreger, comparer. Utiliser des outils simples (tableur, outil BI) pour explorer un jeu de donnees et en extraire des insights.
- **Communiquer avec les donnees** : presenter des resultats de maniere claire et honnete, choisir la bonne visualisation, adapter le message a l'audience. C'est le domaine du **Data Storytelling** — la capacite a construire un recit convaincant a partir de donnees.
- **Questionner les donnees** : avoir le reflexe de challenger un chiffre, de demander la source, de verifier la methodologie. C'est peut-etre la competence la plus importante et la plus rare.
### Pourquoi la Data Literacy est un enjeu strategique
Les organisations investissent massivement dans les outils data (Data Platforms, outils BI, modeles de Machine Learning) mais negligent souvent la capacite des equipes a les utiliser. Le resultat : des dashboards que personne ne consulte, des modeles dont les predictions ne sont pas comprises, des decisions prises "au feeling" malgre la disponibilite des donnees.
Selon une etude Accenture de 2020, seulement 21% des collaborateurs se sentaient a l'aise pour travailler avec des donnees. Ce chiffre illustre le decalage entre les ambitions data-driven des organisations et la realite du terrain.
La Data Literacy est le chainon manquant entre l'investissement technologique et la creation de valeur. Sans elle, meme la meilleure **Data Governance** reste un cadre theorique, et meme la **Data Platform** la plus performante reste sous-utilisee.
### Comment developper la Data Literacy en entreprise
Un programme de Data Literacy efficace s'articule autour de plusieurs leviers :
#### Formation adaptee par population
Tous les collaborateurs n'ont pas besoin du meme niveau de competence. Un programme pertinent definit des niveaux :
- **Fondamentaux** : pour tous les collaborateurs — lire un dashboard, comprendre les KPI de son equipe, poser les bonnes questions.
- **Intermediaire** : pour les managers et les profils analytiques — construire des analyses, utiliser un outil BI, interpreter des resultats statistiques.
- **Avance** : pour les profils data (Data Analysts, **Citizen Data Scientists**) — modelisation, SQL, Python, methodologie statistique.
#### Ancrage dans le quotidien
La formation seule ne suffit pas. La Data Literacy se developpe par la pratique : integrer les donnees dans les rituels d'equipe (revues de performance, retrospectives), encourager les collaborateurs a construire leurs propres analyses, nommer des relais data dans chaque equipe.
Le role d'**AI Champion** s'inscrit dans cette logique : des collaborateurs formes qui evangelisent les bonnes pratiques data et IA au sein de leur equipe, et qui servent de premier point de contact pour les questions data.
#### Mesure de la progression
Comme tout programme de transformation, la Data Literacy doit etre mesuree : taux d'adoption des outils BI, nombre de dashboards crees par les equipes metier, qualite des questions posees lors des comites de decision, reduction du temps passe a chercher et verifier les donnees.
### Le role du Data Steward dans la Data Literacy
Le **Data Steward** est un acteur naturel de la Data Literacy : en maintenant un glossaire metier a jour, en documentant les definitions des indicateurs et en accompagnant les equipes dans l'utilisation des donnees, il contribue directement a elever le niveau de competence de l'organisation.
### Data Literacy et IA generative
L'emergence de l'IA generative (ChatGPT, assistants de code, agents IA) rend la Data Literacy plus importante que jamais. Ces outils permettent a des non-techniciens d'interagir avec les donnees en langage naturel, mais ils necessitent un esprit critique : savoir evaluer la pertinence d'une reponse generee, comprendre les limites d'un modele, detecter les hallucinations.
---
### Qu'est-ce que le Data Mesh ?
Source : https://www.hymaia.com/qu-est-ce-que/data-mesh/
Le Data Mesh est un paradigme d'architecture de donnees decentralise, fonde sur 4 piliers : ownership par domaine, Data as a Product, plateforme en self-service et gouvernance federee. Il est l'application du Domain-Driven Design a la data.
Le **Data Mesh** est un paradigme d'architecture et d'organisation des donnees propose par Zhamak Dehghani en 2019. Il remet en question le modele centralise dominant (data warehouse unique, equipe data centrale) en proposant une approche decentralisee ou chaque domaine metier est responsable de ses propres donnees.
### Le probleme que le Data Mesh resout
Le modele centralise classique fonctionne bien a petite echelle, mais montre ses limites quand l'organisation grandit :
- **Goulot d'etranglement** : une equipe data centrale recoit plus de demandes qu'elle ne peut en traiter. Les delais s'allongent, les priorites se multiplient, la frustration monte.
- **Deconnexion metier** : l'equipe centrale maitrise les outils techniques mais manque de contexte metier. Les donnees produites sont techniquement correctes mais peu pertinentes pour les utilisateurs.
- **Architecture monolithique** : le data warehouse ou le data lake central devient un systeme complexe, fragile et couteux a faire evoluer.
- **Propriete floue** : quand les donnees sont "a tout le monde", elles ne sont a personne. La qualite se degrade faute de responsable clair.
### Les 4 piliers du Data Mesh
#### 1. Domain Ownership (Propriete par domaine)
Chaque domaine metier (ventes, finance, produit, RH) est responsable de la production et de la qualite de ses propres donnees. L'equipe qui produit les donnees en est aussi la garante. Ce principe est directement inspire du **Domain-Driven Design** (DDD) d'Eric Evans, qui structure les systemes logiciels autour des domaines metier.
Concretement, cela signifie que l'equipe Finance ne demande plus a l'equipe Data centrale de construire un pipeline de revenus — elle le construit elle-meme, avec ses **Data Engineers** integres.
#### 2. Data as a Product
Les donnees ne sont pas un sous-produit des operations, mais un produit a part entiere. Chaque domaine publie ses donnees sous forme de **Data Products** avec des standards de qualite : documentation, SLA de fraicheur, schema versionne, interface d'acces standardisee. Le **Data Product Manager** ou le **Data Steward** du domaine joue le role de responsable produit.
Ce pilier est detaille dans l'article **Data as a Product** du datactionary.
#### 3. Self-Serve Data Platform
Pour que les domaines puissent etre autonomes sans que chacun reinvente la roue, une **Data Platform** en self-service fournit les briques techniques communes : stockage, orchestration, monitoring, catalogue de donnees, gestion des acces. L'equipe plateforme fournit les outils, les domaines les utilisent.
Cette plateforme est construite et maintenue par des **Data Engineers** dedies a l'infrastructure, distincts des Data Engineers qui travaillent au sein des domaines metier. Les technologies sous-jacentes reposent generalement sur le **Cloud** (AWS, GCP, Azure) et le **Modern Data Stack**.
#### 4. Federated Computational Governance
La **Data Governance** n'est plus centralisee mais federee : des standards globaux (conventions de nommage, politiques de securite, regles de qualite) sont definis collectivement et appliques de maniere automatisee sur l'ensemble des Data Products. Chaque domaine est responsable de l'application de ces standards sur ses propres donnees.
Le mot "computational" est important : les regles de gouvernance sont encodees dans le code et les pipelines, pas dans des documents PDF ignores. Les Data Contracts entre domaines formalisent ces engagements.
### Conditions de succes
Le Data Mesh n'est pas une solution universelle. Certaines conditions favorisent son adoption :
- **Taille de l'organisation** : le Data Mesh prend son sens a partir d'une certaine echelle (plusieurs equipes data, plusieurs domaines). Pour une startup de 20 personnes, une equipe data centralisee reste plus efficace.
- **Maturite data** : les equipes de domaine doivent avoir les competences pour gerer leurs propres donnees, ou etre accompagnees dans cette montee en competence.
- **Sponsorship de la direction** : le Data Mesh implique un changement organisationnel qui depasse le perimetre de la DSI.
- **Investissement plateforme** : la plateforme en self-service est un prerequis — sans elle, la decentralisation mene au chaos.
### Ce que le Data Mesh n'est pas
- **Ce n'est pas une technologie** : c'est un paradigme organisationnel et architectural. Aucun outil ne "fait du Data Mesh" tout seul.
- **Ce n'est pas l'absence de gouvernance** : la decentralisation ne signifie pas l'anarchie. La gouvernance federee est aussi structuree que la gouvernance centralisee, mais distribuee differemment.
- **Ce n'est pas incompatible avec un data warehouse** : un domaine peut tres bien publier ses Data Products dans un data warehouse partage, a condition de respecter les standards globaux.
### En pratique
Les organisations qui adoptent le Data Mesh procedent generalement de maniere incrementale : elles commencent par un ou deux domaines pilotes, mettent en place la plateforme self-service, definissent les premiers standards de gouvernance, puis etendent progressivement. La transition complete prend generalement 18 a 36 mois selon la taille de l'organisation.
---
### Qu'est-ce qu'une Data Platform ?
Source : https://www.hymaia.com/qu-est-ce-que/data-platform/
Une Data Platform est l'ensemble des outils, services et infrastructure qui permettent de collecter, stocker, transformer, analyser et distribuer les donnees au sein d'une organisation. C'est le socle technique de toute strategie data.
Une **Data Platform** est l'environnement technologique qui centralise les capacites de gestion des donnees d'une organisation. Elle fournit les briques reutilisables — stockage, traitement, orchestration, gouvernance, distribution — qui permettent aux equipes de construire des produits data sans repartir de zero a chaque projet.
### Les 6 fonctions d'une Data Platform
#### 1. Collecte et ingestion
La plateforme integre les donnees provenant de sources heterogenes : bases de donnees operationnelles, API tierces, fichiers, flux d'evenements, IoT. L'ingestion peut fonctionner en mode **batch** (traitements planifies, typiquement nocturnes) ou en mode streaming (traitement en temps reel ou quasi-reel). Les outils courants incluent Airbyte, Fivetran, Kafka, ou des connecteurs natifs des cloud providers.
#### 2. Stockage
Les donnees sont stockees selon leur nature et leur usage :
- **Data Lake** : stockage brut, a faible cout, qui conserve les donnees dans leur format d'origine. Convient aux donnees non structurees et aux volumes massifs.
- **Data Warehouse** : stockage structure et optimise pour les requetes analytiques. BigQuery (GCP), Snowflake, Redshift (**AWS**), Databricks.
- **Lakehouse** : architecture hybride qui combine la flexibilite du data lake avec les performances du data warehouse. Delta Lake et Apache Iceberg sont les formats de table dominants.
#### 3. Transformation
Les donnees brutes sont nettoyees, enrichies, agregees et modelisees pour etre exploitables. **dbt** (data build tool) s'est impose comme le standard pour les transformations SQL dans le data warehouse. Pour les traitements distribues a grande echelle, **Spark** reste la reference. Les **Analytics Engineers** sont les principaux utilisateurs de cette couche.
#### 4. Analyse et exploration
La plateforme fournit les interfaces pour explorer et analyser les donnees : requetes SQL, notebooks (Jupyter, Databricks), outils BI (Looker, Metabase, Tableau, Power BI). C'est la couche qui rend les donnees accessibles aux **Data Analysts** et aux equipes metier.
#### 5. Gouvernance et securite
Gestion des acces (qui peut voir quoi), catalogue de donnees (quelles donnees existent et ou), **Data Lineage** (d'ou viennent les donnees et comment elles sont transformees), qualite des donnees (controles automatises). Cette couche materialise les politiques de **Data Governance** de l'organisation.
#### 6. Distribution et serving
Les donnees traitees sont mises a disposition de leurs consommateurs : dashboards pour le reporting, API pour les applications, Feature Stores pour les modeles de Machine Learning, exports pour les partenaires. Dans une approche **Data as a Product**, chaque jeu de donnees est distribue avec sa documentation, ses SLA et son interface standardisee.
### Data Platform et Modern Data Stack
Le **Modern Data Stack** designe l'ensemble des outils cloud-native qui composent une Data Platform contemporaine. Ses caracteristiques :
- **Cloud-native** : heberge sur **AWS**, GCP ou Azure, avec facturation a l'usage et scalabilite elastique.
- **Modulaire** : chaque fonction est assuree par un outil specialise (best-of-breed), plutot que par une suite monolithique.
- **SQL-first** : SQL comme lingua franca, rendant les donnees accessibles a un public plus large que les seuls developpeurs.
- **Versionne** : le code de transformation (dbt), l'infrastructure (Terraform) et les configurations sont geres en Git.
### Data Platform et Data Mesh
Dans une architecture **Data Mesh**, la Data Platform joue un role specifique : elle devient une plateforme en self-service que les equipes de domaine utilisent en autonomie pour construire et publier leurs Data Products. L'equipe plateforme ne construit pas les pipelines des domaines — elle fournit les outils, les templates et les guardrails pour que les domaines le fassent eux-memes.
Ce modele change le role des **Data Engineers** : certains travaillent sur la plateforme (infrastructure, tooling), d'autres au sein des domaines metier (pipelines, Data Products).
### Comment dimensionner sa Data Platform
Le choix d'architecture depend de plusieurs facteurs :
- **Volume et variete des donnees** : quelques tables relationnelles vs des petaoctets de donnees non structurees.
- **Nombre d'utilisateurs** : 5 analystes vs 500 consommateurs de donnees.
- **Latence attendue** : reporting J+1 vs tableaux de bord temps reel.
- **Competences disponibles** : une equipe qui maitrise SQL n'a pas les memes besoins qu'une equipe qui fait du Spark distribue.
- **Budget** : les solutions managees (Snowflake, Databricks) reduisent l'effort d'operation mais coutent plus cher a l'echelle. Les solutions open source (dbt Core, Airflow, Trino) offrent plus de controle mais necessitent des competences d'operation.
L'erreur courante est de sur-dimensionner la plateforme par rapport aux besoins reels. Une Data Platform efficace commence simple et evolue avec les usages.
---
### Qu'est-ce qu'un Data Product Manager ?
Source : https://www.hymaia.com/qu-est-ce-que/data-product-manager/
Le Data Product Manager pilote la strategie et la roadmap des produits fondes sur les donnees. Il combine expertise produit, comprehension des donnees et vision business pour maximiser la valeur creee.
Le **Data Product Manager** (DPM) est un professionnel du Product Management specialise dans les produits qui exploitent les donnees comme levier principal de creation de valeur. Son role est de definir la vision, la strategie et la roadmap d'un produit data, en s'assurant qu'il resout un vrai probleme pour ses utilisateurs.
### Ce que fait un Data Product Manager au quotidien
Le DPM intervient a l'intersection des equipes metier, des equipes data et de la direction. Ses responsabilites couvrent plusieurs dimensions :
- **Discovery et cadrage** : identifier les problemes que les donnees peuvent resoudre, qualifier les opportunites, evaluer la faisabilite technique et la valeur business. Avant de construire, le DPM valide que le probleme existe et que les donnees necessaires sont accessibles.
- **Definition du produit** : rediger les specifications fonctionnelles, definir le MVP (Minimum Viable Product), prioriser les fonctionnalites selon leur impact et leur faisabilite. Le DPM traduit les besoins metier en exigences comprehensibles par les equipes techniques.
- **Pilotage de la roadmap** : arbitrer entre les demandes des differentes parties prenantes, gerer les dependances techniques (qualite des donnees, disponibilite des modeles), et planifier les iterations.
- **Mesure de la performance** : definir les KPI du produit data, suivre l'adoption, analyser les retours utilisateurs et iterer en consequence. Un produit data qui n'est pas utilise n'a pas de valeur, quelle que soit sa sophistication technique.
- **Communication** : servir de porte-parole du produit aupres de la direction, des equipes metier et des equipes techniques. Expliquer les choix, les contraintes et les resultats dans un langage adapte a chaque audience.
### Difference avec un Product Manager classique
Le **Product Manager** classique gere des produits logiciels (application mobile, plateforme SaaS, outil interne). Le Data Product Manager partage les memes fondamentaux (discovery, delivery, mesure) mais fait face a des specificites :
- **Incertitude technique plus elevee** : la faisabilite d'un produit data depend de la qualite et de la disponibilite des donnees, qui sont souvent imprevisibles. Un modele de Machine Learning peut ne pas atteindre les performances attendues malgre des mois de travail.
- **Boucle de feedback plus longue** : les effets d'un produit data (meilleure precision de prevision, reduction du churn) se mesurent souvent sur des semaines ou des mois, pas des jours.
- **Equipe pluridisciplinaire** : le DPM travaille avec des Data Engineers, des Data Scientists, des **Data Analysts**, des ML Engineers — des profils dont les contraintes et les methodes different des developpeurs logiciels classiques.
- **Gouvernance des donnees** : le DPM doit integrer les enjeux de **Data Governance** (qualite, confidentialite, conformite) dans ses decisions produit.
### Difference avec un AI Product Manager
L'**AI Product Manager** est une specialisation supplementaire : il gere des produits qui integrent de l'IA (modeles predictifs, IA generative, systemes de recommandation). Tous les AI Product Managers sont des Data Product Managers, mais l'inverse n'est pas vrai. Le DPM peut gerer des produits data qui ne font pas appel a l'IA : dashboards, data products internes, outils d'analytics en self-service.
### Competences cles
Un Data Product Manager efficace combine plusieurs types de competences :
- **Product Management** : discovery, priorisation, roadmap, mesure d'impact. Les fondamentaux du metier de PM s'appliquent directement.
- **Comprehension des donnees** : savoir lire un schema de donnees, comprendre les enjeux de qualite, evaluer la faisabilite d'un cas d'usage. Le DPM n'a pas besoin de coder, mais doit pouvoir dialoguer avec les equipes techniques sans intermediaire.
- **Vision business** : relier les produits data aux objectifs strategiques de l'organisation. Un produit data justifie son existence par la valeur business qu'il cree, pas par sa complexite technique.
- **Communication et influence** : convaincre la direction d'investir, aligner les equipes metier sur les priorites, negocier les arbitrages avec les equipes techniques.
### Le DPM dans une approche Data as a Product
Dans une organisation qui adopte le paradigme **Data as a Product**, le Data Product Manager prend une dimension supplementaire : il ne gere plus seulement un produit pour des utilisateurs finaux, mais aussi des Data Products internes — des jeux de donnees traites comme des produits, avec des consommateurs identifies, des SLA de qualite et des interfaces standardisees.
Ce positionnement le rapproche du **Data Steward** (qui garantit la qualite et la conformite) et du **Data Strategist** (qui definit la vision data de l'organisation), tout en restant ancre dans l'execution produit.
### Impact sur les produits data
Les organisations qui dotent leurs produits data d'un DPM dedie constatent generalement une meilleure adoption par les utilisateurs finaux, une reduction du "build it and they will come" (construire un modele que personne n'utilise), et une capacite accrue a demontrer le ROI des investissements data.
La clef de son impact : le DPM s'assure que chaque produit data resout un probleme reel, mesurable, pour un utilisateur identifie — plutot que d'etre un exercice technique deconnecte des besoins metier.
---
### Qu'est-ce qu'un Data Steward ?
Source : https://www.hymaia.com/qu-est-ce-que/data-steward/
Le Data Steward est le garant de la qualite des donnees au sein d'une organisation. Responsable du glossaire business et du Data Catalog, il est le premier point de contact pour tous les utilisateurs de donnees.
Iindividu chargé de veiller à la qualité des données et des processus qui assurent leur contrôle et leur utilisation efficace au sein d'une organisation. Leur rôle principal est de garantir que les données sont précises, fiables, sécurisées et conformes aux normes et aux politiques de l'entreprise.
Parmi les responsabilités spécifiques d'un Data Steward, on trouve :
1. **Gestion de la qualité des données** : Assurer la qualité des données en identifiant et en corrigeant les erreurs, les incohérences et les duplications dans les jeux de données.
2. **Maintenance du glossaire des données** : Développer et maintenir un glossaire des données décrivant les définitions, les sources, les métadonnées et les règles de gouvernance des données.
3. **Contrôle d'accès aux données** : Gérer les autorisations d'accès aux données pour s'assurer que seules les personnes autorisées peuvent accéder aux informations sensibles.
4. **Gestion des métadonnées** : Collecter, documenter et maintenir les métadonnées des données pour faciliter leur découverte, leur compréhension et leur utilisation.
5. **Assistance aux utilisateurs de données** : Fournir un support et une formation aux utilisateurs de données sur l'utilisation des outils et des processus liés aux données, ainsi que sur l'interprétation des données.
6. **Utilisation du Data Catalog** : Utiliser des outils de catalogage des données, tels que les Data Catalogs, pour organiser, cataloguer et rechercher les ensembles de données disponibles dans l'entreprise.
En tant que premier point de contact pour les questions liées aux données, les Data Stewards jouent un rôle crucial dans la promotion d'une culture axée sur les données et dans l'amélioration continue de la qualité et de la valeur des données au sein de l'organisation.
---
### Qu'est-ce que le Data Storytelling ?
Source : https://www.hymaia.com/qu-est-ce-que/data-storytelling/
Le Data Storytelling est l'art de transformer des donnees en recits convaincants. En combinant donnees, narration et visualisation, il rend les analyses accessibles et actionables pour tous les publics.
Le **Data Storytelling** (Narration de données) est une méthode de communication qui consiste à raconter des histoires en utilisant des données pour transmettre un message ou une idée. Plutôt que de simplement présenter des faits et des chiffres de manière brute, le data storytelling intègre les données dans une narration captivante, mettant en lumière des insights significatifs et permettant au public de mieux comprendre et d'apprécier les informations présentées.
Cette approche combine des éléments narratifs traditionnels tels que le début, le milieu et la fin avec des données visuelles telles que des graphiques, des tableaux et des visualisations interactives pour créer une expérience immersive. Le data storytelling peut être utilisé dans divers domaines, y compris le marketing, la prise de décision stratégique, la communication scientifique et l'éducation, pour rendre les données plus accessibles, persuasives et mémorables. En racontant des histoires avec des données, les organisations peuvent engager leur public de manière plus efficace, influencer les opinions et inspirer l'action.
---
### Qu'est-ce qu'un Data Strategist ?
Source : https://www.hymaia.com/qu-est-ce-que/data-strategist/
Le Data Strategist definit et pilote la strategie data d'une entreprise. Il aligne les initiatives data avec les objectifs business pour maximiser la creation de valeur a partir des donnees.
Concrètement, que fait un Data Strategist ? 🤔
1. Architecte de la Vision
- Définit la feuille de route data alignée avec la stratégie business
- Identifie les cas d'usage à fort impact
- Construit le "cockpit de pilotage" de la stratégie data
2. Créateur de Ponts
- Aligne les équipes techniques et métiers
- Traduit les besoins business en solutions data
- Facilite la communication entre tous les stakeholders
3. Gardien de la Valeur
- Mesure l'impact des initiatives data
- Assure la conformité et la gouvernance
- Optimise le ROI des investissements data
4. Catalyseur de Transformation
- Accompagne le changement culturel
- Développe les compétences data dans l'organisation
- Promeut une approche data-driven
---
### Qu'est-ce que dbt (data build tool) ?
Source : https://www.hymaia.com/qu-est-ce-que/dbt/
dbt (data build tool) est un outil open source de transformation de donnees qui permet aux Analytics Engineers d'appliquer les bonnes pratiques du genie logiciel (versioning, tests, documentation) a leurs pipelines SQL.
**DBT** est un outil de transformation de données conçu pour simplifier le processus de création et de gestion des requêtes SQL. Principalement destiné aux Data Engineers et aux Analytics Engineers, dbt facilite l'application des meilleures pratiques du génie logiciel dans le domaine de l'analyse de données. Avec dbt, les équipes peuvent adopter des méthodes de travail telles que le versioning, les tests automatisés et la documentation technique pour garantir la qualité et la fiabilité de leurs pipelines de données.
En utilisant dbt, les professionnels des données peuvent structurer leurs transformations de données sous forme de modèles modulaires et réutilisables, ce qui favorise la collaboration et la réutilisation du code. De plus, dbt offre des fonctionnalités intégrées pour la gestion des dépendances, ce qui simplifie la gestion des pipelines complexes. En incorporant des tests automatisés dans leurs workflows, les utilisateurs peuvent s'assurer que les transformations de données produisent des résultats cohérents et fiables. Enfin, dbt facilite la documentation des processus et des décisions prises lors de la transformation des données, ce qui améliore la transparence et la compréhension au sein des équipes.
En résumé, dbt est un outil puissant qui permet aux Data Engineers et aux Analytics Engineers d'appliquer les principes du génie logiciel à leurs workflows d'analyse de données, ce qui se traduit par des pipelines de données plus robustes, plus fiables et plus faciles à gérer.
---
### Qu'est-ce que les données synthétiques ?
Source : https://www.hymaia.com/qu-est-ce-que/donnees-synthetiques/
Les données synthétiques sont des données générées artificiellement qui reproduisent les propriétés statistiques de données réelles sans contenir d'informations personnelles. Elles servent à entraîner des modèles IA, tester des systèmes ou partager des datasets dans le respect de la vie privée.
Les **données synthétiques** (synthetic data) sont des données produites artificiellement par des algorithmes — et non collectées à partir d'événements réels — qui reproduisent les propriétés statistiques, les distributions et les corrélations d'un jeu de données existant. Elles ressemblent aux données réelles, se comportent comme les données réelles, mais ne correspondent à aucun individu ou événement réel.
### Pourquoi générer des données artificielles ?
La question semble contre-intuitive : si on a besoin de données, pourquoi ne pas utiliser les vraies ? Plusieurs raisons expliquent l'essor des données synthétiques :
**La protection de la vie privée.** Les réglementations comme le RGPD imposent des contraintes strictes sur l'utilisation des données personnelles. Les données synthétiques permettent de travailler avec des datasets réalistes sans exposer d'informations personnelles identifiables. Un hôpital peut partager un dataset synthétique de patients pour la recherche sans risquer de violation de la vie privée.
**La rareté des données.** Certains cas d'usage manquent cruellement de données d'entraînement : événements rares (fraudes, pannes critiques, maladies rares), cas limites (edge cases) que les modèles doivent pourtant savoir traiter, ou nouvelles catégories de produits pour lesquelles aucun historique n'existe.
**Le coût de la collecte.** Collecter et annoter des données réelles peut être extrêmement coûteux et chronophage. En vision par ordinateur, annoter manuellement des milliers d'images pour entraîner un modèle de détection d'objets prend des semaines. Générer des images synthétiques annotées automatiquement prend quelques heures.
**Le testing et le développement.** Les équipes de développement ont besoin de données réalistes pour tester leurs pipelines, sans pouvoir — pour des raisons de sécurité et de conformité — utiliser des données de production. Les données synthétiques offrent une alternative fiable.
### Comment génère-t-on des données synthétiques ?
Plusieurs techniques existent, adaptées à différents types de données :
**Les modèles génératifs.** Les GAN (Generative Adversarial Networks) et les VAE (Variational Autoencoders) apprennent la distribution statistique d'un dataset réel et génèrent de nouveaux échantillons qui suivent la même distribution. Ces approches sont particulièrement efficaces pour les données tabulaires et les images.
**Les modèles de langage.** Pour les données textuelles, les LLM (Large Language Models) peuvent générer des conversations, des tickets de support, des avis clients ou des documents qui reproduisent les patterns linguistiques d'un corpus réel. L'**IA Générative** a considérablement élargi les possibilités dans ce domaine.
**La simulation.** Pour les données physiques (trajectoires de véhicules, comportements de capteurs, dynamiques de fluides), des simulateurs construits sur des modèles physiques génèrent des données réalistes. C'est l'approche dominante dans l'industrie automobile pour l'entraînement de la conduite autonome.
**Les approches basées sur des règles.** Pour des données structurées simples, des règles de génération (distributions statistiques, contraintes métier, relations entre champs) suffisent parfois. C'est l'approche la plus simple et la plus contrôlable.
### Les défis de la qualité
Les données synthétiques ne sont pas sans risques :
**La fidélité statistique.** Si le générateur ne capture pas correctement les corrélations subtiles du dataset réel, les modèles entraînés sur les données synthétiques auront des performances dégradées en production. Évaluer cette fidélité est un problème technique non trivial.
**L'amplification des biais.** Un générateur entraîné sur des données biaisées produira des données synthétiques tout aussi biaisées. Les données synthétiques ne résolvent pas magiquement les problèmes de biais — elles peuvent même les masquer en donnant l'illusion d'un dataset "propre".
**Le risque de mémorisation.** Certains modèles génératifs, notamment les GAN, peuvent mémoriser et reproduire des échantillons individuels du dataset d'entraînement, compromettant ainsi la promesse de respect de la vie privée. Des techniques de differential privacy permettent de quantifier et limiter ce risque.
**La validation.** Comment s'assurer que les données synthétiques sont suffisamment fidèles pour être utiles, tout en étant suffisamment différentes pour protéger la vie privée ? Cet équilibre nécessite des métriques de validation rigoureuses.
### Données synthétiques et écosystème data
Les données synthétiques s'intègrent dans l'écosystème data à plusieurs niveaux. Au sein d'une **Data Platform**, elles peuvent alimenter des environnements de développement et de test. Dans un cadre de **Data Governance**, elles offrent un mécanisme de partage de données conforme aux réglementations. Pour les **Feature Stores**, elles permettent d'enrichir les features d'entraînement quand les données réelles sont insuffisantes.
### Cas d'usage concrets
- **Santé** : génération de dossiers médicaux synthétiques pour la recherche clinique sans exposer de données patients.
- **Finance** : simulation de transactions frauduleuses pour entraîner des modèles de détection de fraude, alors que les cas réels sont rares par nature.
- **Automobile** : simulation de millions de scénarios de conduite pour les systèmes de conduite autonome — Waymo utilise massivement cette approche.
- **Fine-tuning de LLM** : génération de paires question/réponse synthétiques pour adapter un modèle de langage à un domaine spécifique.
---
### Quels sont les principaux ecueils Data en entreprise ?
Source : https://www.hymaia.com/qu-est-ce-que/ecueils-data/
Les ecueils Data sont les pieges recurrents qui empechent les organisations d'exploiter leurs donnees a l'echelle. Ils se repartissent en trois categories : organisationnels, methodologiques et techniques.
Dans le contexte de la transformation vers une organisation centrée sur les données (Data Centric), plusieurs défis majeurs peuvent entraver le passage à l'échelle de l'utilisation des données. Ces obstacles peuvent être organisés en trois catégories principales :
**Écueils Organisationnels** :
- **Perception des équipes Data** : Voir les équipes Data uniquement comme des fournisseurs de services plutôt que comme des partenaires stratégiques.
- **Diversité de l'équipe Data** : Manquer de diversité dans les compétences et les perspectives au sein des équipes Data, ce qui peut limiter la capacité d'innovation et d'adaptation.
- **Culture Data limitée** : Croire que la culture Data se limite à l'équipe Data et ne pas l'étendre à toute l'organisation.
- **Investissement dans l'équipe Data** : Négliger d'investir dans le développement des compétences et des ressources de l'équipe Data.
**Écueils Méthodologiques** :
- **Complexité prématurée** : Se lancer dans des cas d'utilisation complexes sans avoir les bases nécessaires.
- **Piège du PoC infini** : Prolonger indéfiniment la phase de preuve de concept (PoC) sans passer à l'échelle.
- **Biais internes** : Être influencé par ses propres biais lors de l'analyse et de l'interprétation des données.
**Écueils Techniques** :
- **Confiance excessive en la qualité des données** : Présumer que les données sont fiables sans investir dans des mécanismes de vérification de leur qualité.
- **Négligence des pratiques de génie logiciel** : Ignorer les bonnes pratiques de développement logiciel dans la gestion des projets Data.
- **Vision à court terme** : Concevoir des solutions de machine learning sans penser à leur maintenance et à leur évolutivité à long terme.
Chacun de ces écueils peut compromettre la capacité d'une organisation à exploiter pleinement le potentiel des données. Reconnaître et adresser proactivement ces obstacles est essentiel pour réussir la transition vers une approche plus centrée sur les données, permettant ainsi de prendre des décisions éclairées et d'améliorer l'efficacité globale.
Pour en savoir plus, procurez-vous notre Ebook, _les 10 Ecueils limitant l'impact de la Data sur les produits et organisations_ :
---
### Qu'est-ce qu'un embedding en IA ?
Source : https://www.hymaia.com/qu-est-ce-que/embedding/
Un embedding est une représentation numérique d'une donnée (texte, image, audio) sous forme de vecteur dans un espace mathématique. Les embeddings capturent le sens sémantique des données et mesurent la similarité entre elles, ce qui les rend indispensables au RAG et à la recherche sémantique.
Un **embedding** est un vecteur -- une liste ordonnée de nombres -- qui représente une donnée dans un espace mathématique de haute dimension. L'idée fondamentale : transformer du contenu non structuré (un mot, une phrase, une image) en une représentation numérique où la proximité géométrique reflète la proximité sémantique.
### Le principe : du sens aux nombres
Prenons un exemple concret. Le mot "roi" et le mot "reine" sont sémantiquement proches : ils désignent tous deux un monarque. Un modèle d'embedding va les transformer en vecteurs qui seront proches dans l'espace mathématique. À l'inverse, "roi" et "tomate" produiront des vecteurs éloignés.
Ce qui rend les embeddings puissants, c'est qu'ils capturent des relations plus subtiles. L'exemple classique, mis en évidence par les travaux de Tomas Mikolov chez Google en 2013 avec Word2Vec, montre que les opérations arithmétiques sur les vecteurs reflètent des relations sémantiques : vecteur("roi") - vecteur("homme") + vecteur("femme") donne un vecteur très proche de vecteur("reine").
### Comment sont générés les embeddings
Les embeddings modernes sont produits par des réseaux de neurones entraînés sur de grandes quantités de données. Le modèle apprend à placer les concepts similaires près les uns des autres dans l'espace vectoriel.
**Pour le texte :**
- **Word2Vec** (2013) : un des premiers modèles à produire des embeddings de mots de qualité. Entraîné sur des corpus de texte pour prédire les mots voisins.
- **Sentence-BERT** (2019) : adapte l'architecture BERT pour produire des embeddings de phrases entières, pas juste de mots individuels.
- **text-embedding-ada-002 / text-embedding-3-small** (OpenAI) : modèles commerciaux largement utilisés, produisant des vecteurs de 1 536 ou 3 072 dimensions.
- **Cohere Embed** : alternative qui supporte nativement le multilangue.
- **BGE, E5, GTE** : modèles open source performants, souvent en tête des benchmarks MTEB.
**Pour les images et le multimodal :**
- **CLIP** (OpenAI, 2021) : projette texte et images dans le même espace vectoriel, permettant de chercher des images avec du texte et inversement.
- **ImageBind** (Meta) : étend ce principe à six modalités (texte, image, audio, vidéo, profondeur, thermique).
### Les dimensions d'un embedding
Un embedding est défini par son nombre de dimensions -- typiquement entre 384 et 3 072 pour les modèles textuels actuels. Plus il y a de dimensions, plus le modèle peut encoder de nuances sémantiques, mais au prix d'un stockage et d'un calcul plus importants.
Le choix du nombre de dimensions est un compromis entre précision et performance. Pour un prototype, un modèle à 384 dimensions comme all-MiniLM-L6-v2 suffit souvent. Pour de la production exigeante, des modèles à 1 536 ou 3 072 dimensions offrent une meilleure granularité.
### Les mesures de similarité
Une fois les données transformées en vecteurs, on mesure leur proximité avec des métriques mathématiques :
- **Similarité cosinus** : mesure l'angle entre deux vecteurs, indépendamment de leur longueur. C'est la métrique la plus utilisée pour les embeddings textuels.
- **Distance euclidienne** : mesure la distance "en ligne droite" entre deux points. Utile quand la magnitude du vecteur porte de l'information.
- **Produit scalaire (dot product)** : rapide à calculer, souvent utilisé quand les vecteurs sont normalisés.
### Les cas d'usage concrets
**Recherche sémantique.** Au lieu de chercher des mots-clés exacts, on cherche par le sens. Un utilisateur qui tape "comment réduire le turnover" trouvera des documents parlant de "fidélisation des talents" ou de "rétention des collaborateurs".
**RAG (Retrieval-Augmented Generation).** Les embeddings sont la brique de base du RAG : on transforme les documents et la question en embeddings, on trouve les documents les plus proches dans une base de données vectorielle, puis on les injecte dans le contexte du LLM.
**Classification et clustering.** Regrouper automatiquement des tickets de support, des avis clients ou des articles par thème, sans définir de catégories à l'avance.
**Détection d'anomalies.** Identifier des contenus inhabituels en repérant les vecteurs isolés, éloignés de tous les clusters existants.
**Systèmes de recommandation.** Recommander des produits, articles ou contenus similaires à ce que l'utilisateur a déjà consulté.
### Limites et points d'attention
Les embeddings ne sont pas sans limites. Ils héritent des biais présents dans les données d'entraînement. Ils peinent à capturer la négation ("ce film est bon" et "ce film n'est pas bon" peuvent produire des vecteurs proches). Et la qualité des embeddings dépend fortement du domaine : un modèle généraliste sera moins performant qu'un modèle fine-tuné sur des données métier spécifiques.
C'est pourquoi le context engineering intègre le choix et l'évaluation du modèle d'embedding comme une décision architecturale à part entière, au même titre que le choix du LLM.
---
### Qu'est-ce que l'évaluation IA (evals) ?
Source : https://www.hymaia.com/qu-est-ce-que/evaluation-ia/
L'évaluation IA désigne les méthodes et métriques pour mesurer la qualité et la fiabilité des systèmes d'IA, en particulier les LLM. Elle couvre les benchmarks, les évaluations automatisées (LLM-as-a-judge), les évaluations humaines et les métriques spécifiques au RAG.
L'**évaluation IA** (souvent abrégée en "evals") regroupe les pratiques qui permettent de répondre à une question simple mais difficile : est-ce que mon système d'IA fait bien son travail ? Pour les modèles de machine learning classiques, des métriques établies existent (precision, recall, F1-score). Pour les LLM, la question est plus complexe car les sorties sont du texte libre, et la notion de "bonne réponse" est souvent subjective.
### Pourquoi l'évaluation des LLM est un défi spécifique
Un modèle de classification renvoie une étiquette parmi un ensemble fixe : on peut comparer directement à la vérité terrain. Un LLM produit du texte en langage naturel, avec une infinité de formulations possibles pour une même réponse correcte. "Paris est la capitale de la France", "La capitale française est Paris" et "C'est Paris qui sert de capitale à la France" sont trois réponses équivalentes mais textuellement différentes.
Cette non-déterminisme rend les approches d'évaluation traditionnelles insuffisantes. L'évaluation IA pour les LLM a dû inventer de nouveaux paradigmes.
### Les trois piliers de l'évaluation
**1\. Les benchmarks standardisés**
Les benchmarks mesurent les capacités générales d'un modèle sur des jeux de tests publics. Parmi les plus utilisés :
- **MMLU** (Massive Multitask Language Understanding) : 57 domaines de connaissances, du droit à la biologie.
- **HumanEval** : évaluation de la capacité à générer du code fonctionnel.
- **GSM8K** : raisonnement mathématique sur des problèmes de niveau collège.
- **TruthfulQA** : mesure la tendance du modèle à générer des affirmations fausses mais plausibles.
- **MTEB** (Massive Text Embedding Benchmark) : compare la qualité des modèles d'embedding.
Les benchmarks sont utiles pour comparer des modèles entre eux, mais insuffisants pour évaluer un système en production. Un modèle qui excelle sur MMLU peut échouer sur les cas d'usage spécifiques d'une entreprise.
**2\. Les évaluations automatisées (LLM-as-a-judge)**
L'approche "LLM-as-a-judge" utilise un LLM pour évaluer les réponses d'un autre LLM (ou du même modèle). On fournit au modèle juge la question, la réponse générée, éventuellement les sources et les critères d'évaluation, et on lui demande de noter la réponse.
Cette méthode, popularisée par des travaux de recherche en 2023-2024, est devenue un standard de l'industrie. Elle permet d'évaluer des milliers de réponses à faible coût, avec une corrélation raisonnable aux jugements humains quand les critères sont bien définis.
Les critères courants :
- **Pertinence** : la réponse répond-elle à la question posée ?
- **Fidélité** (faithfulness) : la réponse est-elle cohérente avec les sources fournies ?
- **Complétude** : la réponse couvre-t-elle tous les aspects de la question ?
- **Concision** : la réponse évite-t-elle le remplissage inutile ?
- **Ton et style** : la réponse respecte-t-elle les consignes de communication ?
**3\. Les évaluations humaines**
Malgré les progrès des evals automatisées, l'évaluation humaine reste le gold standard pour les aspects qualitatifs : le ton est-il naturel ? La réponse inspire-t-elle confiance ? Le raisonnement est-il convaincant ?
Les évaluations humaines sont coûteuses et lentes, donc réservées à un échantillon représentatif. On les combine typiquement avec des evals automatisées : les evals auto couvrent 100 % du trafic, les evals humaines valident un échantillon pour calibrer les evals auto.
### Métriques spécifiques au RAG
Les systèmes RAG introduisent des métriques d'évaluation supplémentaires, car la qualité dépend à la fois de la récupération des documents et de la génération de la réponse :
- **Context Precision** : les documents récupérés sont-ils pertinents pour la question ?
- **Context Recall** : a-t-on récupéré tous les documents nécessaires ?
- **Faithfulness** : la réponse générée est-elle fidèle aux documents récupérés (pas d'hallucination) ?
- **Answer Relevancy** : la réponse répond-elle effectivement à la question ?
Des frameworks comme RAGAS et DeepEval automatisent le calcul de ces métriques et s'intègrent dans les pipelines de LLMOps.
### L'évaluation en pratique
Pour un AI Product Manager ou une équipe d'ingénierie, mettre en place une stratégie d'évaluation implique :
1\. **Définir les critères** : qu'est-ce qu'une "bonne réponse" pour ce cas d'usage spécifique ?
2\. **Construire un jeu de test** : un ensemble de questions avec des réponses de référence (gold standard), représentatif des cas d'usage réels.
3\. **Automatiser les evals** : intégrer les évaluations dans le pipeline CI/CD pour détecter les régressions à chaque changement de prompt ou de configuration.
4\. **Monitorer en production** : collecter le feedback utilisateur et les métriques de qualité en continu.
5\. **Itérer** : les critères d'évaluation évoluent avec les retours terrain.
L'évaluation n'est pas une étape finale, c'est un processus continu qui s'intègre dans le cycle de vie LLMOps. Sans évaluation rigoureuse, déployer un LLM en production revient à naviguer sans instruments.
---
### Qu'est-ce qu'un Feature Store ?
Source : https://www.hymaia.com/qu-est-ce-que/feature-store/
Un Feature Store est une plateforme qui centralise le stockage, la gestion et le partage des features utilisees pour entrainer et servir des modeles de Machine Learning, en garantissant la coherence entre entrainement et production.
Composante centrale dans l'architecture de machine learning moderne, conçue pour centraliser la gestion des features (attributs ou caractéristiques) utilisées dans les modèles de machine learning. Il s'agit d'une base de données spécialisée qui permet de stocker, de partager et de gérer de manière efficace les données de features, en assurant la cohérence entre les données utilisées pour l'entraînement des modèles et celles utilisées en production.
Le Feature Store facilite le réutilisage des features entre différents projets de machine learning, réduit les efforts de duplication, et aide à maintenir la qualité et la traçabilité des données. Il permet également une mise à jour en temps réel des features, supportant ainsi des applications de machine learning en temps réel. En centralisant les features, il favorise une collaboration plus étroite entre les data scientists et les ingénieurs en machine learning, et améliore la scalabilité et la performance des projets de machine learning au sein de l'entreprise.
---
### Qu'est-ce que le fine-tuning d'un modèle d'IA ?
Source : https://www.hymaia.com/qu-est-ce-que/fine-tuning/
Le fine-tuning est le processus d'adaptation d'un modèle de langage pré-entraîné (LLM) à un domaine ou une tâche spécifique, en le réentraînant sur un jeu de données ciblé. Il permet d'obtenir un modèle spécialisé sans supporter le coût d'un entraînement complet.
Le **fine-tuning** est une technique d'apprentissage par transfert (transfer learning) qui consiste à prendre un modèle de langage déjà entraîné sur un large corpus généraliste et à poursuivre son entraînement sur un jeu de données plus restreint et spécialisé. L'objectif : adapter le comportement du modèle — son style, sa terminologie, son format de réponse, ou sa maîtrise d'un domaine — sans repartir de zéro.
### Le principe : s'appuyer sur l'existant
Entraîner un LLM from scratch coûte des millions de dollars et nécessite des milliards de tokens de données. Le fine-tuning permet de capitaliser sur cet investissement initial. Le modèle pré-entraîné a déjà acquis une compréhension profonde du langage, des connaissances générales et des capacités de raisonnement. Le fine-tuning ajuste ces capacités pour un contexte spécifique.
L'analogie classique : le pré-entraînement donne au modèle une éducation générale (lycée + université), le fine-tuning lui apporte une spécialisation professionnelle.
### Types de fine-tuning
**Supervised Fine-Tuning (SFT).** La forme la plus courante. On fournit au modèle des paires (instruction, réponse attendue) et on l'entraîne à reproduire ces réponses. Par exemple, pour un assistant juridique, on utiliserait des centaines ou milliers de paires question juridique / réponse experte. Le modèle apprend le style, la terminologie et le niveau de précision attendu.
**RLHF (Reinforcement Learning from Human Feedback).** Utilisé pour aligner le comportement du modèle sur les préférences humaines. Des annotateurs comparent et classent plusieurs réponses du modèle, et un modèle de récompense est entraîné à partir de ces préférences. C'est la technique utilisée par OpenAI et Anthropic pour transformer leurs modèles de base en assistants conversationnels.
**DPO (Direct Preference Optimization).** Une alternative au RLHF qui simplifie le processus en éliminant le besoin d'un modèle de récompense séparé. Le modèle apprend directement à partir des préférences humaines exprimées sous forme de paires (réponse préférée, réponse rejetée).
### Fine-tuning efficace : les méthodes PEFT
Le fine-tuning complet — modifier tous les paramètres du modèle — est coûteux en calcul et en mémoire. Les méthodes PEFT (Parameter-Efficient Fine-Tuning) réduisent drastiquement ces coûts en ne modifiant qu'une petite fraction des paramètres.
**LoRA (Low-Rank Adaptation)** est la méthode PEFT la plus populaire. Au lieu de modifier les matrices de poids complètes du modèle, LoRA ajoute de petites matrices de faible rang qui capturent les adaptations nécessaires. Le résultat : un fine-tuning qui nécessite une fraction de la mémoire GPU et du temps de calcul, avec des résultats souvent comparables au fine-tuning complet.
**QLoRA** combine la quantification (réduction de la précision des poids) avec LoRA, permettant de fine-tuner des modèles de 70 milliards de paramètres sur un seul GPU consumer. Cette démocratisation technique a rendu le fine-tuning accessible à des équipes qui n'ont pas accès à des clusters de calcul.
### Quand fine-tuner (et quand ne pas le faire)
Le fine-tuning n'est pas toujours la bonne réponse. Une erreur courante est de fine-tuner pour résoudre un problème qui relèverait mieux du prompt engineering ou du RAG.
**Le fine-tuning est pertinent quand on veut :**
- Modifier le style ou le ton du modèle (écrire comme un rédacteur spécifique, adopter une terminologie métier).
- Améliorer la performance sur un format de sortie spécifique (JSON structuré, rapports normés, classifications).
- Réduire la latence en remplaçant un long prompt système par un comportement appris.
- Distiller les capacités d'un gros modèle vers un modèle plus petit et moins coûteux.
**Le RAG est préférable quand on veut :**
- Intégrer des connaissances factuelles qui évoluent (documentation, procédures, données métier).
- Fournir des réponses traçables avec des citations de sources.
- Respecter des contrôles d'accès sur les données.
En pratique, les architectures les plus robustes combinent les deux : un modèle fine-tuné pour le comportement et le style, alimenté par un pipeline RAG pour les connaissances factuelles.
### Les données, nerf de la guerre
La qualité du fine-tuning dépend directement de la qualité des données d'entraînement. Quelques centaines d'exemples de haute qualité produisent souvent de meilleurs résultats que des milliers d'exemples médiocres. La curation des données est l'étape la plus chronophage et la plus déterminante du processus.
Les données synthétiques — générées par un LLM plus puissant — sont de plus en plus utilisées pour constituer des jeux de fine-tuning. Un modèle comme GPT-4 ou Claude peut générer des exemples d'entraînement que l'on utilise ensuite pour fine-tuner un modèle plus petit et moins coûteux. Cette approche de distillation de modèle est devenue une pratique courante.
### L'évaluation post fine-tuning
Un modèle fine-tuné doit être évalué rigoureusement pour s'assurer qu'il a gagné en performance sur la tâche cible sans perdre ses capacités générales. Le phénomène de **catastrophic forgetting** — le modèle oublie ce qu'il savait en apprenant la nouvelle tâche — est un risque réel, surtout avec un fine-tuning agressif sur un petit jeu de données.
Les bonnes pratiques incluent l'évaluation sur des benchmarks généralistes en plus des métriques spécifiques à la tâche, et la conservation d'un jeu de test qui n'a jamais été vu pendant l'entraînement.
---
### Qu'est-ce que la Fresque de la Data et de l'IA ?
Source : https://www.hymaia.com/qu-est-ce-que/fresque-de-la-data/
La Fresque de la Data et de l'IA est un atelier collaboratif cree par Hymaia qui sensibilise les participants aux enjeux de la donnee et de l'intelligence artificielle a travers un format ludique et interactif.
La **Fresque de la Data** est un atelier collaboratif conçu chez Hymaïa destiné à familiariser les participants aux concepts fondamentaux de la Data. Cet atelier vise également à identifier et évaluer les risques associés à l'utilisation des données.
Tirant son inspiration de la Fresque du Climat, l'approche ludique et interactive, favorise les échanges et encourage la collaboration entre les participants. C'est une excellente occasion pour renforcer la cohésion et l'esprit d'équipe.
---
### Qu'est-ce que le GEO (Generative Engine Optimization) ?
Source : https://www.hymaia.com/qu-est-ce-que/geo-generative-engine-optimization/
Le GEO (Generative Engine Optimization) est l'optimisation de contenus pour être sélectionnés et cités par les moteurs de recherche génératifs comme Google AI Overviews, Perplexity ou ChatGPT Search. C'est l'évolution du SEO classique à l'ère de l'IA générative.
Le **GEO** (Generative Engine Optimization) désigne l'ensemble des pratiques visant à optimiser un contenu pour qu'il soit sélectionné, cité et restitué par les moteurs de réponse génératifs — ces systèmes qui, au lieu de renvoyer une liste de liens, génèrent directement une réponse synthétique à la question de l'utilisateur. Google AI Overviews, Perplexity, ChatGPT avec Browse/Search, Bing Copilot : ces interfaces transforment la manière dont l'information est découverte et consommée en ligne.
### Du SEO au GEO : ce qui change
Le SEO (Search Engine Optimization) classique vise à positionner une page dans les résultats de recherche de Google pour générer du trafic. Le GEO vise un objectif différent : être la source que le moteur génératif cite dans sa réponse. La distinction est fondamentale.
En SEO classique, l'utilisateur clique sur un lien et visite le site. Le trafic est le résultat. En GEO, l'utilisateur obtient sa réponse directement dans l'interface du moteur génératif, avec (parfois) une citation de la source. Le trafic n'est plus garanti — c'est la visibilité de la marque et l'autorité perçue qui deviennent les métriques clés.
Ce changement a des implications profondes. Quand Google affiche un AI Overview en haut de la page de résultats, les liens organiques classiques sont repoussés en dessous — et les taux de clic chutent. Les sites qui ne sont pas cités dans la réponse générée deviennent invisibles, même s'ils sont bien positionnés en SEO classique.
### Les principes du GEO
Les recherches émergentes sur le GEO — notamment celles de l'équipe de Stanford/Georgia Tech publiées en 2024 — identifient plusieurs leviers d'optimisation :
**La réponse directe aux questions.** Les moteurs génératifs cherchent des contenus qui répondent clairement et directement aux questions des utilisateurs. Les pages qui tournent autour du sujet sans donner de réponse précise sont moins susceptibles d'être sélectionnées. Cela implique de structurer le contenu autour de questions explicites et d'y répondre dès les premières phrases.
**Les citations et les sources.** Les contenus qui citent des sources vérifiables — études, rapports, données chiffrées, références académiques — sont davantage repris par les moteurs génératifs. La logique est simple : un moteur qui génère une réponse cherche des sources fiables pour la construire. Un contenu sourcé est perçu comme plus fiable qu'une opinion non étayée.
**La structure du contenu.** Les balises sémantiques (H1, H2, H3), les listes, les tableaux et les définitions explicites facilitent l'extraction d'information par les systèmes IA. Un contenu bien structuré est plus facile à parser, à comprendre et à citer qu'un bloc de texte continu.
**L'autorité thématique.** Les moteurs génératifs privilégient les sources qui font autorité sur un sujet donné. Un site qui publie régulièrement du contenu de qualité sur un thème spécifique (IA, data, product management) sera perçu comme plus fiable qu'un site généraliste qui aborde le sujet ponctuellement. C'est le concept de "topical authority", déjà important en SEO, qui prend encore plus de poids en GEO.
**La fraîcheur du contenu.** Pour les sujets qui évoluent rapidement (technologie, réglementation, marché), les moteurs génératifs privilégient les contenus récents. Un article de 2022 sur l'IA générative sera moins cité qu'un article mis à jour en 2025, même si le premier est mieux positionné historiquement en SEO.
**L'unicité de l'information.** Les contenus qui apportent un point de vue original, des données propriétaires ou des insights que les concurrents n'ont pas sont plus susceptibles d'être cités. Les moteurs génératifs cherchent à fournir la meilleure réponse possible — et un contenu qui ajoute de la valeur au-delà du consensus existant a plus de chances d'être sélectionné.
### GEO et stratégie de contenu
Le GEO impose une évolution de la stratégie de contenu des entreprises. Les approches SEO classiques — optimisation de mots-clés, link building, contenus longs pour couvrir un maximum de requêtes — restent utiles mais ne suffisent plus. Il faut ajouter :
- **Des formats "citation-friendly"** : définitions claires, chiffres sourcés, comparatifs structurés, listes de bonnes pratiques.
- **Une stratégie de cluster thématique** : un ensemble de contenus interconnectés sur un sujet donné, qui renforce l'autorité perçue.
- **Des mises à jour régulières** : les contenus evergreen doivent être rafraîchis pour maintenir leur pertinence.
- **Des données originales** : enquêtes, benchmarks, retours d'expérience — tout ce qu'un LLM ne peut pas générer seul.
### Les métriques du GEO
Mesurer l'impact du GEO est plus complexe que mesurer le SEO classique. Les outils traditionnels (Google Search Console, Semrush, Ahrefs) ne trackent pas encore complètement les citations dans les réponses génératives. De nouveaux outils et métriques émergent :
- **La visibilité dans les AI Overviews** : des outils comme Seomonitor ou Authoritas commencent à tracker les citations dans les réponses génératives de Google.
- **Le trafic depuis les moteurs génératifs** : les referrals depuis Perplexity, ChatGPT ou Bing Copilot, identifiables dans Google Analytics.
- **Le "share of voice" génératif** : la proportion de réponses génératives sur un sujet donné qui citent votre contenu vs celui des concurrents.
### GEO et Data Literacy
Le GEO est un exemple concret de l'impact de l'IA sur les métiers non-techniques. Les équipes marketing et contenu doivent développer une forme de **Data Literacy** appliquée à l'IA : comprendre comment les LLM sélectionnent et synthétisent l'information, comment le RAG fonctionne, quels sont les biais de sélection des moteurs génératifs. Cette compréhension est nécessaire pour adapter les stratégies de contenu.
### L'avenir du GEO
Le GEO en est à ses débuts. Les moteurs génératifs évoluent rapidement, les algorithmes de sélection de sources changent, et les pratiques d'optimisation se raffinent. Ce qui est certain : la recherche en ligne est en train de muter, et les organisations qui ne s'adaptent pas risquent de voir leur visibilité s'effondrer, même avec un bon SEO classique.
---
### Qu'est-ce que le GraphRAG ?
Source : https://www.hymaia.com/qu-est-ce-que/graphrag/
Le GraphRAG combine les knowledge graphs et le RAG pour permettre aux LLMs de raisonner sur des relations complexes entre entités. En structurant les données sous forme de graphe avant la récupération, cette approche améliore les réponses aux questions nécessitant plusieurs sauts logiques.
Le **GraphRAG** (Graph-based Retrieval-Augmented Generation) est une technique qui enrichit l'architecture RAG classique en y intégrant des knowledge graphs. Là où le RAG standard découpe des documents en fragments et les retrouve par similarité sémantique via des embeddings, le GraphRAG structure d'abord les informations sous forme de graphe de connaissances, puis exploite cette structure pour améliorer la pertinence des réponses générées par un LLM.
### Le problème que résout le GraphRAG
Le RAG classique fonctionne bien pour des questions simples dont la réponse se trouve dans un ou deux passages de texte. Mais il atteint ses limites face aux questions dites "multi-hop" — celles qui nécessitent de combiner des informations dispersées dans plusieurs documents et de suivre des chaînes de relations entre entités.
Exemple concret : "Quels sont les fournisseurs communs entre nos projets les plus rentables ?" Pour répondre, il faut d'abord identifier les projets rentables, puis retrouver leurs fournisseurs respectifs, puis croiser ces listes. Un système RAG par similarité vectorielle aura du mal à assembler ces éléments, car aucun passage isolé ne contient la réponse complète.
### Comment fonctionne le GraphRAG
Le processus se décompose en plusieurs étapes :
**1\. Extraction d'entités et de relations.** Un LLM analyse les documents source pour identifier les entités (personnes, organisations, concepts, produits) et les relations qui les lient. Ces éléments sont structurés sous forme de triplets (entité A — relation — entité B).
**2\. Construction du knowledge graph.** Les triplets sont assemblés dans un graphe où chaque noeud représente une entité et chaque arête une relation. Ce graphe peut être stocké dans une base de données spécialisée (Neo4j, Amazon Neptune) ou en mémoire.
**3\. Détection de communautés.** Des algorithmes de clustering (comme l'algorithme de Leiden) regroupent les noeuds fortement connectés en communautés thématiques. Pour chaque communauté, un résumé est généré automatiquement par le LLM.
**4\. Récupération hybride.** À la réception d'une question, le système combine plusieurs stratégies de récupération : recherche sémantique classique via embeddings, traversée du graphe pour suivre les relations entre entités, et consultation des résumés de communautés pour les questions globales.
**5\. Génération augmentée.** Le LLM reçoit à la fois les passages pertinents et le contexte structuré du graphe, ce qui lui permet de produire des réponses plus complètes et mieux fondées.
### L'apport de Microsoft Research
Microsoft Research a formalisé l'approche GraphRAG dans un papier publié en 2024, accompagné d'une implémentation open source. Leur contribution principale est la distinction entre deux types de requêtes : les requêtes **locales** (qui concernent des entités spécifiques et leurs voisins dans le graphe) et les requêtes **globales** (qui nécessitent une vue d'ensemble sur tout le corpus). Pour les requêtes globales, les résumés de communautés permettent de couvrir l'ensemble du corpus sans dépasser les limites de contexte du LLM.
### Comparaison avec le RAG classique
| Aspect | RAG classique | GraphRAG |
|--------|--------------|----------|
| Structure des données | Chunks de texte plats | Graphe d'entités et relations |
| Recherche | Similarité vectorielle | Traversée de graphe + vecteurs |
| Questions multi-hop | Limité | Performant |
| Questions globales | Limité (pas de vue d'ensemble) | Résumés de communautés |
| Coût d'indexation | Modéré | Plus élevé (extraction par LLM) |
| Explicabilité | Faible (quel chunk a été utilisé ?) | Forte (chemin dans le graphe) |
### Cas d'usage
Le GraphRAG est particulièrement adapté aux situations où les données présentent des relations complexes entre entités : bases de connaissances d'entreprise, documentation technique interconnectée, données réglementaires (où un article renvoie à d'autres textes), ou encore analyse de réseaux (supply chain, organigrammes).
Dans le contexte de la data governance, le GraphRAG peut exploiter un graphe de data lineage pour répondre à des questions sur l'origine et l'impact des données. Combiné à des guardrails pour contrôler la qualité des réponses, il constitue une brique robuste pour les systèmes d'IA d'entreprise.
### Limites et considérations
Le coût d'indexation est significativement plus élevé qu'un RAG classique, car l'extraction d'entités et de relations mobilise un LLM sur l'ensemble du corpus. La qualité du graphe dépend directement de la qualité de cette extraction. Par ailleurs, la maintenance du graphe lorsque les documents évoluent reste un défi d'ingénierie non trivial.
---
### Qu'est-ce que le grounding en intelligence artificielle ?
Source : https://www.hymaia.com/qu-est-ce-que/grounding/
Le grounding est la technique d'ancrage factuel des réponses d'un LLM dans des sources de données vérifiables. En connectant le modèle à des documents, des bases de données ou des APIs, le grounding réduit les hallucinations et permet de sourcer les affirmations générées.
Le **grounding** (ancrage factuel) désigne l'ensemble des techniques qui permettent de connecter les réponses d'un modèle de langage (LLM) à des sources d'information vérifiables. L'objectif est de passer d'un modèle qui "invente" des réponses plausibles à un système qui fonde ses affirmations sur des données concrètes.
### Le problème des hallucinations
Un LLM génère du texte en prédisant le token le plus probable à chaque étape, en fonction de son entraînement et du contexte. Ce mécanisme produit des réponses fluides et convaincantes, mais le modèle n'a aucune notion intrinsèque de "vérité". Il peut affirmer avec assurance des faits incorrects, inventer des citations, ou mélanger des informations provenant de sources différentes. Ces erreurs, appelées hallucinations, constituent le principal frein à l'adoption des LLMs pour des usages professionnels où la fiabilité est non négociable.
### Méthodes de grounding
**RAG (Retrieval-Augmented Generation).** La méthode la plus répandue. Avant de générer sa réponse, le système récupère des documents pertinents depuis une base de connaissances (via recherche sémantique ou un knowledge graph dans le cas du GraphRAG) et les injecte dans le contexte du LLM. Le modèle peut alors s'appuyer sur ces documents pour formuler sa réponse. Le RAG est particulièrement efficace pour les questions factuelles portant sur des données internes à l'organisation.
**Citations sourcées.** Le LLM est instruit (via le prompt système) de citer ses sources à chaque affirmation. Certaines implémentations vont plus loin en demandant au modèle d'extraire des passages verbatim des documents fournis, avec numéro de page ou de paragraphe. Cela permet une vérification humaine rapide.
**Accès à des APIs en temps réel.** Pour les informations qui évoluent (cours de bourse, météo, disponibilité de produits), le grounding passe par des appels à des APIs externes. Les agents IA utilisent des outils (tools) pour interroger ces sources et intégrer les données fraîches dans leur raisonnement.
**Bases de données structurées.** Plutôt que de chercher dans du texte libre, le LLM peut être connecté à des bases de données relationnelles ou des data platforms. Il génère alors des requêtes SQL ou des appels d'API structurés pour obtenir des données précises. Cette approche est particulièrement pertinente pour les données chiffrées (KPIs, stocks, historiques).
**Vérification croisée (multi-source).** Le système interroge plusieurs sources indépendantes et compare les réponses. En cas de divergence, il peut signaler l'incertitude à l'utilisateur ou privilégier la source la plus fiable. Cette technique se rapproche du fonctionnement des guardrails en sortie.
### Grounding et confiance
Le grounding ne se limite pas à réduire les erreurs — il transforme la relation de confiance entre l'utilisateur et le système. Un LLM qui cite ses sources permet à l'utilisateur de vérifier, de creuser, et de construire sa propre compréhension. C'est la différence entre un oracle opaque et un assistant transparent.
Dans un contexte professionnel, cette traçabilité est aussi une exigence réglementaire. L'AI Act impose aux systèmes d'IA à haut risque de documenter les données utilisées pour produire leurs résultats. Le grounding, en rendant les sources explicites, facilite cette conformité.
### Mesurer la qualité du grounding
Plusieurs métriques permettent d'évaluer l'efficacité du grounding :
- **Faithfulness** (fidélité) : la réponse est-elle cohérente avec les documents fournis ?
- **Relevance** (pertinence) : les documents récupérés sont-ils pertinents par rapport à la question ?
- **Attribution accuracy** : les citations renvoient-elles effectivement aux bons passages ?
- **Hallucination rate** : quel pourcentage d'affirmations dans la réponse ne sont pas soutenues par les sources ?
Des frameworks comme RAGAS ou TruLens automatisent ces évaluations, permettant un suivi continu de la qualité du grounding en production.
### Grounding et prompt engineering
La façon dont on formule les instructions au LLM influence directement la qualité du grounding. Des techniques de prompt engineering spécifiques améliorent l'ancrage factuel : demander au modèle de "répondre uniquement à partir des documents fournis", d'indiquer "je ne sais pas" quand l'information est absente, ou de structurer sa réponse avec des références numérotées.
### Limites
Le grounding ne résout pas tout. Si les sources elles-mêmes sont incomplètes, obsolètes ou contradictoires, le modèle groundé reproduira ces limites. Le grounding ajoute aussi de la latence (temps de récupération des documents) et du coût (tokens supplémentaires pour le contexte). Enfin, un modèle peut paraître groundé tout en interprétant mal un document — la fidélité parfaite reste un défi ouvert.
---
### Qu'est-ce que les guardrails en intelligence artificielle ?
Source : https://www.hymaia.com/qu-est-ce-que/guardrails-ia/
Les guardrails IA sont des mécanismes de contrôle appliqués aux entrées et sorties des LLMs pour garantir la sécurité, la conformité et la qualité des réponses. Ils filtrent les contenus inappropriés, valident les formats, détectent les tentatives de manipulation et vérifient la cohérence factuelle.
Les **guardrails IA** désignent l'ensemble des mécanismes de contrôle et de filtrage placés en amont et en aval d'un modèle de langage (LLM) pour encadrer son comportement. Leur rôle est d'empêcher le modèle de produire des réponses dangereuses, incorrectes, hors-sujet ou non conformes aux règles définies par l'organisation.
### Pourquoi les guardrails sont nécessaires
Un LLM, par conception, génère du texte statistiquement probable en fonction de son entraînement et du contexte fourni. Sans mécanisme de contrôle externe, rien ne l'empêche de produire des hallucinations, de divulguer des informations sensibles, de générer du contenu offensant ou de sortir du périmètre de sa mission. Les guardrails comblent cet écart entre les capacités brutes du modèle et les exigences d'un usage en production.
### Types de guardrails
**Guardrails en entrée (input guards).** Ils analysent la requête de l'utilisateur avant qu'elle n'atteigne le LLM. Parmi les mécanismes courants :
- **Détection de jailbreak** : identification des prompts conçus pour contourner les instructions système du modèle (injection de prompt, role-playing malveillant).
- **Filtrage de contenu** : blocage des requêtes contenant des demandes de contenu violent, illégal ou discriminatoire.
- **Validation de format** : vérification que la requête respecte le format attendu (longueur, langue, structure).
- **Détection de données sensibles** : repérage et masquage automatique de données personnelles (noms, numéros de carte) avant envoi au modèle.
**Guardrails en sortie (output guards).** Ils analysent la réponse du LLM avant qu'elle ne soit retournée à l'utilisateur :
- **Vérification factuelle** : croisement de la réponse avec des sources de référence pour détecter les hallucinations. Cette technique rejoint le grounding, qui ancre les réponses dans des données vérifiables.
- **Conformité réglementaire** : vérification que la réponse respecte les contraintes légales (AI Act, RGPD) et les politiques internes.
- **Cohérence avec le persona** : contrôle que la réponse reste dans le ton et le périmètre définis pour l'assistant.
- **Détection de toxicité** : analyse du contenu généré pour repérer les biais, le langage offensant ou les stéréotypes.
**Guardrails structurels.** Au-delà de l'analyse de contenu, certains guardrails encadrent le comportement global du système :
- **Limites de tokens** : plafonnement de la longueur des réponses pour maîtriser les coûts et la pertinence.
- **Timeouts et circuit breakers** : interruption du traitement si le modèle met trop longtemps ou entre dans une boucle.
- **Contrôle d'accès** : restriction des outils et données accessibles au modèle selon le profil de l'utilisateur.
### Implémentation technique
Plusieurs approches existent pour implémenter des guardrails :
**Classificateurs dédiés.** Des modèles plus légers (souvent fine-tunés sur des données de modération) analysent les entrées et sorties. OpenAI Moderation API, Llama Guard (Meta) ou NeMo Guardrails (NVIDIA) fonctionnent sur ce principe.
**Règles programmatiques.** Des regex, des listes de mots interdits ou des validations de schéma JSON vérifient les entrées/sorties de manière déterministe. Moins flexibles mais plus prévisibles.
**LLM-as-a-judge.** Un second LLM évalue la qualité et la conformité de la réponse du premier. Cette approche est plus coûteuse mais capable de détecter des problèmes subtils.
**Frameworks open source.** Guardrails AI, NeMo Guardrails et Langchain proposent des abstractions pour chaîner ces mécanismes dans un pipeline structuré.
### Guardrails et conformité réglementaire
L'AI Act européen impose des exigences de gestion des risques pour les systèmes d'IA à haut risque. Les guardrails constituent un élément technique central pour démontrer cette conformité : traçabilité des décisions de filtrage, journalisation des requêtes bloquées, documentation des règles appliquées. Ils s'intègrent dans une démarche plus large de data governance et d'IA responsable.
### Limites et arbitrages
Les guardrails ne sont pas infaillibles. Un filtrage trop strict génère des faux positifs qui dégradent l'expérience utilisateur. Un filtrage trop lâche laisse passer des contenus problématiques. Trouver le bon équilibre nécessite un monitoring continu, comparable au suivi du data drift dans les systèmes de ML classiques. Les techniques de jailbreak évoluent constamment, ce qui impose une mise à jour régulière des mécanismes de détection.
---
### Qu'est-ce qu'une hallucination en intelligence artificielle ?
Source : https://www.hymaia.com/qu-est-ce-que/hallucination-ia/
Une hallucination en IA désigne une réponse générée par un LLM qui semble plausible et confiante, mais qui contient des informations factuellement fausses ou inventées. C'est l'un des principaux obstacles à l'adoption des LLM en entreprise.
Une **hallucination**, dans le contexte de l'intelligence artificielle, est une réponse produite par un modèle de langage (LLM) qui contient des informations fausses, inventées ou déformées, présentées avec le même degré de confiance qu'une information vérifiée. Le modèle ne "ment" pas délibérément — il génère la séquence de tokens la plus probable selon ses paramètres, sans distinguer ce qui est factuel de ce qui est plausible.
### Pourquoi les LLM hallucinent
Pour comprendre les hallucinations, il faut revenir au fonctionnement d'un LLM. Un modèle de langage est entraîné à prédire le token suivant dans une séquence. Il apprend des patterns statistiques dans le langage, pas des "faits" au sens strict. Quand on lui pose une question factuelle, il ne consulte pas une base de données — il génère la réponse la plus vraisemblable étant donné les patterns appris.
Plusieurs mécanismes produisent des hallucinations :
**L'interpolation des connaissances.** Le modèle a appris des informations partielles sur un sujet et "comble les trous" avec des éléments plausibles mais incorrects. Par exemple, il peut attribuer un article scientifique réel à un mauvais auteur, ou mélanger des dates d'événements distincts.
**La pression à répondre.** Par défaut, un LLM est entraîné à toujours produire une réponse. Plutôt que de dire "je ne sais pas", il va générer une réponse qui a la forme d'une réponse correcte. L'alignement par RLHF atténue ce problème, mais ne l'élimine pas.
**La confusion entre corrélation textuelle et vérité.** Si le modèle a fréquemment vu "Einstein a reçu le prix Nobel de physique en 1921 pour la relativité" dans ses données d'entraînement (une erreur courante — c'était pour l'effet photoélectrique), il peut reproduire cette erreur avec assurance.
### Types d'hallucinations
Les chercheurs distinguent plusieurs catégories :
- **Hallucinations factuelles.** Le modèle invente des faits : des citations qui n'existent pas, des statistiques fabriquées, des événements fictifs présentés comme réels. C'est la forme la plus dangereuse en contexte professionnel.
- **Hallucinations de fidélité.** Le modèle s'écarte du document source qu'on lui demande de résumer ou d'analyser. Il ajoute des informations absentes du texte original ou en déforme le sens.
- **Hallucinations logiques.** Le raisonnement du modèle contient des étapes invalides, même si la conclusion peut parfois sembler correcte par hasard.
### L'impact en entreprise
Les hallucinations représentent le principal frein à l'adoption des LLM dans les contextes où la fiabilité de l'information est non négociable : juridique, médical, financier, réglementaire. Un chatbot de support client qui invente des conditions de garantie, un assistant juridique qui cite un article de loi inexistant, un outil d'analyse financière qui fabrique des chiffres — les conséquences peuvent être sérieuses.
C'est pourquoi les entreprises qui déploient des LLM en production investissent massivement dans les mécanismes de contrôle et de vérification.
### Stratégies pour réduire les hallucinations
**Le RAG (Retrieval-Augmented Generation).** En fournissant au modèle des documents sources pertinents avant de générer sa réponse, on ancre ses réponses dans des données vérifiables. Le RAG est la technique la plus répandue pour réduire les hallucinations factuelles. Combiné avec des instructions de ne répondre qu'à partir du contexte fourni, il transforme radicalement la fiabilité des réponses.
**Le grounding et les citations.** Demander au modèle de citer ses sources et les passages exacts sur lesquels il s'appuie permet à l'utilisateur de vérifier. Certains systèmes vont plus loin en vérifiant automatiquement que les citations correspondent bien au texte source.
**Les guardrails.** Des couches de validation en aval du LLM vérifient la cohérence des réponses : détection de contradictions, vérification factuelle automatisée, filtrage des réponses à faible confiance. Des outils comme Guardrails AI ou NeMo Guardrails d'NVIDIA formalisent cette approche.
**Le prompt engineering.** Des techniques simples réduisent significativement les hallucinations : demander au modèle de raisonner étape par étape (chain-of-thought), lui dire explicitement "si tu ne sais pas, dis-le", ou limiter ses réponses au contenu fourni.
**L'évaluation continue.** Mettre en place des benchmarks spécifiques aux hallucinations permet de mesurer et suivre le taux d'hallucination d'un système au fil des itérations. Sans mesure, pas d'amélioration.
### Peut-on éliminer les hallucinations ?
La réponse courte est non — pas complètement. Les hallucinations sont une conséquence structurelle du fonctionnement probabiliste des LLM. On peut les réduire drastiquement avec les bonnes techniques, mais un risque résiduel subsiste toujours. C'est pourquoi les architectures de production incluent systématiquement des mécanismes de vérification humaine ou automatisée, selon le niveau de criticité du cas d'usage.
Les progrès récents sont encourageants : les modèles de dernière génération hallucinent moins que leurs prédécesseurs, et les techniques de grounding s'améliorent rapidement. Mais la vigilance reste de mise.
---
### Qu'est-ce que l'IA agentique ?
Source : https://www.hymaia.com/qu-est-ce-que/ia-agentique/
L'IA agentique (Agentic AI) désigne une catégorie de systèmes d'intelligence artificielle capables de planifier, raisonner et agir de manière autonome pour atteindre un objectif. Contrairement à un LLM utilisé en mode conversationnel, un système agentique prend des décisions, utilise des outils et itère sans intervention humaine à chaque étape.
L'**IA agentique** (ou Agentic AI) désigne les systèmes d'intelligence artificielle conçus pour accomplir des objectifs complexes de manière autonome, en combinant planification, raisonnement, utilisation d'outils et capacité d'itération. Le terme marque une évolution par rapport à l'usage classique des LLM en mode question-réponse : un système agentique ne se contente pas de répondre, il agit.
### Ce qui distingue l'IA agentique
Un LLM utilisé de manière classique fonctionne en mode réactif : on lui pose une question, il répond. L'interaction s'arrête là. Un système agentique, en revanche, reçoit un objectif de haut niveau et orchestre de manière autonome les étapes nécessaires pour l'atteindre.
Les caractéristiques clés d'un système agentique :
- **Planification.** Le système décompose un objectif complexe en sous-tâches et détermine l'ordre d'exécution. Par exemple, pour "prépare un rapport d'analyse concurrentielle", il va identifier les concurrents à analyser, chercher les données pertinentes, structurer l'analyse et rédiger le rapport.
- **Utilisation d'outils (tool use).** Le système peut appeler des API, interroger des bases de données, exécuter du code, naviguer sur le web ou interagir avec des applications. C'est ce qui lui donne une capacité d'action concrète au-delà de la génération de texte.
- **Raisonnement et décision.** À chaque étape, le système évalue les résultats obtenus et décide de la suite : poursuivre le plan initial, ajuster sa stratégie ou demander une clarification à l'utilisateur.
- **Itération et correction.** Si une action échoue ou produit un résultat insatisfaisant, le système peut retenter avec une approche différente, sans attendre une intervention humaine.
### IA agentique vs agents IA
Les deux termes sont liés mais distincts. **L'IA agentique** est le paradigme — l'approche architecturale. Un **agent IA** est une implémentation concrète de ce paradigme : un programme qui combine un LLM, des outils et une boucle de raisonnement pour accomplir des tâches spécifiques.
On peut avoir un agent IA relativement simple (un assistant qui interroge une API et reformule les résultats) ou un système agentique sophistiqué impliquant plusieurs agents spécialisés qui collaborent. C'est cette dernière configuration — les systèmes multi-agents — qui concentre l'attention du marché.
### Architectures multi-agents
Les tâches complexes dépassent souvent les capacités d'un agent unique. Les architectures multi-agents répartissent le travail entre des agents spécialisés :
- Un **orchestrateur** qui reçoit l'objectif, planifie et coordonne.
- Des **agents spécialisés** qui exécutent des tâches spécifiques : recherche d'information, rédaction, analyse de données, exécution de code.
- Des mécanismes de **communication inter-agents** pour partager les résultats et coordonner les actions.
Des frameworks comme AutoGen (Microsoft), CrewAI, LangGraph ou le Agents SDK d'OpenAI facilitent la construction de ces systèmes. Le protocole MCP (Model Context Protocol), créé par Anthropic, standardise la connexion entre agents et outils externes, simplifiant l'interopérabilité.
### Cas d'usage en entreprise
L'IA agentique trouve des applications concrètes dans de nombreux domaines :
**Automatisation de workflows complexes.** Un système agentique peut gérer un processus d'onboarding client de bout en bout : collecter les documents, vérifier leur conformité, créer les comptes, envoyer les communications — en ne sollicitant un humain que pour les cas ambigus.
**Développement logiciel.** Les coding agents (Cursor, GitHub Copilot Workspace, Claude Code) illustrent l'IA agentique appliquée au développement : ils comprennent un codebase, planifient des modifications, écrivent et testent du code, et itèrent sur les erreurs.
**Analyse et recherche.** Des agents de recherche peuvent explorer un sujet en profondeur — lire des documents, croiser des sources, identifier les contradictions — et produire une synthèse structurée. Les deep research agents de Google et OpenAI en sont des exemples publics.
**Support client avancé.** Au-delà du chatbot classique, un système agentique peut diagnostiquer un problème, accéder aux systèmes internes pour vérifier l'état d'un compte, exécuter des actions correctives et escalader intelligemment vers un humain quand nécessaire.
### Défis et risques
L'IA agentique soulève des questions spécifiques :
- **Contrôle et supervision.** Plus un système est autonome, plus la question du contrôle humain se pose. Les approches actuelles privilégient le "human-in-the-loop" pour les actions à fort impact et le "human-on-the-loop" pour la supervision.
- **Propagation d'erreurs.** Dans un système multi-agents, une hallucination ou une erreur peut se propager d'un agent à l'autre et s'amplifier. Les mécanismes de vérification croisée entre agents sont essentiels.
- **Coûts et latence.** Un système agentique peut déclencher des dizaines d'appels LLM pour une seule tâche. L'optimisation des coûts et de la latence est un enjeu d'ingénierie significatif.
- **Sécurité.** Un agent qui peut exécuter des actions (écrire des fichiers, appeler des API, envoyer des emails) présente une surface d'attaque plus large qu'un simple chatbot. Les injections de prompt indirect deviennent un vecteur d'attaque concret.
Gartner a identifié l'IA agentique comme la tendance technologique stratégique n1 pour 2025, avec une prévision selon laquelle 33 % des logiciels d'entreprise intégreront des capacités agentiques d'ici 2028 (contre moins de 1 % en 2024).
---
### Qu'est-ce que l'IA generative ?
Source : https://www.hymaia.com/qu-est-ce-que/definition-ia-generative/
L'IA generative designe les systemes d'intelligence artificielle capables de creer du contenu original (texte, image, code, audio) a partir de consignes en langage naturel. Elle repose principalement sur des modeles de type LLM et Transformer.
**L'iIA Générative** est une branche de l'intelligence artificielle spécialisée dans la création de nouveaux contenus tels que des textes, des images, ou d'autres médias à partir de directives spécifiques, communément appelées _prompts_. Contrairement à la simple reproduction de données apprises, l'IA générative intègre un élément de nouveauté dans ses créations, démontrant ainsi une capacité de raisonnement rudimentaire.
Dans le domaine du texte, ces systèmes sont souvent désignés comme des **Modèles de Langage à Grande Échelle (LLM pour Large Language Models)**. Ces modèles se caractérisent par un nombre très élevé de paramètres, ce qui leur confère une capacité à générer des réponses et des solutions novatrices à des problèmes qu'ils n'ont pas explicitement été entraînés à résoudre, un phénomène connu sous le nom de _principe d'émergence_.
L'aspect révolutionnaire de l'IA générative ne repose pas tant sur une avancée technique que sur une transformation de l'expérience utilisateur. Les utilisateurs peuvent maintenant interagir directement avec l'IA pour explorer des solutions créatives à leurs problèmes, marquant une évolution significative dans l'accessibilité et l'application pratique de l'intelligence artificielle.
---
### Qu'est-ce que l'IA multimodale ?
Source : https://www.hymaia.com/qu-est-ce-que/ia-multimodale/
L'IA multimodale désigne les systèmes d'IA capables de traiter et générer plusieurs types de données -- texte, images, audio, vidéo -- de façon intégrée. Contrairement aux modèles spécialisés sur une seule modalité, les modèles multimodaux comprennent et relient les informations entre formats.
L'**IA multimodale** fait référence aux systèmes d'intelligence artificielle capables de traiter simultanément plusieurs types de données -- ou "modalités" -- comme le texte, les images, l'audio et la vidéo. Un modèle multimodal peut analyser une photo et la décrire en texte, transcrire une conversation audio, ou générer une image à partir d'une description textuelle.
### Des modèles spécialisés aux modèles multimodaux
Historiquement, les modèles d'IA étaient spécialisés sur une seule modalité. Les modèles de traitement du langage naturel (NLP) travaillaient sur le texte. Les modèles de vision par ordinateur analysaient les images. Les modèles de reconnaissance vocale traitaient l'audio. Chaque modalité avait ses architectures, ses jeux de données et ses métriques.
L'émergence des architectures Transformer, initialement conçues pour le texte, a changé la donne. Les chercheurs ont découvert que la même architecture pouvait traiter différentes modalités, à condition de transformer chaque type de donnée en une séquence de tokens. Un pixel peut devenir un token, un segment audio peut devenir un token, tout comme un mot.
### Les modèles multimodaux actuels
Plusieurs modèles multimodaux de référence sont disponibles :
**Modèles de compréhension (analyse de plusieurs modalités) :**
- **GPT-4o** (OpenAI) : traite texte, images et audio dans un modèle unifié. Le "o" signifie "omni".
- **Claude 3 / Claude 3.5** (Anthropic) : analyse texte et images avec une compréhension fine des documents, graphiques et captures d'écran.
- **Gemini** (Google DeepMind) : conçu nativement multimodal, traite texte, images, audio et vidéo.
**Modèles de génération d'images :**
- **DALL-E 3** (OpenAI) : génération d'images à partir de descriptions textuelles.
- **Midjourney** : génération d'images artistiques avec un contrôle stylistique avancé.
- **Stable Diffusion** (Stability AI) : modèle open source de génération d'images, déployable localement.
- **Flux** (Black Forest Labs) : nouvelle génération de modèles open source.
**Modèles audio et vidéo :**
- **Whisper** (OpenAI) : transcription audio vers texte, multilingue.
- **Sora** (OpenAI) : génération de vidéo à partir de texte.
- **Kling, Runway** : génération et édition vidéo.
### Comment fonctionne la multimodalité
Les modèles multimodaux utilisent généralement des **encodeurs spécialisés** pour chaque modalité, qui transforment les données brutes en représentations vectorielles (embeddings) dans un espace partagé. Le modèle CLIP d'OpenAI (2021) a été pionnier dans cette approche : il projette texte et images dans le même espace vectoriel, permettant de comparer directement une phrase et une image.
Les modèles plus récents comme GPT-4o adoptent une approche plus intégrée où l'ensemble du modèle est entraîné de bout en bout sur plusieurs modalités simultanément, plutôt que d'assembler des encodeurs séparés.
### Cas d'usage concrets
**Analyse de documents.** Un modèle multimodal peut analyser un PDF contenant du texte, des tableaux, des graphiques et des images, puis répondre à des questions sur l'ensemble du document. C'est un cas d'usage majeur pour les entreprises qui doivent traiter des rapports financiers, des contrats ou de la documentation technique.
**Support client visuel.** Un utilisateur envoie une photo d'un produit défectueux. Le modèle identifie le problème et propose une solution, combinant compréhension visuelle et connaissance produit.
**Accessibilité.** Description automatique d'images pour les personnes malvoyantes, sous-titrage de vidéos, transcription audio en temps réel.
**Recherche sémantique cross-modale.** Chercher des images avec du texte, trouver des passages vidéo correspondant à une description, ou identifier des segments audio mentionnant un concept précis. Les embeddings multimodaux et les bases de données vectorielles rendent ces recherches possibles.
**Génération de contenu.** Création de présentations combinant texte et visuels, génération de vidéos explicatives, production de podcasts synthétiques. Les équipes marketing et communication utilisent ces capacités pour accélérer la production de contenu.
### Multimodalité et RAG
L'intégration de la multimodalité dans les architectures RAG ouvre de nouvelles possibilités. Plutôt que de limiter la base de connaissances à du texte, on peut indexer des images, des diagrammes, des graphiques et des extraits audio. Les embeddings multimodaux (comme CLIP) permettent de rechercher dans ces bases avec des requêtes textuelles.
C'est un enjeu de context engineering : concevoir un système où le contexte fourni au LLM ne se limite pas au texte, mais intègre des informations visuelles et audio pertinentes pour la tâche.
### Limites et défis
**Les hallucinations visuelles.** Les modèles multimodaux peuvent "voir" des choses qui n'existent pas dans l'image, ou mal interpréter des éléments visuels. L'évaluation IA doit couvrir ces risques spécifiques.
**Le coût computationnel.** Traiter des images et des vidéos consomme significativement plus de ressources que le texte seul. Une image haute résolution peut représenter des milliers de tokens.
**Les biais.** Les modèles multimodaux héritent des biais de leurs données d'entraînement, avec des risques supplémentaires liés aux biais visuels (stéréotypes dans les images générées, biais de reconnaissance faciale).
**La confidentialité.** Envoyer des images ou des enregistrements audio à une API cloud pose des questions de confidentialité plus aiguës que pour du texte, notamment dans les contextes médicaux ou juridiques.
---
### Qu'est-ce que l'IA Responsable ?
Source : https://www.hymaia.com/qu-est-ce-que/ia-responsable/
L'IA Responsable designe l'ensemble des pratiques qui garantissent que les systemes d'intelligence artificielle sont developpes et deployes de maniere ethique, equitable, transparente et securisee.
L'**Intelligence Artificielle Responsable** fait référence à l'utilisation éthique, équitable, transparente et respectueuse de l'intelligence artificielle (IA) dans le développement, le déploiement et l'utilisation des systèmes d'IA. Cette approche vise à garantir que les systèmes d'IA respectent les principes éthiques et les valeurs humaines tout en minimisant les risques potentiels pour la société et les individus.
Les principes fondamentaux de l'IA responsable incluent :
1. **Éthique** : Assurer que les systèmes d'IA respectent les normes éthiques et morales, notamment en évitant les préjugés, la discrimination et les violations des droits de l'homme.
2. **Équité** : Garantir que les systèmes d'IA traitent toutes les personnes de manière équitable, sans favoritisme ni discrimination, et en prenant en compte les besoins et les perspectives de divers groupes sociaux.
3. **Transparence** : Fournir une transparence sur la manière dont les systèmes d'IA prennent leurs décisions, y compris en rendant compte des algorithmes utilisés, des données d'entraînement et des processus de prise de décision.
4. **Responsabilité** : Tenir les développeurs, les utilisateurs et les décideurs responsables des actions et des conséquences des systèmes d'IA, en mettant en place des mécanismes de responsabilisation et de reddition de comptes.
5. **Sécurité** : Assurer la sécurité et la confidentialité des données utilisées par les systèmes d'IA, ainsi que la protection contre les cybermenaces et les atteintes à la vie privée.
6. **Durabilité** : Concevoir et utiliser des systèmes d'IA de manière à minimiser leur impact environnemental et à promouvoir la durabilité à long terme.
L'IA responsable nécessite une collaboration entre les développeurs, les chercheurs, les décideurs politiques, les entreprises, la société civile et d'autres parties prenantes pour élaborer des normes, des lignes directrices et des pratiques exemplaires pour guider le développement et l'utilisation de l'IA de manière responsable et éthique.
---
### Qu'est-ce que l'IA souveraine ?
Source : https://www.hymaia.com/qu-est-ce-que/ia-souveraine/
L'IA souveraine désigne la capacité d'un État ou d'une zone économique à développer, héberger et contrôler ses propres systèmes d'IA sans dépendance vis-à-vis d'acteurs étrangers. En Europe, cet enjeu couvre les modèles, les infrastructures de calcul, les données et les compétences.
L'**IA souveraine** (sovereign AI) désigne la capacité d'une nation, d'un ensemble de nations ou d'une organisation à maîtriser l'ensemble de la chaîne de valeur de l'intelligence artificielle : modèles, données d'entraînement, infrastructure de calcul, compétences humaines et cadre réglementaire. L'objectif est d'éviter une dépendance stratégique vis-à-vis d'acteurs étrangers — en l'occurrence, principalement américains et chinois — pour un actif devenu central dans la compétitivité économique et la sécurité nationale.
### Les dimensions de la souveraineté IA
La souveraineté en matière d'IA ne se réduit pas à la capacité de créer des modèles. Elle couvre plusieurs dimensions interdépendantes :
**Les modèles fondamentaux.** Disposer de modèles de langage et de modèles multimodaux développés localement, entraînés sur des données représentatives de la langue, de la culture et des besoins spécifiques. En France, Mistral AI est devenu le porte-étendard de cette ambition depuis sa création en 2023. L'entreprise développe des modèles ouverts (Mistral 7B, Mixtral, Mistral Large) qui offrent une alternative aux modèles de OpenAI, Google et Anthropic.
**L'infrastructure de calcul.** L'entraînement de grands modèles IA nécessite une puissance de calcul considérable — des milliers de GPU pendant des semaines. Cette infrastructure est aujourd'hui largement concentrée chez les hyperscalers américains (AWS, Google Cloud, Microsoft Azure). La souveraineté IA implique de développer des capacités de calcul locales. L'Union Européenne a lancé le concept d'"AI Factories" : des supercalculateurs dédiés à l'IA, financés par le programme EuroHPC, destinés à fournir aux entreprises et aux chercheurs européens un accès à la puissance de calcul sans dépendre des clouds américains.
**Les données.** Les données d'entraînement des grands modèles sont majoritairement en anglais et reflètent des biais culturels anglophones. Une IA souveraine implique de constituer des corpus d'entraînement diversifiés, représentatifs des langues et des contextes locaux, et conformes aux réglementations européennes sur la protection des données.
**Les compétences.** La formation et la rétention de chercheurs et d'ingénieurs en IA sont un enjeu direct de souveraineté. La France forme d'excellents chercheurs en IA — le pays est régulièrement parmi les premiers en publications scientifiques dans le domaine — mais la fuite des talents vers les laboratoires américains reste un défi.
**Le cadre réglementaire.** L'**AI Act** européen est un pilier de la souveraineté IA au sens large : en fixant des règles du jeu propres à l'Europe, il crée un cadre qui oblige les acteurs étrangers à se conformer aux standards européens pour opérer sur le marché. C'est une forme de souveraineté normative — l'Europe ne produit peut-être pas les plus gros modèles, mais elle définit les règles d'usage.
### Le contexte européen
L'Europe est dans une position paradoxale en matière d'IA. Elle dispose de talents, de données, d'un marché de 450 millions de consommateurs et d'un cadre réglementaire avancé. Mais elle accuse un retard significatif sur les investissements dans les modèles fondamentaux et l'infrastructure de calcul.
Quelques initiatives structurantes visent à combler ce retard :
- **Mistral AI** (France) : levée de plus de 600 millions d'euros, valorisation de plusieurs milliards, développement de modèles compétitifs avec les leaders américains.
- **Aleph Alpha** (Allemagne) : modèles multilingues pensés pour le marché européen, avec un focus sur les usages B2B et gouvernementaux.
- **EuroHPC / AI Factories** : programme européen de construction de supercalculateurs dédiés à l'IA, avec des installations prévues dans plusieurs pays membres.
- **France 2030** : plan d'investissement incluant un volet IA significatif, avec le soutien à des champions nationaux et à la recherche.
### Souveraineté et open source
Le mouvement open source joue un rôle important dans la souveraineté IA. Les modèles ouverts — comme ceux de Mistral, Meta (Llama) ou les modèles communautaires — permettent aux organisations d'héberger et de fine-tuner des modèles sur leurs propres infrastructures, sans dépendre d'une API propriétaire. Cette approche est particulièrement pertinente pour les usages sensibles (défense, santé, administration) où les données ne peuvent pas transiter par des serveurs étrangers.
L'open source n'est toutefois pas une garantie de souveraineté à elle seule : utiliser un modèle ouvert développé par une entreprise américaine sur un cloud américain ne constitue pas une véritable indépendance. La souveraineté exige de maîtriser l'ensemble de la chaîne — du modèle à l'infrastructure en passant par les données.
### Les enjeux pour les entreprises
Au-delà des États, la question de la souveraineté IA se pose aussi pour les entreprises :
- **Conformité et protection des données** : les entreprises européennes soumises au RGPD doivent s'assurer que les données traitées par les systèmes IA ne sortent pas du cadre réglementaire. L'**AI Governance** interne doit intégrer ces contraintes.
- **Réduction de la dépendance fournisseur** : une stratégie multi-modèles, combinant des modèles propriétaires (OpenAI, Anthropic) et des modèles ouverts hébergés localement, permet de réduire le risque de lock-in.
- **Avantage compétitif** : les entreprises capables de fine-tuner des modèles sur leurs propres données, hébergés sur leurs propres infrastructures, disposent d'un avantage que leurs concurrents ne peuvent pas répliquer en utilisant simplement des API publiques.
### IA souveraine et IA Responsable
La souveraineté et la responsabilité sont complémentaires. Une IA souveraine sans cadre éthique risque de reproduire les dérives observées ailleurs (surveillance de masse, manipulation). Inversement, une **IA Responsable** sans souveraineté technologique reste tributaire des choix éthiques des fournisseurs étrangers. L'approche européenne vise à combiner les deux : des modèles maîtrisés localement, encadrés par des principes éthiques et un cadre réglementaire exigeant.
---
### Qu'est-ce que l'ingestion batch en data engineering ?
Source : https://www.hymaia.com/qu-est-ce-que/ingestion-batch/
L'ingestion batch consiste a traiter des donnees par lots a intervalles reguliers, contrairement au streaming temps reel. C'est le pattern dominant des pipelines de donnees modernes.
L'ingestion batch est un mode de traitement de donnees ou les donnees sont collectees, puis traitees en un seul bloc (un "lot" ou "batch") a intervalles definis. Contrairement au streaming qui traite les donnees en continu au fil de leur arrivee, le batch execute un job avec un debut et une fin, typiquement programme a heure fixe via un orchestrateur.
### Comment fonctionne l'ingestion batch
Le principe est simple : un job se declenche (par un scheduler ou un evenement), extrait les donnees d'une ou plusieurs sources, les transforme, puis les charge dans un systeme cible. C'est le fameux pattern ETL (Extract, Transform, Load) ou sa variante ELT (Extract, Load, Transform) qui a gagne en popularite avec les entrepots de donnees cloud.
Entre deux executions, le pipeline est inactif. Cette caracteristique a un avantage direct : on peut deployer une nouvelle version du code, la tester, et la valider avant la prochaine execution. En streaming, toute mise a jour necessite un redeploiement a chaud sans interruption de service, ce qui complexifie les operations.
### Differents patterns d'execution
Le batch recouvre plusieurs strategies selon le volume et la fraicheur attendue :
- **Full load** : on recharge l'integralite des donnees a chaque execution. Simple mais couteux en ressources sur de gros volumes.
- **Incremental load** : seules les donnees nouvelles ou modifiees depuis la derniere execution sont traitees. Plus efficace, mais necessite un mecanisme de detection des changements (timestamp, CDC).
- **Micro-batch** : un compromis entre batch et streaming, avec des executions tres frequentes (toutes les 5 a 15 minutes). Apache Spark Structured Streaming fonctionne sur ce principe.
### Outils et technologies
L'ecosysteme batch est riche et mature. Cote orchestration, Apache Airflow reste la reference open source pour planifier et monitorer des pipelines complexes avec gestion des dependances entre taches. Dagster et Prefect sont des alternatives plus recentes avec une meilleure experience developpeur.
Pour la transformation, dbt (data build tool) a transforme les pratiques en permettant aux Analytics Engineers d'ecrire des transformations en SQL versionne, teste et documente directement dans l'entrepot de donnees. Cote traitement distribue, Apache Spark reste incontournable pour les volumes massifs, capable de traiter des teraoctets de donnees en parallele sur un cluster.
Les services cloud managees comme AWS Glue, Google Cloud Dataflow ou Azure Data Factory simplifient le deploiement en eliminant la gestion d'infrastructure.
### Pourquoi le batch reste dominant
Malgre l'attrait du temps reel, le batch couvre la grande majorite des besoins en entreprise. Les rapports financiers, les tableaux de bord analytiques, l'entrainement de modeles de machine learning, les synchronisations entre systemes : tous ces cas d'usage n'exigent pas une latence inferieure a la minute.
Le batch est aussi plus simple a debugger, a tester et a maintenir. Les Data Engineers peuvent inspecter les donnees a chaque etape, rejouer un job en cas d'erreur, et tracer l'ensemble du parcours de la donnee grace au Data Lineage.
### Cas d'usage concrets
- **Reporting quotidien** : alimentation d'un entrepot de donnees chaque nuit pour des dashboards consultes le matin.
- **Entrainement de modeles ML** : extraction de features depuis une Data Platform, calcul de jeux d'entrainement, stockage dans un Feature Store.
- **Migration et consolidation** : chargement de donnees depuis des systemes legacy vers une Modern Data Stack cloud.
- **Conformite reglementaire** : generation de rapports periodiques pour la Data Governance (RGPD, audits).
### Batch vs streaming : comment choisir
Le choix depend de la latence acceptable. Si les donnees doivent etre disponibles en moins de quelques secondes (detection de fraude, alertes temps reel), le streaming s'impose. Pour tout le reste, le batch offre un meilleur rapport simplicite/cout. De nombreuses architectures combinent les deux : un pipeline batch pour l'historique et les analyses lourdes, un flux streaming pour les alertes et les actions immediates. C'est ce qu'on appelle l'architecture Lambda.
---
### Qu'est-ce qu'un knowledge graph ?
Source : https://www.hymaia.com/qu-est-ce-que/knowledge-graph/
Un knowledge graph (graphe de connaissances) est une structure de données qui organise l'information sous forme d'entités reliées par des relations sémantiques. Utilisé pour structurer les connaissances d'une organisation, il connaît un regain d'intérêt avec l'IA générative et le GraphRAG.
Un **knowledge graph** (graphe de connaissances) est une représentation structurée de l'information où des entités (personnes, concepts, produits, événements) sont reliées entre elles par des relations typées et sémantiquement explicites. Contrairement à une base de données relationnelle où les relations sont implicites (via des clés étrangères), un knowledge graph fait des relations des objets de première classe, navigables et interrogeables.
### Anatomie d'un knowledge graph
Un knowledge graph repose sur une structure simple : des **triplets** (sujet, prédicat, objet). Par exemple :
- (Paris, est-la-capitale-de, France)
- (Claude, est-développé-par, Anthropic)
- (Data Mesh, est-une-approche-de, data governance)
Chaque entité peut avoir des attributs (propriétés) et chaque relation peut porter des métadonnées (date, source, niveau de confiance). Cette structure en graphe permet de naviguer de proche en proche et de découvrir des connexions non évidentes dans des données tabulaires.
### Un concept mature revitalisé par l'IA
Le concept de knowledge graph n'est pas nouveau. Google a lancé son Knowledge Graph en 2012 pour enrichir les résultats de recherche avec des fiches structurées (les encadrés qui s'affichent à droite des résultats). Wikidata, DBpedia et d'autres projets ont suivi la même logique : structurer la connaissance du monde sous forme de graphe.
Ce qui a changé avec l'IA générative, c'est l'usage des knowledge graphs. Ils ne servent plus seulement à alimenter des moteurs de recherche ou des systèmes de recommandation. Ils deviennent une brique pour fiabiliser les LLM.
### Knowledge graph et RAG : le GraphRAG
Le RAG classique récupère des documents par recherche vectorielle : on cherche les passages sémantiquement proches de la question dans une base de données vectorielle. Cette approche fonctionne bien pour des questions factuelles simples, mais atteint ses limites pour des questions qui nécessitent de relier des informations dispersées.
Le **GraphRAG** combine le RAG avec un knowledge graph. Au lieu de chercher uniquement des passages similaires, le système navigue dans le graphe pour trouver les entités et relations pertinentes, puis les injecte dans le contexte du LLM. Microsoft Research a publié en 2024 des travaux montrant que le GraphRAG améliore significativement les réponses sur des questions nécessitant de synthétiser des informations provenant de sources multiples.
Par exemple, pour la question "quels clients de notre secteur bancaire ont déployé des solutions de data governance ?", un RAG classique chercherait des passages contenant ces mots-clés. Un GraphRAG naviguerait dans le graphe : secteur bancaire → clients du secteur → projets de ces clients → projets liés à la data governance.
### Construction d'un knowledge graph
Construire un knowledge graph se fait de deux façons complémentaires :
**Approche manuelle (curated).** Des experts du domaine définissent l'ontologie (les types d'entités et de relations) et alimentent le graphe. C'est l'approche la plus fiable mais la plus coûteuse. Elle convient aux domaines où la précision est non négociable (médical, juridique, finance).
**Approche automatisée (extraction).** Des modèles de NLP extraient automatiquement des entités et des relations à partir de documents textuels. Les LLM ont considérablement amélioré cette extraction : on peut leur demander d'identifier les entités, leurs attributs et leurs relations dans un texte, puis structurer le tout en triplets. La qualité reste inférieure à l'approche manuelle, mais le passage à l'échelle est bien meilleur.
En pratique, les deux approches se combinent : une ontologie de base définie par des experts, enrichie automatiquement par extraction, avec une validation humaine sur les éléments critiques.
### Technologies de graphe
Plusieurs technologies supportent les knowledge graphs :
- **Neo4j** : la base de données graphe la plus répandue, avec le langage de requête Cypher.
- **Amazon Neptune** : service managé AWS pour les graphes.
- **Apache TinkerPop / Gremlin** : standard open source pour la traversée de graphes.
- **RDF / SPARQL** : standards du W3C pour les données liées, utilisés par Wikidata et les graphes académiques.
### Application en entreprise
En entreprise, les knowledge graphs sont utilisés pour :
- **La gestion des connaissances** : cartographier l'expertise, les projets et les relations entre équipes.
- **Le data lineage** : tracer l'origine et les transformations des données dans une data platform.
- **La conformité réglementaire** : documenter les liens entre processus, données et obligations (RGPD, AI Act).
- **L'enrichissement des chatbots** : fournir aux agents IA une connaissance structurée du domaine métier.
Le knowledge graph s'inscrit dans une logique de data governance structurée : il rend explicites les liens entre les données, ce qui facilite la documentation, l'audit et la réutilisation.
---
### Qu'est-ce que la Knowledge Infrastructure ?
Source : https://www.hymaia.com/qu-est-ce-que/knowledge-infrastructure/
La Knowledge Infrastructure désigne l'ensemble des systèmes, processus et pratiques qui permettent de capturer, structurer et distribuer la connaissance organisationnelle. Elle inclut les knowledge graphs, les bases vectorielles, les taxonomies et les processus de curation.
La **Knowledge Infrastructure** (infrastructure de la connaissance) désigne l'ensemble des systèmes techniques, des processus organisationnels et des pratiques humaines qui permettent à une organisation de capturer, structurer, retrouver et distribuer sa connaissance — qu'elle soit explicite (documentée) ou tacite (dans la tête des experts). Avec l'essor de l'IA, et particulièrement de l'IA générative et des agents IA, la Knowledge Infrastructure est passée d'un sujet de knowledge management classique à un enjeu stratégique direct.
### Pourquoi la Knowledge Infrastructure redevient un sujet central
Le knowledge management existe depuis les années 1990. Mais l'émergence des systèmes IA a profondément changé la donne. Un LLM (Large Language Model) est performant sur les connaissances générales, mais ignorant du contexte spécifique d'une organisation : ses processus, ses décisions passées, ses conventions, ses produits, ses clients. Pour exploiter l'IA à son plein potentiel, il faut lui fournir ce contexte — et c'est exactement le rôle de la Knowledge Infrastructure.
Concrètement : la qualité des réponses d'un système RAG (Retrieval-Augmented Generation) dépend directement de la qualité de la base de connaissances qu'il interroge. Un agent IA qui automatise un processus métier a besoin d'accéder aux règles, aux exceptions et aux cas particuliers de ce processus. Sans Knowledge Infrastructure solide, l'IA tourne à vide — elle hallucine ou produit des réponses génériques inutiles.
### Les composantes d'une Knowledge Infrastructure
**Les sources de connaissance.** La connaissance d'une organisation est dispersée dans de multiples endroits : wikis, documentation technique, tickets Jira, conversations Slack, emails, comptes-rendus de réunion, présentations, CRM, code source. La première étape est d'identifier et de cartographier ces sources.
**Les systèmes de stockage et d'indexation.** La connaissance identifiée doit être stockée dans des systèmes qui la rendent retrouvable. Cela inclut :
- Les **bases vectorielles** (Pinecone, Weaviate, Qdrant, ChromaDB) qui permettent la recherche sémantique — retrouver de l'information par le sens plutôt que par les mots-clés.
- Les **knowledge graphs** qui modélisent les relations entre concepts, entités et faits, permettant un raisonnement structuré.
- Les **moteurs de recherche internes** (Elasticsearch, Algolia) pour la recherche full-text classique.
- Les **data catalogs** qui documentent les données disponibles et leurs métadonnées.
**Les taxonomies et ontologies.** Comment la connaissance est-elle organisée ? Quelles sont les catégories, les labels, les hiérarchies ? Une taxonomie partagée permet aux humains et aux systèmes IA de parler le même langage. Sans elle, la même information peut être classée de manières incompatibles par différentes équipes.
**Les processus de curation.** La connaissance ne se gère pas toute seule. Elle vieillit, devient obsolète, se contredit. Des processus de curation — qui crée, qui valide, qui met à jour, qui archive — sont nécessaires pour maintenir la fiabilité de la base. Le rôle de **Data Steward**, appliqué à la connaissance plutôt qu'aux seules données, prend ici tout son sens.
**Les interfaces de distribution.** Comment la connaissance atteint-elle ceux qui en ont besoin ? Via des chatbots internes alimentés par RAG, des systèmes de recommandation contextuelle (suggestions proactives dans l'outil de travail), des API qui permettent aux agents IA d'interroger la base.
### Knowledge Infrastructure et Context Engineering
Le concept de Knowledge Infrastructure est directement lié à celui de **Context Engineering** — l'art de fournir aux systèmes IA le bon contexte au bon moment. Un prompt bien conçu ne suffit pas si la connaissance que le système doit mobiliser n'est pas accessible. Le Context Engineering s'appuie sur la Knowledge Infrastructure pour alimenter les systèmes IA en informations pertinentes, à jour et fiables.
### Les défis de mise en place
**La fragmentation.** Dans la plupart des organisations, la connaissance est éclatée entre des dizaines d'outils. Confluence pour la documentation, Notion pour les notes, Slack pour les échanges informels, Google Drive pour les présentations. Unifier ces sources sans créer un énième silo est un défi architectural.
**La connaissance tacite.** Une part significative de la connaissance organisationnelle n'est pas documentée — elle réside dans l'expertise des collaborateurs, dans les habitudes et les conventions non écrites. Capturer cette connaissance, la rendre explicite et exploitable par des systèmes IA, reste l'un des défis les plus difficiles.
**La maintenance.** Une base de connaissances non maintenue se dégrade rapidement. Les documents obsolètes génèrent du bruit, les informations contradictoires créent de la confusion, et les systèmes IA qui s'appuient sur une base dégradée produisent des résultats dégradés. La Knowledge Infrastructure exige un investissement continu, pas un projet one-shot.
**La gouvernance.** Qui peut contribuer ? Qui valide ? Quel est le processus de revue ? Comment gère-t-on les contenus sensibles ou confidentiels ? La **Data Governance** fournit un cadre utile, mais les spécificités de la connaissance (subjectivité, contexte, obsolescence rapide) ajoutent des contraintes propres.
### Knowledge Infrastructure et Data Platform
La Knowledge Infrastructure n'est pas un doublon de la **Data Platform** — elle la complète. La Data Platform gère les données structurées et semi-structurées (tables, logs, events). La Knowledge Infrastructure gère les connaissances — informations interprétées, contextualisées, prêtes à être mobilisées pour la prise de décision ou l'alimentation de systèmes IA. Les deux doivent coexister et s'interconnecter.
### Un investissement qui conditionne le ROI de l'IA
Les organisations qui investissent dans leur Knowledge Infrastructure tirent davantage de valeur de leurs projets IA. Un système RAG alimenté par une base de connaissances bien structurée et maintenue produit des réponses fiables et utiles. Un agent IA qui dispose d'un accès organisé au contexte métier peut automatiser des processus complexes. Sans cette infrastructure, les mêmes systèmes produisent des résultats médiocres — renforçant potentiellement l'**AI Death Cycle**.
---
### Qu'est-ce qu'un LLM (Large Language Model) ?
Source : https://www.hymaia.com/qu-est-ce-que/llm/
Un LLM (Large Language Model) est un modèle d'intelligence artificielle entraîné sur de vastes corpus de texte, capable de comprendre et générer du langage naturel. GPT, Claude, Llama et Mistral sont des exemples de LLM qui alimentent les applications d'IA générative.
Un **LLM (Large Language Model)**, ou grand modèle de langage, est un réseau de neurones entraîné sur des quantités massives de texte — livres, articles, pages web, code source — pour apprendre les structures statistiques du langage. Une fois entraîné, un LLM peut générer du texte, répondre à des questions, résumer des documents, traduire, écrire du code et réaliser un large spectre de tâches linguistiques.
### Architecture et fonctionnement
Les LLM modernes reposent sur l'architecture Transformer, introduite par Google en 2017 dans l'article "Attention Is All You Need". Le mécanisme central est l'**attention** : pour chaque mot (ou token) d'une séquence, le modèle calcule l'importance relative de tous les autres tokens. C'est ce qui lui permet de capturer des relations de sens à longue distance dans un texte.
L'entraînement d'un LLM se déroule en deux phases principales :
**Le pré-entraînement (pre-training).** Le modèle apprend à prédire le mot suivant dans une séquence, sur des corpus contenant des centaines de milliards de tokens. Cette phase nécessite des milliers de GPU pendant plusieurs semaines et représente un investissement de plusieurs dizaines de millions de dollars pour les modèles les plus grands. C'est pendant cette phase que le modèle acquiert sa compréhension du langage, ses connaissances factuelles et ses capacités de raisonnement.
**L'alignement (fine-tuning + RLHF).** Le modèle pré-entraîné est ensuite affiné pour suivre des instructions et produire des réponses utiles et sûres. Cette étape utilise des techniques comme le RLHF (Reinforcement Learning from Human Feedback) où des annotateurs humains évaluent et classent les réponses du modèle. C'est l'alignement qui transforme un modèle de prédiction de texte brut en un assistant conversationnel.
### La taille compte — mais pas seulement
Le terme "Large" dans LLM fait référence au nombre de paramètres du modèle. GPT-3, sorti en 2020, comptait 175 milliards de paramètres. Les modèles actuels atteignent plusieurs centaines de milliards, voire plus d'un trillion de paramètres pour les architectures MoE (Mixture of Experts).
Mais la course aux paramètres n'est pas le seul facteur de performance. Les recherches récentes montrent que la qualité des données d'entraînement, la durée du pré-entraînement et les techniques d'alignement comptent autant, sinon plus. Le modèle Llama 3 de Meta, avec 70 milliards de paramètres, rivalise avec des modèles bien plus grands grâce à un entraînement plus long sur des données mieux filtrées. Mistral, startup française, a démontré qu'un modèle de 7 milliards de paramètres pouvait surpasser des modèles dix fois plus grands sur certaines tâches.
### Capacités émergentes
Un phénomène marquant des LLM est l'émergence de capacités qui n'ont pas été explicitement programmées. Au-delà d'un certain seuil de taille et de données, les modèles développent des aptitudes inattendues : raisonnement multi-étapes, résolution de problèmes mathématiques, compréhension de l'ironie, génération de code fonctionnel. Ces capacités émergentes sont ce qui distingue les LLM des modèles de langage classiques.
### Limites connues
Les LLM présentent des limites qu'il faut comprendre pour les utiliser efficacement :
- **Les hallucinations.** Un LLM peut générer des informations factuellement fausses avec un ton parfaitement assuré. C'est un problème structurel lié à la nature probabiliste du modèle, qui prédit des séquences de tokens plausibles plutôt que des faits vérifiés.
- **La fenêtre de contexte.** Chaque LLM a une capacité limitée de tokens qu'il peut traiter en une seule requête. Les modèles récents offrent des fenêtres de 100 000 à 1 million de tokens, mais la qualité d'attention se dégrade souvent sur les très longs contextes.
- **Les connaissances figées.** Un LLM ne sait que ce qu'il a appris pendant l'entraînement. Pour accéder à des informations récentes ou à des données propriétaires, il faut des techniques comme le RAG (Retrieval-Augmented Generation).
- **Les biais.** Les LLM reproduisent et parfois amplifient les biais présents dans leurs données d'entraînement.
### L'écosystème des LLM en 2025-2026
Le marché se structure autour de plusieurs catégories :
- **Modèles propriétaires** : GPT-4o et o1 (OpenAI), Claude (Anthropic), Gemini (Google DeepMind). Accessibles via API, ils offrent les meilleures performances sur les benchmarks généralistes.
- **Modèles open-source/open-weight** : Llama (Meta), Mistral (Mistral AI), Qwen (Alibaba), Command R (Cohere). Ils permettent un déploiement on-premise et un contrôle total des données.
- **Modèles spécialisés** : des modèles fine-tunés pour le code (StarCoder, CodeLlama), la médecine, le juridique ou d'autres domaines.
Cette diversité donne aux entreprises un véritable choix architectural. Les approches d'IA agentique, qui combinent plusieurs LLM avec des outils externes via des protocoles comme MCP, représentent la direction actuelle du marché.
---
### Qu'est-ce que le LLMOps ?
Source : https://www.hymaia.com/qu-est-ce-que/llmops/
Le LLMOps désigne les pratiques d'ingénierie pour déployer, monitorer et maintenir des applications basées sur des LLM en production. Extension du MLOps adaptée aux grands modèles de langage, il couvre la gestion des prompts, l'évaluation des sorties, le suivi des coûts et la gouvernance.
Le **LLMOps** (Large Language Model Operations) regroupe les pratiques, outils et processus nécessaires pour opérer des applications basées sur des grands modèles de langage (LLM) en production. Si le MLOps a structuré l'industrialisation du machine learning classique, le LLMOps adapte ces principes aux contraintes spécifiques des LLM : modèles pré-entraînés, interactions en langage naturel, coûts variables par token, et comportements non déterministes.
### Ce qui distingue le LLMOps du MLOps
Le MLOps traditionnel se concentre sur l'entraînement, le déploiement et le monitoring de modèles que l'organisation développe elle-même. Le LLMOps apporte des préoccupations différentes :
**Les modèles sont pré-entraînés.** La plupart des équipes n'entraînent pas leurs propres LLM. Elles utilisent des modèles existants (GPT-4, Claude, Mistral, Llama) via des API ou en déploiement local. Le travail porte sur la configuration du contexte, pas sur l'entraînement.
**Le prompt est du code.** En MLOps, on versionne des modèles et des datasets. En LLMOps, on versionne aussi des prompts, des templates de contexte, des system messages. Le context engineering devient un artefact de production à part entière.
**Les sorties sont non déterministes.** Même avec la même entrée, un LLM peut produire des réponses différentes. Cela complexifie le testing et impose des approches d'évaluation spécifiques.
**Les coûts sont variables.** Chaque appel API consomme des tokens facturés. Le monitoring des coûts par requête, par utilisateur et par fonctionnalité devient un enjeu opérationnel.
### Les piliers du LLMOps
**1\. Gestion des prompts et du contexte**
Le versioning des prompts est au cœur du LLMOps. Chaque modification d'un prompt système, d'un template de contexte ou d'une stratégie de RAG doit être tracée, testée et déployable de façon indépendante. Des outils comme LangSmith, PromptLayer ou Humanloop offrent des interfaces dédiées pour gérer ce cycle de vie.
**2\. Évaluation et qualité**
Évaluer la qualité d'un LLM en production est un défi spécifique. Les métriques classiques (precision, recall) ne suffisent pas pour juger la qualité d'une réponse en langage naturel. Le LLMOps intègre :
- Des **evals automatisées** : un LLM juge les réponses d'un autre LLM selon des critères prédéfinis (pertinence, fidélité aux sources, ton).
- Des **evals humaines** : des annotateurs évaluent un échantillon de réponses sur des critères qualitatifs.
- Des **tests de régression** : des jeux de test gold-standard vérifient que les modifications n'introduisent pas de dégradation.
- Des métriques spécifiques au RAG : faithfulness (le modèle respecte-t-il les sources ?), answer relevancy, context precision.
**3\. Monitoring en production**
Au-delà des métriques système (latence, taux d'erreur, disponibilité), le LLMOps monitore :
- La **qualité des réponses** en continu, via des mécanismes de feedback utilisateur et des evals automatiques.
- Les **coûts par requête** : nombre de tokens consommés, coût par appel, répartition par fonctionnalité.
- Les **patterns d'usage** : quels types de questions les utilisateurs posent, quels sujets génèrent le plus d'erreurs.
- La **détection d'abus** : prompt injection, tentatives de contournement des guardrails.
**4\. Guardrails et sécurité**
Les LLM peuvent générer du contenu inapproprié, divulguer des informations sensibles, ou être manipulés par des prompts malveillants. Le LLMOps met en place des couches de protection :
- Filtrage des entrées (détection de prompt injection).
- Filtrage des sorties (contenu inapproprié, données personnelles).
- Limites de tokens et de requêtes par utilisateur.
- Logging et audit trail pour la conformité.
**5\. Orchestration et infrastructure**
Le déploiement de LLM implique des choix d'infrastructure : API managée vs modèle auto-hébergé, GPU vs CPU, caching des réponses, load balancing entre providers. Les frameworks d'orchestration comme LangChain, LlamaIndex ou Haystack fournissent des abstractions pour gérer cette complexité.
### LLMOps et data governance
Les enjeux de data governance s'appliquent pleinement au LLMOps. Quelles données envoie-t-on au LLM ? Sont-elles conformes au RGPD ? L'AI Act impose-t-il des obligations de transparence pour ce cas d'usage ? Ces questions doivent être traitées dès la conception du système, pas après le déploiement.
### L'outillage LLMOps
L'écosystème d'outils LLMOps s'est rapidement structuré :
- **Observabilité** : LangSmith, Langfuse, Phoenix (Arize), Helicone.
- **Gestion de prompts** : PromptLayer, Humanloop, Portkey.
- **Évaluation** : RAGAS, DeepEval, Promptfoo.
- **Orchestration** : LangChain, LlamaIndex, LangGraph.
- **Gateway / routing** : Portkey, LiteLLM, Azure API Management.
Le choix des outils dépend de la maturité de l'équipe et du volume de requêtes. En phase de prototypage, un logging basique suffit. En production, une stack d'observabilité structurée devient indispensable.
---
### Qu'est-ce que le loop engineering ?
Source : https://www.hymaia.com/qu-est-ce-que/loop-engineering-orchestration-autonome/
Le loop engineering est une évolution du travail avec des agents IA : plutôt que de les prompter manuellement à chaque étape, on les laisse s'orchestrer eux-mêmes dans une boucle, avec accès à des skills, des outils et une mémoire persistante. Le développeur reste au centre, en charge des skills et de la vérification.
Le **loop engineering** n'est pas une approche radicalement nouvelle du travail de développement avec l'IA, mais une évolution de ce que la plupart des développeurs font déjà. Le principe d'une loop n'est pas de prompter manuellement les agents à chaque étape, mais de les laisser s'orchestrer eux-mêmes au sein d'un cycle.
### Ce qui compose une loop
Dans une loop, les agents ont accès à trois ressources :
- **Des skills**, qui encadrent la manière dont l'agent doit exécuter une tâche donnée.
- **Des outils**, qu'il mobilise pour agir concrètement (exécuter du code, lire des fichiers, appeler des services externes).
- **Une mémoire**, qu'il peut lire et écrire pour garder une trace de l'avancement et apprendre de ses propres erreurs d'une itération à l'autre.
Cette combinaison permet à l'agent de tourner sur plusieurs cycles sans qu'un humain intervienne à chaque étape pour reformuler une instruction.
### Le développeur reste au centre de la loop
Même si une loop repose sur beaucoup de délégation, le loop engineering ne consiste pas à se retirer du processus. Le développeur reste au centre de deux dimensions :
**La conception des skills et des outils.** C'est à lui de réaliser les skills et les outils nécessaires à l'exécution de la loop — sans eux, l'agent n'a ni cadre ni moyen d'agir.
**La vérification.** C'est le poids central du loop engineering : c'est le développeur qui vérifie que ce que produit la boucle est correct, avant de la laisser continuer ou de la relancer.
### Un outil à utiliser à bon escient
Le loop engineering n'a pas vocation à remplacer toutes les façons de travailler avec un agent IA. Il n'y a pas d'obligation à tout faire tourner en boucle : l'intérêt est de l'utiliser dans des moments spécifiques de son usine logicielle, là où la répétition d'un cycle de délégation, exécution et vérification apporte un vrai gain, plutôt que de le systématiser partout.
---
### Qu'est-ce que le MCP (Model Context Protocol) ?
Source : https://www.hymaia.com/qu-est-ce-que/mcp-model-context-protocol/
Le MCP (Model Context Protocol) est un protocole open-source créé par Anthropic qui standardise la connexion entre les LLM et les sources de données ou outils externes. Il joue pour l'IA le rôle que l'USB a joué pour les périphériques : une interface universelle.
Le **MCP (Model Context Protocol)** est un protocole de communication open-source, publié par Anthropic en novembre 2024, qui définit une interface standardisée pour connecter les modèles de langage (LLM) à des sources de données et des outils externes. Avant MCP, chaque intégration entre un LLM et un outil (base de données, API, système de fichiers, application SaaS) nécessitait un connecteur spécifique. MCP propose une convention unique que les deux parties — le LLM et l'outil — peuvent implémenter une fois pour toutes.
### Le problème que MCP résout
Un LLM seul est puissant pour le langage, mais isolé. Pour être utile en entreprise, il doit accéder à des données internes (CRM, documentation, bases de données) et déclencher des actions (créer un ticket, envoyer un email, modifier un fichier). Sans standard, chaque fournisseur de LLM développe ses propres conventions d'intégration, et chaque outil doit implémenter autant de connecteurs qu'il y a de LLM à supporter.
C'est le problème classique du M x N : M modèles fois N outils = M x N intégrations à maintenir. MCP réduit cette complexité à M + N : chaque modèle implémente le protocole MCP (côté client), chaque outil implémente le protocole MCP (côté serveur), et tous deviennent interopérables.
### Architecture du protocole
MCP repose sur une architecture client-serveur :
**Le MCP Host** est l'application qui utilise le LLM (un IDE, un chatbot, un agent). Il intègre un client MCP qui sait communiquer avec les serveurs.
**Le MCP Server** est un programme léger qui expose les capacités d'un outil ou d'une source de données. Il déclare ce qu'il sait faire via trois primitives :
- **Tools** : des fonctions que le LLM peut appeler (ex : "rechercher dans la base de données", "créer un ticket Jira", "lire un fichier"). C'est la primitive la plus utilisée.
- **Resources** : des données que le LLM peut consulter (ex : contenu d'un fichier, résultat d'une requête SQL). Les resources sont l'équivalent d'un endpoint GET en REST.
- **Prompts** : des templates d'instructions prédéfinis que le serveur propose au LLM pour des tâches spécifiques.
La communication entre client et serveur se fait via JSON-RPC 2.0, sur des transports variés : stdio (processus local), HTTP avec Server-Sent Events, ou tout autre transport supportant des messages bidirectionnels.
### Adoption et écosystème
L'adoption de MCP a été rapide. Quelques mois après sa publication, le protocole est supporté nativement par Claude Desktop, Cursor, Windsurf, Zed, Sourcegraph et plusieurs autres outils. Des centaines de serveurs MCP communautaires sont disponibles sur GitHub, couvrant des intégrations avec Slack, GitHub, PostgreSQL, Google Drive, Notion, Jira, et bien d'autres.
OpenAI a annoncé le support de MCP dans ses produits en mars 2025, renforçant sa position comme standard émergent de l'industrie. Google DeepMind et d'autres acteurs ont également signalé leur intérêt.
### MCP et l'IA agentique
MCP est un catalyseur direct de l'IA agentique. Un agent IA qui doit accomplir une tâche complexe a besoin d'interagir avec de multiples outils : lire des documents, interroger des API, exécuter du code, modifier des fichiers. Sans MCP, chaque intégration est un développement spécifique. Avec MCP, l'agent peut se connecter dynamiquement à tout outil qui expose un serveur MCP.
Cette interopérabilité est particulièrement précieuse dans les architectures multi-agents, où chaque agent spécialisé peut avoir accès à un ensemble différent d'outils MCP selon son rôle.
### Développer un serveur MCP
Créer un serveur MCP est relativement accessible. Les SDK officiels existent en TypeScript et Python, et la communauté a développé des SDK pour Kotlin, Go, Rust et d'autres langages. Un serveur minimal qui expose une ou deux fonctions peut être écrit en quelques dizaines de lignes.
L'effort principal réside dans la conception des tools : choisir le bon niveau de granularité, rédiger des descriptions claires (c'est le LLM qui décide quand appeler un tool en se basant sur sa description), et gérer les erreurs proprement.
### Sécurité et gouvernance
MCP soulève des questions de sécurité importantes. Un serveur MCP donne au LLM la capacité d'agir sur des systèmes réels. Les bonnes pratiques incluent :
- **Principe du moindre privilège.** Un serveur MCP ne devrait exposer que les capacités strictement nécessaires.
- **Validation des entrées.** Les paramètres envoyés par le LLM doivent être validés côté serveur — un LLM peut envoyer des requêtes malformées ou exploitées via une injection de prompt.
- **Audit et logging.** Tracer tous les appels de tools pour la gouvernance et le débogage.
- **Approbation humaine.** Pour les actions critiques (suppression de données, envoi d'emails, transactions financières), implémenter un mécanisme de confirmation humaine.
### Limites actuelles
MCP est encore un protocole jeune. La spécification évolue rapidement, la gestion de l'authentification entre clients et serveurs distants fait l'objet de travaux actifs (OAuth 2.0 et transport HTTP streamable ajoutés en 2025), et l'écosystème de serveurs communautaires varie en qualité et en maturité. Le protocole gagne en robustesse à chaque itération, mais les équipes qui l'adoptent doivent accepter un certain niveau de mouvement.
---
### Qu'est-ce qu'un ML Engineer ?
Source : https://www.hymaia.com/qu-est-ce-que/ml-engineer/
Le ML Engineer concoit, entraine et deploie des modeles de machine learning en production. A mi-chemin entre Data Scientist et ingenieur logiciel, il transforme les prototypes en systemes fiables et scalables.
Le ML Engineer (Machine Learning Engineer) est un profil technique qui fait le pont entre la recherche en data science et la mise en production de modeles de machine learning. La ou le Data Scientist explore les donnees et developpe des prototypes de modeles, le ML Engineer prend le relais pour transformer ces prototypes en systemes robustes, performants et maintenables.
### Responsabilites principales
Le perimetre du ML Engineer couvre l'ensemble du cycle de vie d'un modele, de l'entrainement au deploiement :
- **Entrainement et optimisation des modeles** : selection d'architectures, tuning des hyperparametres, gestion des jeux de donnees d'entrainement. Le ML Engineer optimise le compromis entre performance du modele et cout computationnel.
- **Mise en production** : packaging des modeles, creation d'APIs d'inference, deploiement sur des infrastructures Cloud (conteneurs, serverless, GPU). L'objectif est qu'un modele qui fonctionne en notebook fonctionne aussi en production, avec des temps de reponse acceptables.
- **Feature engineering** : conception et maintenance des pipelines de features. Le ML Engineer travaille souvent avec un Feature Store pour garantir la coherence entre les features d'entrainement et celles utilisees en inference.
- **Monitoring et retraining** : surveillance du Data Drift et de la degradation des performances en production. Mise en place de pipelines de reentrainement automatique quand les metriques passent sous un seuil defini.
### Competences techniques
Le ML Engineer maitrisse un spectre large de technologies :
- **Langages** : Python principalement, parfois Scala ou Java pour les systemes distribues.
- **Frameworks ML** : PyTorch, TensorFlow, scikit-learn, XGBoost, et plus recemment les frameworks d'IA generative pour travailler avec des LLM (fine-tuning, inference optimisee).
- **Infrastructure** : Docker, Kubernetes, services Cloud (AWS SageMaker, Google Vertex AI, Azure ML). La maitrise de l'infrastructure est ce qui distingue le ML Engineer du Data Scientist.
- **Outils MLOps** : MLflow, Weights & Biases, DVC pour le versionnement des modeles et des donnees, le tracking d'experiences et la reproductibilite.
### Difference avec les roles proches
La frontiere entre ML Engineer, Data Scientist et MLOps Engineer est parfois floue, mais les orientations different :
- Le **Data Scientist** est davantage tourne vers l'exploration, l'analyse statistique et la construction de prototypes. Son livrable principal est un modele qui fonctionne, pas forcement un systeme en production.
- Le **ML Engineer** prend ce modele et l'industrialise. Il ecrit du code de production, gere les pipelines d'entrainement, et s'assure que le modele repond aux exigences de latence et de fiabilite.
- Le **MLOps Engineer** se concentre sur l'infrastructure et l'automatisation : CI/CD des modeles, orchestration des pipelines, monitoring. C'est l'equivalent du DevOps pour le machine learning.
En pratique, dans les petites equipes, un meme profil cumule souvent ces responsabilites. Dans les organisations plus matures, la specialisation permet a chacun d'approfondir son domaine.
### Le ML Engineer face a l'IA generative
L'essor des LLM et de l'IA generative a fait evoluer le role. Le ML Engineer travaille desormais sur le fine-tuning de modeles de fondation, l'optimisation d'inference (quantization, distillation), et l'integration de modeles generatifs dans des applications via des architectures RAG ou des systemes d'Agents IA.
La methodologie CRISP-ML reste pertinente pour structurer ces projets, mais les cycles sont plus courts et les feedbacks utilisateurs plus directs. Le ML Engineer doit aussi collaborer etroitement avec les Data Engineers pour garantir l'acces aux donnees de qualite necessaires a l'entrainement et au fonctionnement de ces systemes.
### Ou travaille un ML Engineer
On trouve des ML Engineers dans les equipes data des entreprises tech, dans les equipes produit qui integrent du ML (recommandation, recherche, personnalisation), dans les cabinets de conseil specialises en data et IA, et dans les startups IA. La demande pour ce profil est forte, alimentee par la generalisation du machine learning dans tous les secteurs.
---
### Qu'est-ce que le MLOps ?
Source : https://www.hymaia.com/qu-est-ce-que/mlops/
Le MLOps applique les principes du DevOps au machine learning : automatisation du deploiement, monitoring des modeles en production et gestion du cycle de vie complet, de l'entrainement au reentrainement.
Le MLOps (Machine Learning Operations) est un ensemble de pratiques qui vise a automatiser et fiabiliser le deploiement et la maintenance de modeles de machine learning en production. Ne de la rencontre entre le DevOps et le machine learning, le MLOps repond a un constat simple : la majorite des modeles ML ne depassent jamais le stade du prototype. Industrialiser le ML necessite des processus specifiques que le DevOps classique ne couvre pas.
### Pourquoi le MLOps existe
Un modele de machine learning n'est pas un logiciel comme les autres. Son comportement depend de ses donnees d'entrainement, et ces donnees evoluent dans le temps. Un modele de detection de fraude entraine sur les patterns de 2023 peut devenir inefficace face aux nouvelles techniques de 2025. Ce phenomene, appele Data Drift, impose un monitoring continu et des mecanismes de reentrainement que le DevOps traditionnel ne prevoit pas.
Le MLOps formalise les reponses a ces defis specifiques au ML : comment versionner un modele et ses donnees, comment automatiser l'entrainement, comment detecter une degradation de performance en production, comment garantir la reproductibilite d'une experience.
### Les cinq piliers du MLOps
**1\. Automatisation**
Automatiser les taches repetitives du cycle de vie ML : preparation des donnees, entrainement, evaluation, deploiement. L'objectif est de passer d'un processus ou un Data Scientist execute manuellement des notebooks a un pipeline reproductible et declenchable a la demande. Les outils comme Kubeflow, Apache Airflow ou les services manages Cloud (AWS SageMaker Pipelines, Google Vertex AI) facilitent cette automatisation.
**2\. Collaboration**
Le MLOps cree un langage commun entre Data Scientists, ML Engineers, MLOps Engineers et equipes metier. Les Data Scientists se concentrent sur la modelisation, les ML Engineers sur l'industrialisation, les MLOps Engineers sur l'infrastructure. Des outils partages (MLflow pour le tracking d'experiences, un Feature Store pour les features) permettent a chacun de travailler efficacement sans silos.
**3\. Reproductibilite**
Chaque experience doit pouvoir etre reproduite exactement : memes donnees, meme code, memes hyperparametres, meme resultat. Cela implique le versionnement des datasets (DVC, Delta Lake), le tracking des experiences (MLflow, Weights & Biases), et la conteneurisation des environnements d'execution. Sans reproductibilite, le debugging et l'audit deviennent impossibles.
**4\. Gestion des versions**
Au-dela du code, le MLOps impose de versionner les modeles, les datasets et les configurations. Un modele en production doit etre tracable : quelle version du code l'a produit, sur quelles donnees il a ete entraine, avec quels hyperparametres. C'est indispensable pour la Data Governance et pour repondre aux exigences reglementaires, notamment celles de l'AI Act europeen.
**5\. Monitoring continu**
Surveiller les performances d'un modele en production ne se limite pas aux metriques techniques (latence, disponibilite). Il faut aussi suivre les metriques ML : precision, recall, F1-score sur les predictions reelles, detection du data drift et du concept drift. Quand les performances se degradent, le pipeline de reentrainement se declenche automatiquement ou alerte l'equipe.
### Niveaux de maturite
Google a propose une echelle de maturite MLOps en trois niveaux :
- **Niveau 0 - Manuel** : les Data Scientists entrainent les modeles manuellement, le deploiement est ad hoc. C'est le point de depart de la plupart des organisations.
- **Niveau 1 - Pipeline ML automatise** : l'entrainement est orchestre dans un pipeline reproductible, le reentrainement est automatique. La Data Platform fournit les donnees de maniere fiable.
- **Niveau 2 - CI/CD ML** : le pipeline lui-meme est versionne et teste, avec integration continue du code et des modeles. C'est l'etat de l'art, atteint par peu d'organisations.
### Du MLOps au LLMOps
L'emergence des LLM et de l'IA generative a fait naitre le concept de LLMOps. Les principes du MLOps s'appliquent, mais avec des specificites : gestion des prompts (versionnement, evaluation), monitoring des couts d'inference (les LLM sont chers), evaluation de la qualite des generations (plus subjective que des metriques classiques), et orchestration de systemes multi-agents. Le MLOps reste le socle sur lequel le LLMOps se construit.
### MLOps en pratique
Adopter le MLOps ne necessite pas de tout automatiser d'un coup. La progression recommandee est incrementale : commencer par versionner le code et les donnees, puis automatiser l'entrainement, puis mettre en place le monitoring, puis automatiser le reentrainement. Chaque etape apporte de la valeur. La methodologie CRISP-ML propose un cadre pour structurer cette progression tout au long du cycle de vie d'un projet ML.
---
### Qu'est-ce qu'un MLOps Engineer ?
Source : https://www.hymaia.com/qu-est-ce-que/mlops-engineer/
Le MLOps Engineer automatise le cycle de vie des modeles de machine learning en production : pipelines d'entrainement, deploiement, monitoring et qualite des donnees. C'est le DevOps du ML.
Le MLOps Engineer applique les principes du DevOps au cycle de vie des modeles de machine learning. Son objectif : faire en sorte que les modeles developpes par les Data Scientists et ML Engineers arrivent en production de maniere fiable, reproductible et automatisee, puis y restent performants dans la duree.
### Les cinq responsabilites cles
Le role du MLOps Engineer s'articule autour de cinq axes principaux :
**1\. Automatisation des pipelines ML**
Le MLOps Engineer concoit et maintient les pipelines qui couvrent l'ensemble du cycle de vie d'un modele : ingestion des donnees d'entrainement, preprocessing, entrainement, evaluation, deploiement. L'objectif est qu'un nouveau modele puisse passer du code a la production avec un minimum d'interventions manuelles. Les outils de reference incluent Kubeflow Pipelines, Apache Airflow, et les services manages comme AWS SageMaker Pipelines ou Google Vertex AI Pipelines.
**2\. Integration et livraison continues (CI/CD)**
Contrairement au CI/CD classique qui ne teste que du code, le CI/CD pour le ML doit aussi valider les donnees et les performances du modele. Le MLOps Engineer met en place des pipelines qui executent automatiquement des tests unitaires sur le code, des tests de validation sur les donnees (schema, distribution, completude), et des tests de performance sur le modele (metriques de reference, tests de non-regression). Un modele n'est deploye que s'il passe l'ensemble de ces etapes.
**3\. Monitoring et observabilite**
Une fois en production, un modele peut se degrader silencieusement. Le MLOps Engineer configure la surveillance du Data Drift (evolution de la distribution des donnees d'entree), du concept drift (evolution de la relation entre features et cible), et des metriques metier. Il met en place des alertes et, dans les architectures les plus matures, des pipelines de reentrainement automatique declenches par la detection d'une degradation. La methodologie CRISP-ML fournit un cadre utile pour structurer ce monitoring.
**4\. Gestion de la qualite des donnees**
La performance d'un modele depend directement de la qualite de ses donnees. Le MLOps Engineer travaille avec les Data Engineers pour mettre en place des controles de qualite en amont des pipelines : detection d'anomalies dans les donnees entrantes, validation de schemas, monitoring de la completude et de la fraicheur. Le Feature Store centralise les features validees et garantit la coherence entre entrainement et inference.
**5\. Conformite et securite**
Dans les secteurs reglementes (finance, sante, assurance), le MLOps Engineer doit garantir la tracabilite des modeles : quelle version est en production, avec quelles donnees elle a ete entrainee, quels resultats elle produit. Cela implique le versionnement systematique des modeles et des datasets, la gestion des acces, et la mise en place de mecanismes d'audit. L'AI Act europeen renforce ces exigences pour les systemes d'IA a haut risque.
### Outils et stack technique
Le MLOps Engineer travaille a l'intersection de l'infrastructure Cloud, de l'ingenierie logicielle et du machine learning :
- **Orchestration** : Airflow, Dagster, Prefect
- **Experiment tracking** : MLflow, Weights & Biases, Neptune
- **Serving** : TensorFlow Serving, Triton Inference Server, BentoML
- **Infrastructure** : Kubernetes, Docker, Terraform
- **Cloud** : AWS (SageMaker, ECS), GCP (Vertex AI), Azure ML
### Difference avec le ML Engineer
Le ML Engineer et le MLOps Engineer travaillent en tandem, mais leurs focales different. Le ML Engineer se concentre sur la construction des modeles : architecture, entrainement, optimisation. Le MLOps Engineer se concentre sur l'infrastructure et les processus qui permettent a ces modeles de fonctionner en production de maniere fiable. En pratique, la frontiere est poreuse : dans les petites equipes, un meme profil porte les deux casquettes.
### Evolution vers le LLMOps
Avec l'essor de l'IA generative et des LLM, le role du MLOps Engineer evolue. Les pipelines classiques (entrainement, deploiement, monitoring) s'enrichissent de problematiques nouvelles : gestion des prompts, orchestration d'Agents IA, evaluation de la qualite des generations, monitoring des couts d'inference. Le terme LLMOps emerge pour decrire cette specialisation, mais les fondamentaux restent les memes : automatiser, surveiller, garantir la fiabilite.
---
### Qu'est-ce qu'une Modern Data Stack ?
Source : https://www.hymaia.com/qu-est-ce-que/modern-data-stack/
La Modern Data Stack designe l'ensemble des outils cloud-native utilises pour collecter, stocker, transformer et analyser les donnees. Elle remplace les architectures monolithiques par des briques specialisees et interoperables.
La Modern Data Stack (MDS) est une architecture de donnees composee d'outils cloud-native, modulaires et specialises, conçus pour fonctionner ensemble. Elle s'oppose aux solutions monolithiques traditionnelles (Informatica, SSIS, Teradata on-premise) en privilegiant des briques best-of-breed interconnectees via des APIs et des formats standards.
### Origines et contexte
Le concept a emerge au debut des annees 2020, porte par la convergence de plusieurs facteurs : la maturite du Cloud (AWS, GCP, Azure), l'essor des entrepots de donnees cloud-native comme Snowflake et BigQuery, et l'emergence d'outils open source puissants comme dbt et Airflow. L'idee fondatrice : une equipe de Data Engineers et d'Analytics Engineers doit pouvoir monter une Data Platform performante en quelques semaines, pas en quelques mois.
### Les cinq couches de la Modern Data Stack
**1\. Ingestion des donnees**
La premiere etape consiste a collecter les donnees depuis les sources operationnelles : bases de donnees, APIs, SaaS, fichiers, evenements. Les outils specialises comme Fivetran, Airbyte (open source) ou Stitch automatisent la replication des donnees vers l'entrepot. Pour les besoins en temps reel, Apache Kafka ou AWS Kinesis gerent le streaming. L'Ingestion Batch reste le pattern dominant pour la majorite des cas d'usage analytiques.
**2\. Stockage des donnees**
Le coeur de la MDS est l'entrepot de donnees cloud-native (cloud data warehouse). Snowflake, Google BigQuery et Amazon Redshift sont les trois acteurs dominants. Ils separent le stockage du calcul, permettant de scaler independamment. Pour les cas d'usage qui necessitent du stockage brut (data lake), Amazon S3, Google Cloud Storage ou Azure Data Lake Storage sont utilises, souvent avec des formats ouverts comme Parquet ou Delta Lake.
**3\. Transformation des donnees**
C'est la couche ou les donnees brutes deviennent exploitables. dbt (data build tool) a revolutionne cette etape en permettant aux Analytics Engineers d'ecrire des transformations en SQL, versionnees dans Git, testees et documentees. Apache Spark reste utilise pour les transformations complexes ou les tres gros volumes. Cette couche est aussi celle ou se materialise le Data Lineage : tracer la provenance et les transformations de chaque donnee.
**4\. Analyse et visualisation**
Les donnees transformees sont consommees par des outils de BI et d'exploration. Looker, Tableau et Power BI sont les leaders. Metabase et Apache Superset offrent des alternatives open source. La tendance recente est au "metrics layer" : definir les metriques metier une seule fois (dans dbt ou un outil dedie) pour garantir la coherence entre tous les dashboards.
**5\. Gouvernance et qualite**
La couche transversale qui garantit la fiabilite de l'ensemble. La Data Governance couvre la gestion des acces, la conformite reglementaire (RGPD), la documentation des donnees et le catalogage. Des outils comme Monte Carlo, Soda ou Great Expectations assurent la surveillance de la qualite des donnees. Le Data Lineage, fourni nativement par dbt ou par des outils dedies comme Atlan, permet de comprendre l'impact d'un changement sur l'ensemble de la chaine.
### Forces et limites
La MDS apporte une flexibilite reelle : chaque brique peut etre remplacee independamment, les couts sont variables (pay-as-you-go), et le time-to-value est court. Une equipe de 2-3 Data Engineers peut deployer une stack complete en quelques semaines.
Mais cette modularite a un cout. La multiplication des outils genere de la complexite operationnelle : gestion de multiples comptes, contrats, versions, interfaces. Le "Modern Data Stack Tax" — le cout cumule des abonnements SaaS — peut devenir significatif. C'est pourquoi certaines organisations evoluent vers des plateformes plus integrees (Databricks, Snowflake avec ses extensions natives) tout en conservant les principes fondamentaux de la MDS.
### Qui opere la Modern Data Stack
Le Data Engineer concoit et maintient l'infrastructure et les pipelines. L'Analytics Engineer ecrit les transformations et les tests dans dbt. Le Data Analyst consomme les donnees transformees pour produire des analyses. Le Data Steward veille a la gouvernance et a la qualite. Cette repartition des roles est une caracteristique de la MDS : chaque profil a des outils adaptes a son niveau d'expertise technique.
### Evolution : de la MDS au data lakehouse
La frontiere entre data warehouse et data lake s'estompe. Le concept de data lakehouse, popularise par Databricks avec Delta Lake, promet de combiner la performance analytique du warehouse avec la flexibilite du lake. Les formats ouverts (Apache Iceberg, Delta Lake, Apache Hudi) permettent de requeter des donnees stockees dans un lake avec les performances d'un warehouse. C'est probablement la prochaine etape de l'evolution de la Modern Data Stack.
---
### Qu'est-ce que l'orchestration multi-agents en IA ?
Source : https://www.hymaia.com/qu-est-ce-que/orchestration-multi-agents/
L'orchestration multi-agents désigne la coordination de plusieurs agents IA spécialisés qui collaborent pour résoudre des tâches complexes. Chaque agent a un rôle et des outils propres, un orchestrateur gérant le flux d'exécution, la délégation et la synthèse des résultats.
L'**orchestration multi-agents** est une architecture logicielle où plusieurs agents IA autonomes, chacun spécialisé dans un domaine ou une compétence, travaillent de concert sous la coordination d'un système d'orchestration. Plutôt que de confier une tâche complexe à un seul agent généraliste, on la décompose en sous-tâches confiées à des agents experts qui collaborent pour produire un résultat final.
### Pourquoi plusieurs agents plutôt qu'un seul ?
Un agent unique, même basé sur un LLM performant, atteint ses limites face à des tâches complexes et multi-étapes. Les raisons sont à la fois techniques et organisationnelles :
**La spécialisation améliore la qualité.** Un agent dédié à l'analyse de code, avec un prompt système optimisé et des outils spécifiques (linter, compilateur, documentation), sera plus performant sur cette tâche qu'un agent généraliste. Le context engineering est plus efficace quand le contexte est ciblé.
**La décomposition réduit les erreurs.** Quand un LLM doit gérer une tâche longue avec de multiples étapes, la probabilité d'erreur augmente à chaque étape. Décomposer en sous-tâches indépendantes permet d'isoler et de corriger les erreurs localement.
**L'extensibilité.** Ajouter une nouvelle capacité au système revient à ajouter un nouvel agent, sans modifier les agents existants. C'est le même principe que les microservices en architecture logicielle.
### Les patterns d'orchestration
L'orchestration multi-agents s'organise selon plusieurs patterns architecturaux :
**Pattern séquentiel (pipeline).** Les agents s'exécutent les uns après les autres, chacun prenant en entrée la sortie du précédent. Exemple : un agent analyse un document, un second extrait les points clés, un troisième rédige un résumé. Simple à implémenter, mais lent car pas de parallélisme.
**Pattern parallèle (fan-out / fan-in).** Plusieurs agents travaillent simultanément sur des sous-tâches indépendantes, puis leurs résultats sont agrégés. Exemple : trois agents analysent respectivement les aspects juridique, financier et technique d'un appel d'offre, puis un agent de synthèse consolide. Plus rapide, mais plus complexe à coordonner.
**Pattern hiérarchique (supervisor).** Un agent superviseur décompose la tâche, la délègue à des agents spécialisés, évalue leurs résultats et décide des prochaines étapes. C'est le pattern le plus flexible : le superviseur peut re-router, corriger ou combiner les résultats selon leur qualité.
**Pattern débat (adversarial).** Deux ou plusieurs agents défendent des positions différentes, et un agent juge tranche. Utile pour les décisions où il faut examiner plusieurs perspectives (analyse de risque, choix stratégique).
**Pattern réflexion.** Un agent génère une réponse, un second la critique, le premier corrige. Ce cycle peut se répéter plusieurs fois. Ce pattern améliore la qualité des réponses, notamment pour la génération de code ou l'analyse complexe.
### Les frameworks d'orchestration
Plusieurs frameworks open source facilitent la mise en œuvre de systèmes multi-agents :
- **LangGraph** (LangChain) : modélise les workflows d'agents comme des graphes orientés, avec des nœuds (agents) et des arêtes (transitions). Supporte les boucles, les conditions et la persistance d'état.
- **CrewAI** : abstraction de haut niveau où l'on définit des "agents" avec des rôles, des objectifs et des outils, regroupés en "crews" qui collaborent. Approche plus déclarative.
- **AutoGen** (Microsoft) : framework centré sur les conversations multi-agents, où les agents échangent des messages dans un protocole conversationnel.
- **Semantic Kernel** (Microsoft) : framework orienté entreprise, intégré à l'écosystème Azure.
Le choix du framework dépend du pattern d'orchestration souhaité, du niveau de contrôle nécessaire et de l'écosystème technologique de l'équipe.
### Défis de l'orchestration multi-agents
**La propagation des erreurs.** Si un agent en amont produit une sortie erronée, les agents en aval peuvent amplifier l'erreur. Les hallucinations d'un LLM se propagent d'agent en agent. La mise en place de checkpoints de validation entre agents est indispensable.
**Le coût et la latence.** Chaque agent effectue un ou plusieurs appels LLM. Un système multi-agents peut consommer 5 à 20 fois plus de tokens qu'un agent unique. L'optimisation des coûts passe par le choix de modèles moins coûteux pour les tâches simples et de modèles puissants uniquement pour les tâches critiques.
**L'observabilité.** Débugger un système multi-agents est nettement plus complexe que débugger un agent unique. Les outils de LLMOps (LangSmith, Langfuse) permettent de tracer chaque étape du workflow, chaque appel LLM, chaque décision de routage.
**La gestion de l'état.** Les agents doivent partager un contexte commun (mémoire partagée) tout en maintenant leur contexte propre. La gestion de cet état partagé est un enjeu architectural non trivial.
### Cas d'usage en entreprise
L'orchestration multi-agents trouve sa place dans des scénarios où la complexité dépasse la capacité d'un agent unique :
- **Analyse documentaire** : extraction, classification, vérification et synthèse de documents contractuels.
- **Support client avancé** : un agent qualifie la demande, un second recherche dans la base de connaissances, un troisième rédige la réponse.
- **Due diligence automatisée** : analyse simultanée des dimensions juridique, financière et opérationnelle.
- **Génération de contenu** : un agent rédige, un second vérifie les faits, un troisième optimise le SEO.
---
### Qu'est-ce qu'une organisation AI-native ?
Source : https://www.hymaia.com/qu-est-ce-que/organisation-ai-native/
Une organisation AI-native est une entreprise conçue ou transformée pour fonctionner avec l'IA au coeur de ses processus, produits et culture. Au-delà de l'adoption ponctuelle d'outils, elle repense ses façons de travailler, ses rôles et sa gouvernance autour des capacités de l'intelligence artificielle.
Une **organisation AI-native** est une entreprise qui intègre l'intelligence artificielle non pas comme un outil supplémentaire, mais comme un principe structurant de son fonctionnement. Le terme trace un parallèle avec les entreprises "cloud-native" ou "digital-native" : il ne s'agit pas d'ajouter une couche d'IA sur des processus existants, mais de repenser l'organisation elle-même autour des capacités et des contraintes de l'IA.
### La différence entre "utiliser l'IA" et "être AI-native"
Beaucoup d'entreprises utilisent l'IA : un chatbot de support client ici, un outil de synthèse de documents là, un modèle de prédiction dans l'équipe data. Ces usages, aussi utiles soient-ils, restent périphériques — des greffes sur un fonctionnement qui n'a pas fondamentalement changé.
Une organisation AI-native fonctionne différemment à plusieurs niveaux :
- **Les processus sont conçus pour l'IA dès le départ.** Au lieu d'automatiser un processus existant, on conçoit le processus en partant de ce que l'IA sait faire, et on ajoute l'humain là où il apporte le plus de valeur.
- **Les rôles évoluent.** Des fonctions nouvelles apparaissent (AI Champions, prompt engineers, AI product managers) et les fonctions existantes intègrent l'IA dans leurs compétences de base.
- **La culture valorise l'expérimentation avec l'IA.** Les équipes sont encouragées à tester de nouveaux usages, à mesurer les résultats, et à partager les apprentissages.
- **La gouvernance encadre l'IA structurellement.** Les politiques de data governance, les guardrails et la conformité réglementaire (AI Act) sont intégrés dès la conception, pas ajoutés après coup.
### Les piliers d'une organisation AI-native
**1\. Stratégie et leadership.**
La direction porte une vision claire de ce que l'IA change pour l'entreprise — pas en termes de technologie, mais en termes de modèle économique, d'avantage concurrentiel et de proposition de valeur. Cette vision se traduit en objectifs mesurables : gains de productivité par fonction, nouveaux produits rendus possibles par l'IA, amélioration de la satisfaction client.
**2\. Infrastructure et data platform.**
Une organisation AI-native dispose d'une data platform solide : données accessibles, qualité maîtrisée, pipelines fiables. Sans données de qualité, les systèmes d'IA ne produisent que du bruit. La data governance assure que les données sont classifiées, tracées et utilisables dans le respect des réglementations.
**3\. Produits et services augmentés.**
Les produits de l'entreprise intègrent l'IA comme composant natif, pas comme fonctionnalité optionnelle. Un produit SaaS AI-native ne propose pas un "assistant IA" en supplément — il utilise l'IA pour personnaliser l'expérience, anticiper les besoins et automatiser les tâches à faible valeur ajoutée. Les compound AI systems deviennent l'architecture de référence.
**4\. Processus internes redessinés.**
Les processus métier sont repensés pour tirer parti de l'IA : rédaction assistée pour le marketing, analyse automatisée pour la finance, scoring prédictif pour le commercial, revue de code augmentée pour l'engineering. Chaque processus est évalué sous l'angle : "Quel serait ce processus si on le concevait aujourd'hui avec l'IA ?"
**5\. Compétences et culture.**
La data literacy et l'AI literacy deviennent des compétences attendues de tous les collaborateurs, pas seulement des équipes techniques. Des programmes de formation (comme les formations AI Champion) diffusent les bonnes pratiques à travers l'organisation. Le Shadow AI est traité comme un signal d'adoption à canaliser, pas comme un problème à interdire.
**6\. Gouvernance et éthique.**
Un cadre clair définit les usages autorisés, les niveaux de risque, les exigences de supervision humaine et les mécanismes de contrôle (guardrails). Cette gouvernance n'est pas un frein — elle est ce qui permet à l'organisation de déployer l'IA à grande échelle en maîtrisant les risques.
### Le chemin de transformation
Aucune grande entreprise ne devient AI-native du jour au lendemain. La transformation suit généralement un parcours :
**Phase 1 — Expérimentation.** Des équipes pionnières testent des outils d'IA sur des cas d'usage ciblés. Les résultats sont mesurés, les retours collectés.
**Phase 2 — Industrialisation.** Les cas d'usage qui ont fait leurs preuves sont déployés à l'échelle. Des outils communs sont mis en place (plateforme d'IA, MLOps, guardrails). Les premiers rôles dédiés sont créés.
**Phase 3 — Intégration.** L'IA est intégrée dans les processus core de l'entreprise. Les KPIs métier intègrent l'impact de l'IA. La gouvernance est mature.
**Phase 4 — Réinvention.** L'entreprise repense ses produits, ses services et son modèle opérationnel autour de ce que l'IA rend possible. De nouvelles propositions de valeur émergent.
### AI-native vs AI-ready
L'**AI readiness** (maturité IA) évalue la capacité d'une organisation à adopter l'IA : qualité des données, compétences des équipes, infrastructure technique, culture du changement. C'est un pré-requis. Être AI-native va plus loin : c'est avoir franchi la transformation et fonctionner nativement avec l'IA au quotidien.
### Les freins courants
- **Silos organisationnels** : l'IA fonctionne mieux quand les données circulent entre équipes, ce qui se heurte aux organisations en silos.
- **Résistance au changement** : la peur du remplacement freine l'adoption. Un accompagnement transparent sur l'évolution des rôles est nécessaire.
- **Manque de données exploitables** : sans data platform ni data governance, les projets d'IA restent artisanaux.
- **Absence de vision stratégique** : sans direction claire du leadership, les initiatives d'IA restent fragmentées et sans impact structurel.
---
### Poetry : qu'est-ce que c'est et pourquoi l'utiliser ?
Source : https://www.hymaia.com/qu-est-ce-que/poetry-python/
Poetry est un outil de gestion de dependances et de packaging pour Python. Il unifie la declaration des dependances, la creation d'environnements virtuels et la publication de packages dans un seul workflow.
Poetry est un outil open source qui simplifie la gestion des dependances et le packaging de projets Python. Cree en 2018 par Sebastien Eustace, il repond a une frustration partagee par beaucoup de developpeurs Python : l'ecosysteme standard (pip, setuptools, virtualenv) est fragmente, avec plusieurs fichiers de configuration qui ne communiquent pas entre eux. Poetry unifie tout dans un seul fichier : \`pyproject.toml\`.
### Le probleme que Poetry resout
En Python, gerer les dependances a longtemps ete penible. Un projet typique utilisait \`requirements.txt\` pour lister les dependances, \`setup.py\` pour le packaging, et un outil separe (virtualenv, venv, conda) pour isoler l'environnement. Chaque fichier avait son propre format, et la coherence entre eux etait rarement garantie.
Le probleme le plus concret : \`pip install\` ne gere pas la resolution de dependances de maniere deterministe. Deux installations successives du meme \`requirements.txt\` pouvaient donner des resultats differents selon l'ordre de resolution. C'est un vrai probleme en production, ou la reproductibilite est indispensable, notamment pour les projets de data science et de machine learning.
### Comment Poetry fonctionne
Poetry repose sur deux fichiers :
- **\`pyproject.toml\`** : le fichier de configuration principal. Il declare les metadonnees du projet (nom, version, description), les dependances de production, les dependances de developpement, et les contraintes de version. C'est un standard Python (PEP 518, PEP 621), pas un format proprietaire.
- **\`poetry.lock\`** : le fichier de verrouillage. Il enregistre les versions exactes de chaque dependance (y compris les sous-dependances) installees. Ce fichier garantit que tous les membres de l'equipe et les environnements de CI/CD utilisent exactement les memes versions.
La commande \`poetry install\` lit le lockfile et installe les versions exactes. La commande \`poetry add\` ajoute une dependance, resout les conflits de versions et met a jour le lockfile. La resolution est deterministe : meme entree, meme sortie, a chaque fois.
### Gestion des environnements virtuels
Poetry cree et gere automatiquement un environnement virtuel par projet. Pas besoin de lancer \`python -m venv\` ou d'activer manuellement un environnement. La commande \`poetry shell\` ouvre un shell dans l'environnement du projet, \`poetry run\` execute une commande dans cet environnement.
Par defaut, les environnements sont stockes dans un repertoire centralise (\`~/.cache/pypoetry/virtualenvs/\`), mais on peut configurer Poetry pour les creer dans le dossier du projet (\`poetry config virtualenvs.in-project true\`), ce qui facilite l'integration avec les IDE.
### Avantages par rapport a pip et conda
- **Determinisme** : le lockfile garantit des installations reproductibles. Avec pip, les versions resolues peuvent varier.
- **Separation dev/prod** : Poetry distingue nativement les dependances de production et de developpement. Avec pip, il faut maintenir plusieurs fichiers requirements.
- **Resolution de conflits** : Poetry detecte les conflits de versions avant l'installation, la ou pip peut installer des combinaisons incompatibles.
- **Packaging integre** : \`poetry build\` genere un package distribuable (wheel ou sdist), \`poetry publish\` le publie sur PyPI. Pas besoin de setuptools ni de twine.
Conda reste pertinent pour les projets qui necessitent des dependances non-Python (librairies C, GPU drivers), car il gere les packages systeme. Poetry se limite a l'ecosysteme Python.
### Poetry dans un projet data
Pour les Data Engineers et les ML Engineers, Poetry apporte une rigueur bienvenue dans les projets de donnees et de ML. Le lockfile garantit que le modele entraine localement utilise exactement les memes versions de librairies que l'environnement de production. C'est un prerequis pour la reproductibilite des experiences et pour le MLOps.
Les commandes utiles en contexte data :
- \`poetry add pandas numpy scikit-learn\` : ajouter des dependances data science
- \`poetry add --group dev pytest black mypy\` : ajouter des outils de developpement
- \`poetry export -f requirements.txt\` : generer un requirements.txt pour les environnements qui ne supportent pas Poetry (certains services Cloud)
### Alternatives et ecosysteme
Poetry n'est pas le seul outil dans cette categorie. **uv**, developpe par Astral (les createurs de ruff), est une alternative recente qui se distingue par sa vitesse d'execution (ecrit en Rust). **Pipenv** a ete un precurseur mais souffre de lenteurs de resolution. **PDM** est une autre option conforme aux standards PEP. Le choix depend des besoins du projet, mais Poetry reste le plus adopte en 2025, avec une communaute active et une documentation solide.
---
### Qu'est-ce qu'un Product Builder ?
Source : https://www.hymaia.com/qu-est-ce-que/product-builder/
Le Product Builder est un nouvel archétype du product manager qui utilise l'IA et les outils no-code pour prototyper, tester et itérer directement, sans dépendre systématiquement d'une équipe de développement. Il incarne l'évolution du rôle de PM à l'ère de l'IA générative et du vibe coding.
Le **Product Builder** est un profil émergent qui redéfinit les frontières du rôle de **Product Manager**. Là où le PM traditionnel définit le "quoi" et le "pourquoi" d'un produit en s'appuyant sur une équipe de développement pour le "comment", le Product Builder prend en charge une partie significative de la réalisation grâce aux outils d'IA générative, aux plateformes no-code/low-code et aux environnements de développement assistés par l'IA.
### L'émergence d'un nouveau profil
Le rôle de Product Builder n'a pas été décrété par un framework ou une certification. Il a émergé de la pratique, sous l'effet de deux forces convergentes :
**La démocratisation des outils de création.** Les plateformes no-code (Bubble, Webflow, Retool), les assistants de développement IA (GitHub Copilot, Cursor, Claude Code) et les outils de prototypage rapide permettent à des non-développeurs de construire des applications fonctionnelles. Ce qui nécessitait une équipe de 3 développeurs pendant 3 semaines peut, dans certains cas, être prototypé par une seule personne en quelques jours.
**Le vibe coding.** Ce terme, popularisé par Andrej Karpathy (co-fondateur d'OpenAI et ancien directeur IA de Tesla) début 2025, désigne l'approche consistant à coder en décrivant ce qu'on veut en langage naturel, en laissant l'IA générer le code, et en itérant par le dialogue plutôt que par l'écriture directe. Le vibe coding a considérablement abaissé la barrière technique pour passer d'une idée à un prototype fonctionnel.
### Ce que fait concrètement un Product Builder
Le Product Builder conserve les compétences fondamentales du Product Manager — discovery, priorisation, vision produit, compréhension du marché — mais y ajoute la capacité de construire lui-même :
**Prototypage rapide.** Le Product Builder crée des prototypes fonctionnels (pas juste des maquettes Figma) pour tester des hypothèses avec de vrais utilisateurs. Un chatbot interne, un dashboard, un workflow automatisé, un outil de scoring : autant de solutions qu'il peut assembler et déployer rapidement.
**Validation par l'usage.** Au lieu de rédiger un PRD (Product Requirements Document) détaillé et d'attendre que l'équipe de développement livre un MVP dans 3 mois, le Product Builder peut tester une idée en quelques jours. Si l'hypothèse est invalidée, le coût est minimal. Si elle est validée, le prototype sert de base pour un développement plus robuste.
**Automatisation de processus.** Le Product Builder identifie et automatise des processus métiers en combinant des outils IA, des APIs et des plateformes d'automatisation (n8n, Make, Zapier). Il n'attend pas qu'un projet de développement soit priorisé dans le backlog — il livre la valeur directement.
**Itération continue.** La boucle feedback-itération est considérablement raccourcie. Le Product Builder peut ajuster un outil en temps réel en fonction des retours utilisateurs, sans passer par un cycle de développement classique.
### Product Builder vs Product Manager vs Développeur
Le Product Builder ne remplace ni le Product Manager ni le développeur. Il occupe un espace intermédiaire :
- Par rapport au **Product Manager** classique : le Product Builder a les mêmes compétences en discovery et stratégie produit, mais il peut aussi construire. Cela lui donne un avantage en vitesse d'itération et en autonomie, particulièrement dans les phases amont (exploration, validation d'hypothèses).
- Par rapport au développeur : le Product Builder ne maîtrise pas les fondamentaux de l'ingénierie logicielle (architecture, scalabilité, sécurité, maintenabilité). Ses prototypes sont fonctionnels mais rarement production-ready. Quand un prototype validé doit être industrialisé, les développeurs prennent le relais.
Cette complémentarité est fondamentale. Le Product Builder accélère la phase de discovery et de validation. L'équipe de développement industrialise ce qui a fait ses preuves. Le risque de construire le mauvais produit diminue parce que les hypothèses ont été testées en conditions réelles avant de mobiliser des ressources de développement coûteuses.
### Les compétences du Product Builder
Au-delà des compétences classiques de product management, le Product Builder développe :
- **Le prompt engineering** : savoir formuler des instructions précises pour les outils d'IA générative, itérer sur les résultats, combiner plusieurs outils dans un workflow.
- **La culture technique de base** : comprendre les concepts d'API, de base de données, de logique conditionnelle — sans nécessairement savoir coder from scratch.
- **La maîtrise d'outils no-code/low-code** : Bubble, Retool, Webflow, Airtable, n8n et leurs équivalents.
- **Le sens du "good enough"** : savoir quand un prototype est suffisant pour tester une hypothèse, et quand il faut passer le relais à une équipe de développement.
### Les limites et les risques
Le modèle du Product Builder n'est pas exempt de risques :
**La dette technique invisible.** Des prototypes déployés sans revue de code, sans tests automatisés, sans monitoring, peuvent devenir des systèmes critiques que personne ne sait maintenir. La frontière entre "prototype" et "production" se brouille dangereusement.
**La sécurité.** Un Product Builder sans formation en sécurité informatique peut involontairement exposer des données sensibles, créer des vulnérabilités ou contrevenir aux politiques de **Data Governance** de l'organisation.
**L'illusion de la facilité.** Le fait de pouvoir construire un prototype rapidement ne signifie pas que le produit est prêt. L'**AI Governance**, la gestion des edge cases, la scalabilité et la maintenabilité restent des sujets qui exigent une expertise d'ingénierie.
### L'avenir du rôle
Le Product Builder illustre une tendance de fond : l'IA redistribue les cartes entre les rôles. Les frontières entre "ceux qui pensent le produit" et "ceux qui le construisent" deviennent plus poreuses. Cette évolution ne rend pas les développeurs obsolètes — elle libère leur temps pour les problèmes techniques les plus complexes, tout en permettant aux profils produit de contribuer plus directement à la création de valeur.
---
### Qu'est-ce qu'un Product Manager ?
Source : https://www.hymaia.com/qu-est-ce-que/product-manager/
Le Product Manager definit la vision d'un produit, priorise les fonctionnalites et coordonne les equipes pour delivrer de la valeur aux utilisateurs. Avec l'essor de la data et de l'IA, ce role integre de nouvelles competences.
Le Product Manager (PM) est responsable du succes d'un produit. Il definit ce qu'il faut construire, pourquoi, et dans quel ordre. Son role est de comprendre les besoins des utilisateurs, de les traduire en decisions produit, et de s'assurer que l'equipe technique construit la bonne chose au bon moment.
### Les responsabilites fondamentales
Le quotidien d'un Product Manager s'articule autour de quatre axes :
- **Discovery** : comprendre les problemes des utilisateurs par la recherche (interviews, donnees d'usage, feedbacks). Le PM ne part pas de solutions mais de problemes a resoudre.
- **Priorisation** : face a des dizaines de demandes (utilisateurs, equipe commerciale, direction), le PM decide ce qui entre dans la roadmap et ce qui attend. Les frameworks comme RICE, ICE ou le Opportunity Solution Tree structurent ces arbitrages.
- **Specification** : ecrire les user stories, definir les criteres d'acceptation, clarifier les cas limites. Le PM ne dicte pas le "comment" (c'est le role de l'equipe technique) mais il clarifie le "quoi" et le "pourquoi".
- **Delivery et iteration** : suivre le developpement, valider les livrables, mesurer l'impact apres le lancement. Un bon PM boucle la boucle en verifiant que la fonctionnalite livree resout effectivement le probleme identifie.
### Competences cles
Le PM est un generaliste qui combine plusieurs domaines de competence :
- **Sens metier** : comprendre le marche, les concurrents, le modele economique. Le PM doit pouvoir expliquer pourquoi une fonctionnalite genere de la valeur business, pas seulement de la satisfaction utilisateur.
- **Empathie utilisateur** : capacite a se mettre a la place de l'utilisateur final, a identifier des frictions que les donnees seules ne revelent pas.
- **Culture technique** : pas besoin de coder, mais comprendre les contraintes techniques, les trade-offs d'architecture, et parler le meme langage que les developpeurs. La Data Literacy est indispensable pour exploiter les donnees d'usage.
- **Communication** : le PM est le point de contact entre les equipes (tech, design, business, direction). Il doit synthetiser des informations complexes et aligner des parties prenantes aux interets parfois divergents.
### Le Product Manager face a la data
Les donnees transforment la maniere de faire du produit. Un PM moderne s'appuie sur les metriques d'usage pour prioriser (quelles fonctionnalites sont utilisees, ou les utilisateurs abandonnent), pour evaluer l'impact (A/B testing, cohortes) et pour alimenter sa roadmap.
Cette evolution a donne naissance au role de Data Product Manager, specialise dans la construction de produits centres sur la donnee : Data Platforms, pipelines analytiques, produits data-as-a-service. Le Data Product Manager combine les competences classiques du PM avec une comprehension approfondie des architectures data, du concept de Data As A Product, et des contraintes specifiques a la qualite des donnees.
### L'impact de l'IA sur le role
L'IA generative et les systemes agentiques changent profondement le metier. Le PM doit maintenant :
- **Evaluer la pertinence de l'IA** : tous les problemes ne necessitent pas du machine learning. Le PM doit identifier les cas ou l'IA apporte une valeur reelle versus ceux ou une regle metier suffit.
- **Gerer l'incertitude du ML** : contrairement au code deterministe, un modele de ML a un taux d'erreur. Le PM doit definir les seuils acceptables et concevoir des fallbacks pour les cas ou le modele se trompe.
- **Integrer l'ethique** : biais algorithmiques, transparence des decisions automatisees, conformite avec l'AI Act. Le PM a la responsabilite de s'assurer que le produit est fiable et equitable.
Le role d'AI Product Manager emerge pour repondre a ces specificites, avec une expertise renforcee sur les cycles de vie des modeles, l'evaluation des systemes d'IA, et la collaboration avec les equipes de Data Scientists et ML Engineers.
### Product Builder : l'evolution du role
Avec la democratisation des outils no-code/low-code et de l'IA generative, une nouvelle figure emerge : le Product Builder. Ce profil combine la vision produit du PM avec la capacite de prototyper rapidement, voire de construire des produits complets sans equipe de developpement dediee. Le vibe coding et les outils d'IA accelerent cette tendance.
### Comment devenir Product Manager
Il n'existe pas de parcours unique. Les PM viennent de l'ingenierie, du design, du marketing, du conseil ou du metier. Ce qui les rassemble : une curiosite pour les problemes utilisateurs et une capacite a naviguer entre les disciplines. Les formations en AI Product Management permettent aux PM en poste d'integrer les competences data et IA necessaires a l'evolution du role.
---
### Qu'est-ce que le prompt engineering ?
Source : https://www.hymaia.com/qu-est-ce-que/prompt-engineering/
Le prompt engineering est la discipline qui consiste à formuler des instructions précises et structurées pour obtenir les meilleurs résultats d'un LLM. Il regroupe un ensemble de techniques — few-shot, chain-of-thought, system prompts — pour guider le comportement du modèle.
Le **prompt engineering** désigne l'ensemble des techniques utilisées pour formuler des instructions (prompts) destinées à un modèle de langage (LLM), afin d'obtenir des réponses pertinentes, précises et exploitables. Loin d'être un simple exercice de rédaction, le prompt engineering est devenu une compétence technique à part entière, qui combine compréhension du fonctionnement des LLM, structuration de l'information et itération méthodique.
### Pourquoi le prompt compte autant
Un LLM ne "comprend" pas une question comme un humain. Il produit une séquence de tokens statistiquement probable étant donné le contexte qu'on lui fournit. La formulation du prompt influence directement la distribution de probabilités des réponses. Un prompt vague ou ambigu produit des réponses génériques. Un prompt précis, contextualisé et structuré oriente le modèle vers une réponse ciblée.
C'est ce qui fait du prompt engineering un levier de performance souvent sous-estimé : avant d'investir dans du fine-tuning ou une architecture RAG, optimiser ses prompts peut apporter des gains significatifs à coût quasi nul.
### Les techniques fondamentales
**Zero-shot prompting.** On donne une instruction directe au modèle sans exemple. C'est la forme la plus simple : "Résume ce texte en 3 bullet points." Les LLM récents sont suffisamment performants pour traiter de nombreuses tâches en zero-shot, mais la qualité dépend fortement de la clarté de l'instruction.
**Few-shot prompting.** On fournit quelques exemples d'entrée-sortie avant de poser la question réelle. Cette technique permet au modèle de comprendre le format attendu, le niveau de détail et le ton. Trois à cinq exemples bien choisis suffisent généralement. Le few-shot est particulièrement utile pour les tâches de classification, d'extraction d'entités ou de reformulation selon un format spécifique.
**Chain-of-thought (CoT).** On demande au modèle de décomposer son raisonnement étape par étape avant de donner sa réponse finale. Introduite par des chercheurs de Google en 2022, cette technique améliore significativement les performances sur les tâches de raisonnement logique et mathématique. Une simple phrase comme "Raisonne étape par étape" peut transformer la qualité d'une réponse.
**System prompts.** La plupart des API de LLM permettent de définir un "system prompt" — une instruction de cadrage qui définit le rôle, le ton et les contraintes du modèle pour toute la conversation. Par exemple : "Tu es un expert juridique français. Tu réponds de manière concise et tu cites les articles de loi pertinents." Le system prompt est le levier le plus puissant pour cadrer le comportement global du modèle.
### Techniques avancées
**Le prompting structuré.** Utiliser des balises XML, du JSON ou du Markdown dans les prompts permet de séparer clairement les instructions, le contexte et les données. Les LLM sont entraînés sur du texte structuré et répondent mieux quand le prompt est lui-même bien organisé.
**Les contraintes explicites.** Préciser ce que le modèle ne doit pas faire est souvent aussi important que ce qu'il doit faire. "Ne fais pas d'hypothèses sur les données manquantes", "Réponds uniquement à partir du contexte fourni", "Si tu ne sais pas, dis-le" — ces gardes-fous réduisent les hallucinations et les réponses hors sujet.
**Le prompt chaining.** Plutôt qu'un seul prompt complexe, on décompose la tâche en plusieurs étapes, chaque prompt utilisant la sortie du précédent. Cette approche est au coeur des systèmes d'IA agentique, où un orchestrateur enchaîne des appels au LLM avec des appels à des outils externes.
### Prompt engineering en entreprise
Dans un contexte professionnel, le prompt engineering ne se limite pas à des interactions ponctuelles avec ChatGPT. Il s'agit de concevoir des templates de prompts réutilisables, versionnés et testés, intégrés dans des pipelines applicatifs. Les équipes produit qui développent des fonctionnalités basées sur des LLM passent une part significative de leur temps à itérer sur les prompts.
Les bonnes pratiques incluent :
- **Versionner les prompts** comme du code, avec un historique des modifications et des tests de régression.
- **Évaluer systématiquement** les résultats sur un jeu de test représentatif, plutôt que de se fier à des impressions qualitatives.
- **Documenter les choix** de formulation et les raisons des itérations, pour capitaliser les apprentissages de l'équipe.
Le rôle de "prompt engineer" tel qu'il a été médiatisé en 2023 évolue : les compétences de prompt engineering s'intègrent dans les métiers existants (AI Product Manager, ML Engineer, développeur) plutôt que de constituer un poste isolé.
### Limites du prompt engineering
Le prompt engineering a ses limites. Il ne peut pas compenser un modèle inadapté à la tâche, des données manquantes ou une architecture mal conçue. Pour les cas d'usage nécessitant des connaissances spécifiques non présentes dans le modèle, le RAG reste indispensable. Pour modifier en profondeur le comportement ou le style d'un modèle, le fine-tuning sera plus efficace qu'un prompt toujours plus long et complexe.
---
### Qu'est-ce que le RAG (Retrieval-Augmented Generation) ?
Source : https://www.hymaia.com/qu-est-ce-que/rag/
Le RAG (Retrieval-Augmented Generation) est une architecture qui enrichit les réponses d'un LLM en lui fournissant des documents pertinents extraits d'une base de connaissances. Cette approche réduit les hallucinations et permet d'exploiter des données internes sans réentraîner le modèle.
Le **RAG (Retrieval-Augmented Generation)** est une architecture technique qui combine deux mécanismes distincts : la recherche d'information dans une base documentaire et la génération de texte par un modèle de langage (LLM). Le principe est simple : avant de répondre à une question, le système va d'abord chercher les documents les plus pertinents, puis les transmet au LLM comme contexte pour formuler sa réponse.
### Comment fonctionne un pipeline RAG
Un système RAG s'organise en trois étapes principales :
**1\. L'indexation des documents.** Les documents sources (pages web, PDF, bases de données, wikis internes) sont découpés en fragments (chunks), puis transformés en vecteurs numériques via un modèle d'embeddings. Ces vecteurs sont stockés dans une base de données vectorielle (Pinecone, Weaviate, Qdrant, pgvector, etc.) qui permet des recherches par similarité sémantique.
**2\. La recherche (retrieval).** Quand un utilisateur pose une question, celle-ci est également transformée en vecteur. Le système compare ce vecteur avec ceux de la base pour identifier les fragments de documents les plus proches sémantiquement. Des approches hybrides combinent souvent recherche vectorielle et recherche par mots-clés (BM25) pour améliorer la pertinence.
**3\. La génération augmentée.** Les fragments récupérés sont injectés dans le prompt envoyé au LLM, accompagnés de la question initiale. Le modèle peut alors formuler une réponse fondée sur des informations factuelles et spécifiques, plutôt que de s'appuyer uniquement sur ses connaissances acquises lors de l'entraînement.
### Pourquoi le RAG est devenu incontournable en entreprise
Le RAG répond à un problème fondamental des LLM : leurs connaissances sont figées à la date de leur entraînement, et ils n'ont pas accès aux données propriétaires d'une organisation. Sans RAG, un LLM qui doit répondre à une question sur un sujet qu'il ne maîtrise pas va produire une hallucination — une réponse formulée avec aplomb mais factuellement fausse.
Le RAG offre plusieurs avantages par rapport au fine-tuning :
- **Pas de réentraînement nécessaire.** Mettre à jour les connaissances revient à mettre à jour la base documentaire, une opération qui prend quelques minutes contre des heures ou des jours pour un fine-tuning.
- **Traçabilité des sources.** Chaque réponse peut citer les documents utilisés, ce qui permet aux utilisateurs de vérifier l'information. Cette transparence est déterminante pour l'adoption en entreprise.
- **Contrôle des accès.** On peut filtrer les documents accessibles selon les droits de l'utilisateur, un point essentiel pour les données sensibles.
- **Coût maîtrisé.** Pas besoin de GPU ni de compétences en entraînement de modèles.
### Les défis d'un RAG performant
Mettre en place un prototype RAG est rapide. Obtenir un système fiable en production est nettement plus exigeant.
La **qualité du découpage** (chunking) est souvent le premier levier d'amélioration. Des chunks trop courts perdent le contexte, trop longs diluent l'information pertinente. Les stratégies avancées utilisent un découpage sémantique qui respecte la structure logique des documents.
Le **ranking et le reranking** des résultats influencent directement la qualité des réponses. Un document mal classé dans le top-K des résultats peut entraîner une réponse hors sujet. Des modèles de reranking (comme Cohere Rerank ou des cross-encoders) permettent de réordonner les résultats après la recherche vectorielle initiale.
L'**évaluation** d'un pipeline RAG est un sujet à part entière. Des frameworks comme RAGAS proposent des métriques spécifiques : fidélité de la réponse aux documents sources, pertinence des documents récupérés, couverture de la question. Sans évaluation systématique, il est difficile d'identifier les régressions au fil des itérations.
### RAG vs fine-tuning : des approches complémentaires
Le RAG et le fine-tuning ne s'opposent pas — ils répondent à des besoins différents. Le RAG excelle pour intégrer des connaissances factuelles et évolutives (documentation, procédures, données métier). Le fine-tuning est plus adapté pour modifier le comportement du modèle : ton, format de réponse, terminologie spécialisée. En pratique, les architectures les plus robustes combinent les deux.
### Applications concrètes
Le RAG s'est imposé dans de nombreux cas d'usage en entreprise : assistants internes sur la documentation technique, chatbots de support client alimentés par la base de connaissances, outils d'aide à la décision pour les équipes juridiques ou réglementaires, et moteurs de recherche sémantique sur des corpus spécialisés.
Les systèmes d'IA agentique s'appuient aussi largement sur le RAG : un agent qui doit répondre à une question ou prendre une décision va chercher les informations nécessaires dans ses sources avant d'agir, plutôt que de se fier uniquement aux connaissances embarquées dans le LLM.
---
### Qu'est-ce que la recherche sémantique ?
Source : https://www.hymaia.com/qu-est-ce-que/recherche-semantique/
La recherche sémantique est une méthode de recherche d'information basée sur le sens des mots plutôt que sur leur correspondance exacte. En utilisant des embeddings pour représenter textes et requêtes sous forme de vecteurs, elle retrouve des documents pertinents même quand les mots diffèrent. C'est l'infrastructure clé du RAG.
La **recherche sémantique** (semantic search) est une approche de recherche d'information qui compare le **sens** d'une requête avec le sens des documents indexés, plutôt que de chercher une correspondance exacte de mots-clés. Elle repose sur les embeddings — des représentations vectorielles denses du texte — pour calculer une similarité sémantique entre la question posée et les contenus disponibles.
### Le problème de la recherche par mots-clés
La recherche traditionnelle (type BM25, TF-IDF) fonctionne par correspondance lexicale : elle cherche les documents qui contiennent les mêmes mots que la requête. Cette approche a deux faiblesses structurelles :
- **La synonymie** : un document parlant de "réduction des effectifs" ne sera pas retrouvé par la requête "licenciements", bien que les deux parlent du même sujet.
- **La polysémie** : le mot "python" peut désigner un serpent, un langage de programmation ou un membre des Monty Python. La recherche par mots-clés ne distingue pas ces sens.
La recherche sémantique résout ces deux problèmes en travaillant au niveau du sens, pas des mots.
### Comment ça fonctionne
**1\. Création des embeddings.** Un modèle d'embedding (comme text-embedding-3 d'OpenAI, Cohere Embed, ou un modèle open source comme BGE ou E5) transforme chaque document en un vecteur numérique dense, typiquement de 768 à 3072 dimensions. Ce vecteur capture le sens du texte : des textes sémantiquement proches produisent des vecteurs proches dans l'espace vectoriel.
**2\. Indexation dans une base vectorielle.** Les vecteurs sont stockés dans une base de données vectorielle (Pinecone, Weaviate, Qdrant, Milvus, pgvector) qui optimise la recherche de voisins les plus proches (ANN — Approximate Nearest Neighbors). Ces bases utilisent des algorithmes comme HNSW (Hierarchical Navigable Small World) pour retrouver rapidement les vecteurs les plus similaires parmi des millions.
**3\. Recherche.** Quand un utilisateur pose une question, celle-ci est transformée en vecteur par le même modèle d'embedding. La base vectorielle retourne les documents dont les vecteurs sont les plus proches (selon une mesure de distance : cosinus, produit scalaire ou distance euclidienne).
**4\. Reranking (optionnel).** Un modèle de reranking (comme Cohere Rerank ou un cross-encoder) reclasse les résultats pour affiner la pertinence. Contrairement aux bi-encoders utilisés pour l'indexation (qui encodent requête et document séparément), les cross-encoders analysent la paire requête-document ensemble, ce qui donne des scores de pertinence plus précis mais au prix d'une latence plus élevée.
### Recherche sémantique et RAG
La recherche sémantique est le mécanisme de récupération au coeur du RAG (Retrieval-Augmented Generation). Dans un pipeline RAG :
1\. Les documents de la base de connaissances sont découpés en chunks et indexés sous forme d'embeddings.
2\. Quand une question arrive, la recherche sémantique retrouve les chunks les plus pertinents.
3\. Ces chunks sont injectés dans le contexte du LLM, qui génère une réponse ancrée dans les données (grounding).
La qualité de la recherche sémantique conditionne directement la qualité du RAG : si les mauvais documents sont récupérés, le LLM produira des réponses hors sujet ou incorrectes.
### Recherche hybride
En pratique, les meilleurs systèmes combinent recherche sémantique et recherche par mots-clés dans une approche dite **hybride**. La recherche par mots-clés excelle pour les termes techniques précis, les noms propres ou les identifiants. La recherche sémantique excelle pour les questions formulées différemment du contenu. La combinaison des deux (via un mécanisme de fusion comme Reciprocal Rank Fusion) donne de meilleurs résultats que chaque approche isolée.
### Chunking : le découpage qui fait la différence
La façon dont les documents sont découpés en morceaux (chunks) avant l'indexation influence fortement la qualité de la recherche. Les stratégies courantes incluent :
- **Chunking par taille fixe** : découper toutes les N tokens, simple mais pouvant couper des phrases en deux.
- **Chunking par structure** : respecter les paragraphes, les sections ou les titres du document.
- **Chunking récursif** : découper d'abord par sections, puis par paragraphes si les sections sont trop longues.
- **Chunking sémantique** : utiliser un modèle pour identifier les ruptures thématiques dans le texte.
Le choix de la taille de chunk est un arbitrage : des chunks trop petits perdent le contexte, des chunks trop grands diluent le signal pertinent dans du bruit.
### Applications au-delà du texte
La recherche sémantique s'étend aux images (CLIP de OpenAI permet de chercher des images par description textuelle), à l'audio et au code source. Le principe reste le même : transformer le contenu en vecteur et comparer les vecteurs.
---
### Qu'est-ce que RTK (Raw Token Killer) en Agentic Coding ?
Source : https://www.hymaia.com/qu-est-ce-que/rtk-raw-token-killer/
RTK (Raw Token Killer) est un utilitaire qui réduit la quantité de tokens envoyée dans le contexte d'un agent IA, en filtrant la sortie brute d'une centaine de commandes courantes comme read, ls, cat, npm test ou go test. Il peut réduire jusqu'à 90 % des tokens sur ces commandes, sans garantir pour autant une baisse équivalente de la facture.
**RTK** (Raw Token Killer) est un utilitaire d'Agentic Coding conçu pour réduire la quantité de tokens qui entrent dans le contexte d'un agent IA. Il s'intercale sur les commandes exécutées par l'agent et filtre leur sortie brute avant qu'elle n'atteigne le modèle.
### Ce que RTK filtre
RTK couvre une centaine de commandes courantes, parmi lesquelles `read`, `ls`, `cat`, `npm test` ou `go test`. Sur ces commandes, il retire des sorties tout ce qui n'apporte pas d'information utile à l'agent — répétitions, formatage superflu, détails verbeux — pour ne conserver que le signal pertinent.
### Un gain réel, mais à relativiser
Sur les commandes qu'il couvre, RTK peut réduire la consommation de tokens jusqu'à 90 %. Ce chiffre ne se traduit pas mécaniquement en une baisse équivalente de la facture, pour deux raisons :
**RTK ne couvre qu'une centaine de commandes.** Tout ce qui sort de ce périmètre — le reste des appels d'outils, les réponses du modèle lui-même — n'est pas concerné par cette réduction.
**Le coût en GenAI vient surtout des tokens en sortie, pas en entrée.** RTK agit sur les tokens qui entrent dans le contexte (input), alors que les tokens générés par le modèle (output) sont généralement les plus coûteux. Réduire l'input améliore la taille du contexte et la latence, mais ne réduit pas nécessairement la ligne la plus chère de la facture.
### Les alternatives complémentaires
Pour aller plus loin sur la réduction de coûts, d'autres utilitaires comme Headroom ou Caveman abordent le problème sous un angle différent. Leur fonctionnement dépasse le cadre de cette définition.
---
### Qu'est-ce qu'un Semantic Layer ?
Source : https://www.hymaia.com/qu-est-ce-que/semantic-layer/
Le Semantic Layer (ou couche sémantique) est une couche logique qui traduit les données brutes en concepts métier partagés, pour que chaque outil qui consomme la donnée (BI, application, agent IA) retourne exactement le même résultat.
Le **Semantic Layer** (ou couche sémantique) est une couche logique qui traduit vos données brutes en concepts métier partagés, comme le chiffre d'affaires, le client actif ou le taux de churn, pour que chaque outil qui consomme la donnée renvoie exactement le même résultat. Il ne remplace pas votre data warehouse : il s'installe au-dessus, une seule fois, pour que tout le monde (BI, application, agent IA) parle enfin le même langage.
Concrètement, il répond à trois questions que toute organisation data finit par se poser : comment définit-on précisément ce KPI ? Qui a raison quand deux dashboards affichent deux chiffres différents pour la même métrique ? Et comment garantir que cette définition reste valable demain, dans un nouvel outil ou pour un nouvel agent IA ?
### Pourquoi le Semantic Layer est indispensable
Sans Semantic Layer, une organisation fait face à plusieurs problèmes concrets :
- **Deux dashboards, deux vérités** : le Comex demande le "chiffre d'affaires" en réunion. La Finance sort un chiffre, la Data un autre, le Sales Ops un troisième. Chacun a raison selon sa propre définition, écrite dans son propre outil et jamais partagée.
- **La logique métier dupliquée à l'infini** : la règle "client actif = au moins une commande dans les 90 derniers jours" est réécrite en SQL dans Looker, copiée dans Power BI, adaptée dans un notebook Python. Le jour où la règle change, il faut la corriger partout, et on en oublie toujours un.
- **Une confiance qui s'érode** : quand les chiffres se contredisent d'un outil à l'autre, les dirigeants finissent par ne plus faire confiance à la donnée du tout.
- **Le nouveau risque des agents IA** : un agent IA branché directement sur l'entrepôt, sans couche sémantique, génère sa propre requête SQL à chaque question, et donc sa propre définition du "churn". Sans gouvernance, l'IA démultiplie l'incohérence au lieu de la résoudre.
### Les différentes approches
On distingue généralement trois façons d'implémenter un Semantic Layer :
- **Embarqué dans l'outil BI** : LookML dans **Looker**, le modèle tabulaire de Power BI, les extraits Tableau. C'est l'approche la plus répandue historiquement, simple à démarrer, mais la définition reste prisonnière de l'outil : elle ne sert à rien pour les autres usages (notebooks, applications, agents IA).
- **Virtuel / headless (ou "universel")** : le Semantic Layer devient indépendant de tout outil de présentation. Défini une fois, il est exposé via des API (SQL, REST, GraphQL) à n'importe quel client : BI, Excel, Python, chatbot. C'est l'approche portée par **dbt** Semantic Layer, Cube ou AtScale.
- **Héritage OLAP** : les cubes multidimensionnels du monde BI traditionnel (SSAS, et une partie de l'héritage AtScale) répondaient déjà à ce besoin il y a vingt ans, avec une promesse de performance plutôt que de portabilité.
La tendance de fond va clairement vers l'approche headless : un Semantic Layer pensé comme une brique d'infrastructure, pas comme une fonctionnalité d'un outil de reporting.
### Comment construire un Semantic Layer
- **dbt Semantic Layer (MetricFlow)** : les entités, dimensions et mesures sont définies en YAML, à côté des modèles **dbt** qui construisent déjà les tables. MetricFlow génère ensuite le SQL à la demande, quel que soit l'outil qui interroge la métrique.
- **Cube** : les modèles de données sont écrits en YAML ou JavaScript, puis exposés en API REST, GraphQL et SQL, avec un moteur de cache et de pré-agrégation pensé pour la performance à grande échelle.
- **AtScale** : héritage OLAP fort, connexion native à Excel et Power BI via MDX/DAX, gestion automatique des agrégats, et des investissements récents pour exposer le modèle sémantique aux agents IA.
- **LookML (Looker)** : natif à l'outil, très mature, mais non portable : la définition reste propriétaire de Looker.
Le choix dépend surtout d'un arbitrage : jusqu'où voulez-vous découpler vos définitions métier de vos outils de restitution ?
### Outils et écosystème
- **Semantic layers headless** : **dbt** (MetricFlow), Cube, AtScale.
- **BI avec semantic layer intégré** : Looker (LookML), Power BI (modèle tabulaire), Tableau.
- **Standards émergents** : le protocole MCP (Model Context Protocol), qui commence à être utilisé pour exposer un Semantic Layer directement aux agents IA de façon standardisée.
### Semantic Layer et Data Governance
Le Semantic Layer est un pilier de la **Data Governance** : c'est l'endroit où la définition métier d'une métrique devient un contrat, pas une opinion. Dans une architecture **Data Mesh**, il joue un rôle clé de médiation : chaque domaine reste propriétaire de ses données, mais s'engage sur des définitions partagées au niveau des métriques transverses (revenu, client, churn).
C'est en général l'**Analytics Engineer** qui porte la construction et la maintenance de cette couche, à la frontière entre l'ingénierie des données et les besoins métier.
### Semantic Layer et agents IA autonomes
Le sujet a pris une nouvelle dimension avec la montée des agents IA capables de mener des investigations data en autonomie. Juliette Duizabo, Head of Data chez Photoroom, en a fait la démonstration lors du Hymaday Agentic Analytics (voir le replay) : chez Photoroom (3 personnes pour 140 collaborateurs), le Semantic Layer vit directement dans la codebase : versionné, testé en pre-push, en CI et en production, avec des alertes en cas d'anomalie. Ce n'est pas un détail technique : c'est ce qui permet à un agent IA de savoir exactement dans quelle table aller chercher avant de lancer, seul, une centaine de requêtes SQL pour répondre à une question complexe ("pourquoi l'ARR dérive-t-il ?").
Sans cette fondation, l'automatisation agentique ne réduit pas les erreurs : elle les multiplie, à la vitesse d'un LLM. Chez Photoroom, un simple fichier `glossary.md` centralise les définitions et sert de référence à tous les agents et rapports générés. C'est la version la plus légère et la plus "code-native" du Semantic Layer, aux antipodes des plateformes dédiées, mais elle remplit exactement la même fonction : garantir que l'agent, comme l'humain, ne réinvente jamais la définition d'un "client actif" ou d'un "churn".
Sur chaque dimension, les deux visions du Semantic Layer divergent nettement :
- **Implémentation.** L'approche traditionnelle s'appuie sur une plateforme dédiée (Cube, AtScale, dbt Semantic Layer) qui expose une API. Chez Photoroom, c'est un simple fichier dans la codebase (`glossary.md`), traité comme du code.
- **Objectif principal.** L'approche traditionnelle vise la cohérence entre outils BI pour des utilisateurs humains. Chez Photoroom, l'objectif devient une fondation de confiance pour des agents IA autonomes.
- **Gouvernance.** L'approche traditionnelle s'appuie sur un comité, un Data Steward, un catalogue de données. Chez Photoroom, la gouvernance passe par des tests automatisés : pre-push, CI, production, alertes.
- **Bénéfice recherché.** L'approche traditionnelle vise un seul chiffre partagé entre Tableau, Power BI et les notebooks. Chez Photoroom, il s'agit de sécuriser l'automatisation : sans cette fondation, les agents multiplient les erreurs au lieu de les réduire.
Créer des agents IA est devenu simple ; ce qui fait la différence, c'est que la donnée sous-jacente soit propre, testée et documentée. Le Semantic Layer n'est plus seulement un outil de cohérence BI : c'est la condition de sécurité de toute automatisation IA sur la donnée.
### Cas d'usage concrets
- **Cohérence multi-outils** : la même définition de "revenu net" alimente un dashboard Tableau, un rapport Power BI et un notebook Python, sans un seul copier-coller de SQL.
- **Self-service sans risque** : les équipes métier interrogent la donnée en langage business ("montre-moi le churn par région") sans écrire de requête, et sans pouvoir se tromper de définition.
- **Agents IA fiables** : un assistant IA interrogé sur "notre churn ce mois-ci" passe par le Semantic Layer plutôt que par une requête SQL générée à la volée : la réponse est gouvernée, pas hallucinée.
- **Migration d'outil BI sans perte de mémoire** : changer de Tableau à Power BI, ou l'inverse, sans redéfinir des dizaines de métriques métier au passage.
---
### Qu'est-ce que le Shadow AI ?
Source : https://www.hymaia.com/qu-est-ce-que/shadow-ai/
Le Shadow AI désigne l'utilisation non autorisée ou non encadrée d'outils d'IA par les collaborateurs d'une organisation, en dehors des systèmes approuvés. Analogue du Shadow IT, il expose l'entreprise à des risques de fuite de données, de non-conformité réglementaire et de décisions fondées sur des résultats non fiables.
Le **Shadow AI** désigne l'ensemble des usages d'intelligence artificielle qui se développent dans une organisation en dehors du cadre officiel : sans validation de la DSI, sans politique de sécurité appliquée, et souvent sans que le management en ait connaissance. Le terme est construit par analogie avec le **Shadow IT** — l'utilisation d'outils informatiques non approuvés — mais avec des risques spécifiques liés à la nature des outils d'IA générative.
### Un phénomène massif
Depuis la mise à disposition publique de ChatGPT fin 2022, puis de ses concurrents (Claude, Gemini, Mistral, Copilot), des millions de collaborateurs utilisent quotidiennement des LLMs pour rédiger des emails, synthétiser des documents, analyser des données ou générer du code. Dans beaucoup d'organisations, ces usages se sont développés spontanément, avant que des politiques d'encadrement ne soient mises en place.
Plusieurs enquêtes menées en 2024 convergent sur un constat : entre 50 et 70 % des collaborateurs en entreprise utilisent des outils d'IA générative au travail, et une part significative le fait via des comptes personnels, sur des versions gratuites, sans passer par les outils mis à disposition par l'entreprise.
### Les risques concrets
**Fuite de données confidentielles.** Quand un collaborateur colle un document confidentiel dans ChatGPT (version gratuite ou API sans accord d'entreprise), ces données transitent par les serveurs du fournisseur. Selon les conditions d'utilisation, elles peuvent être utilisées pour entraîner les modèles suivants. Des cas documentés incluent des employés de Samsung ayant soumis du code source propriétaire à ChatGPT en 2023, ce qui a conduit l'entreprise à interdire l'outil.
**Non-conformité réglementaire.** Le RGPD impose que le traitement de données personnelles soit encadré (base légale, registre des traitements, information des personnes). Un collaborateur qui soumet des données clients à un LLM via un compte personnel enfreint potentiellement ces obligations. L'AI Act ajoute des exigences supplémentaires pour les systèmes d'IA à haut risque, notamment en matière de traçabilité et de gestion des risques.
**Résultats non fiables.** Les LLMs produisent des hallucinations. Un collaborateur qui utilise ChatGPT pour rédiger une analyse financière, un avis juridique ou un rapport technique sans vérification risque de propager des erreurs dans les processus de l'entreprise. Sans guardrails ni grounding, les réponses générées ne sont pas ancrées dans des données vérifiées.
**Absence de traçabilité.** Quand les usages d'IA ne sont pas centralisés, l'organisation perd la visibilité sur qui utilise quoi, avec quelles données, et pour quels résultats. En cas d'incident (décision erronée fondée sur une sortie d'IA, fuite de données), il est difficile de remonter à la source.
### Pourquoi le Shadow AI se développe
Le Shadow AI n'est pas un acte de malveillance — c'est une réponse pragmatique à un besoin non satisfait. Les collaborateurs utilisent ces outils parce qu'ils les trouvent utiles et que l'entreprise ne propose pas d'alternative. Les facteurs contributifs :
- **Lenteur de mise à disposition.** Les processus d'achat et de validation sécurité prennent des mois, pendant que les outils gratuits sont accessibles en 30 secondes.
- **Offre interne inadaptée.** L'outil validé par l'entreprise est parfois limité (modèle ancien, pas de possibilité d'upload de fichiers, quota restreint) comparé aux versions publiques.
- **Absence de politique claire.** Sans directive explicite, les collaborateurs considèrent que ce qui n'est pas interdit est autorisé.
- **Pression de productivité.** Les gains de productivité offerts par les LLMs sont tangibles et immédiats, créant une incitation forte à les utiliser.
### Comment traiter le Shadow AI
**Reconnaître le besoin.** La première étape est d'admettre que les collaborateurs utilisent l'IA parce qu'elle leur est utile. Interdire purement et simplement ne fonctionne pas — l'usage se poursuit de manière encore plus clandestine.
**Fournir une alternative officielle.** Mettre à disposition des outils d'IA validés (avec accords de traitement de données, hébergement conforme, guardrails configurés) qui répondent aux besoins réels des équipes.
**Établir une politique d'usage claire.** Définir ce qui est autorisé et ce qui ne l'est pas, avec des exemples concrets : quelles données peuvent être soumises, quels outils sont approuvés, quelles vérifications sont requises sur les résultats.
**Former les équipes.** La data literacy étendue à l'IA : former les collaborateurs aux bonnes pratiques (ne pas soumettre de données personnelles, vérifier les résultats, comprendre les limites des LLMs) transforme le Shadow AI en usage responsable. Les programmes d'AI Champions permettent de diffuser ces pratiques au sein de chaque équipe.
**Monitorer et itérer.** Suivre les usages, collecter les retours, et améliorer continuellement l'offre interne pour rester au niveau des outils publics.
### Shadow AI et data governance
Le Shadow AI met en lumière un enjeu plus large de data governance à l'ère de l'IA générative. Les politiques de gouvernance des données doivent intégrer les flux de données vers les LLMs : classification des données (quelles données sont autorisées en entrée des modèles), choix des fournisseurs (accords de traitement, localisation des données), et traçabilité des usages.
---
### Qu'est-ce qu'Apache Spark ?
Source : https://www.hymaia.com/qu-est-ce-que/spark/
Apache Spark est un framework open source de calcul distribue concu pour le traitement de donnees a grande echelle. Il se distingue par son execution en memoire, qui le rend bien plus rapide que Hadoop MapReduce.
Apache Spark est un moteur de traitement de donnees distribue, open source, capable de gerer des volumes allant du gigaoctet au petaoctet. Developpe a l'origine au laboratoire AMPLab de l'Universite de Berkeley en 2009, puis confie a la fondation Apache en 2013, Spark est devenu la reference pour le traitement de donnees massives. Son atout principal : le traitement en memoire (in-memory computing), qui evite les ecritures disque intermediaires et accelere les calculs d'un ordre de grandeur par rapport a Hadoop MapReduce.
### Architecture et fonctionnement
Spark repose sur une architecture maitre-worker :
- Le **Driver** (maitre) orchestre l'execution : il recoit le programme utilisateur, le decompose en taches (tasks), et les distribue aux workers.
- Les **Executors** (workers) executent les taches en parallele sur les noeud du cluster et stockent les donnees intermediaires en memoire.
L'abstraction centrale est le **DataFrame** (anciennement RDD — Resilient Distributed Dataset). Un DataFrame est une collection de donnees distribuee sur le cluster, sur laquelle on applique des transformations (filter, map, join) et des actions (count, collect, write). Les transformations sont "lazy" : elles ne s'executent que quand une action est declenchee, ce qui permet a Spark d'optimiser le plan d'execution global.
### Les modules de Spark
Spark n'est pas un outil unique mais une plateforme composee de plusieurs modules :
- **Spark SQL** : permet de requeter des donnees structurees avec du SQL standard. C'est le module le plus utilise. Il s'integre avec les formats Parquet, Delta Lake, ORC et peut se connecter aux entrepots de donnees comme Snowflake ou BigQuery.
- **Spark Structured Streaming** : traitement de flux de donnees en temps reel (ou plutot en micro-batch). Il utilise le meme modele de programmation que Spark SQL, ce qui simplifie le passage du batch au streaming.
- **MLlib** : bibliotheque de machine learning distribuee. Elle fournit des algorithmes classiques (regression, classification, clustering, recommandation) scalables sur de gros volumes. Pour les modeles de deep learning, on utilise plutot des frameworks dedies (PyTorch, TensorFlow) combines avec Spark pour le preprocessing.
- **GraphX** : module de traitement de graphes. Moins utilise que les autres, il permet des calculs sur des structures de graphes (PageRank, composantes connexes).
### Performance et optimisation
La vitesse de Spark repose sur plusieurs mecanismes :
- **Catalyst Optimizer** : l'optimiseur de requetes SQL de Spark analyse et reorganise le plan d'execution pour minimiser les shuffles (echanges de donnees entre noeud) et maximiser le parallelisme.
- **Tungsten** : moteur d'execution bas niveau qui gere la memoire manuellement (hors garbage collector Java) pour des performances proches du code compile.
- **Partitionnement** : les donnees sont decoupees en partitions distribuees sur le cluster. Un bon partitionnement est la cle de la performance : trop de partitions genere de l'overhead, trop peu cree des goulots d'etranglement.
Le Data Engineer qui travaille avec Spark passe une part significative de son temps a optimiser les jobs : ajuster le nombre de partitions, eviter les shuffles inutiles, choisir les bons formats de stockage, dimensionner le cluster.
### Ecosysteme et deploiement
Spark s'execute sur plusieurs gestionnaires de ressources :
- **YARN** (Hadoop) : le mode historique, encore tres utilise dans les entreprises qui ont un cluster Hadoop existant.
- **Kubernetes** : de plus en plus adopte, il permet de faire tourner Spark dans des conteneurs avec une gestion elastique des ressources.
- **Standalone** : le mode integre de Spark, adapte aux petits clusters ou au developpement.
Les services Cloud manages simplifient l'utilisation : **AWS EMR**, **Google Dataproc**, **Azure HDInsight** et **Databricks** (fonde par les createurs de Spark) gerent le provisionnement et le scaling du cluster. Databricks a ajoute des couches proprietaires (Delta Lake, Unity Catalog, Photon) qui etendent les capacites de Spark, en particulier pour les architectures lakehouse.
### Cas d'usage
Spark est utilise a travers toute la Modern Data Stack :
- **Ingestion Batch et ETL** : transformation de donnees brutes en donnees exploitables, chargement dans un entrepot ou un data lake. C'est le cas d'usage historique.
- **Feature engineering pour le ML** : calcul de features a grande echelle pour alimenter un Feature Store, preparation de jeux d'entrainement pour les modeles de machine learning.
- **Analyse exploratoire** : les Data Engineers et Data Scientists utilisent Spark en mode interactif (notebooks) pour explorer de gros datasets.
- **Streaming** : traitement de flux de donnees en quasi temps reel pour des cas d'usage comme la detection de fraude ou le monitoring.
### Spark et les alternatives
PySpark (l'API Python de Spark) est l'interface la plus utilisee. Pour les volumes moderees (quelques gigaoctets), des alternatives plus legeres comme DuckDB, Polars ou pandas suffisent et sont plus simples a utiliser. Spark prend tout son sens quand les donnees ne tiennent plus sur une seule machine et que le traitement distribue devient necessaire.
---
### Qu'est-ce que la tokenization dans les LLMs ?
Source : https://www.hymaia.com/qu-est-ce-que/tokenization/
La tokenization est le processus de découpage du texte en unités élémentaires (tokens) que les LLMs peuvent traiter. Ce mécanisme détermine les coûts d'utilisation, les limites de contexte et la capacité du modèle à traiter différentes langues. Chaque modèle utilise son propre tokenizer.
La **tokenization** est l'étape qui transforme du texte brut en une séquence de **tokens** — les unités élémentaires qu'un modèle de langage (LLM) peut manipuler. Un token n'est ni un mot ni un caractère : c'est un fragment de texte dont la taille varie selon l'algorithme de tokenization et la fréquence du mot dans les données d'entraînement.
### Comment ça fonctionne
Un tokenizer ne découpe pas le texte au hasard. Il applique un algorithme déterministe qui a été entraîné sur un large corpus de texte. Le principe général : les mots fréquents deviennent un seul token, tandis que les mots rares sont découpés en sous-unités.
Par exemple, le mot "embedding" sera probablement un seul token dans un tokenizer entraîné sur du texte technique anglais. En revanche, le mot "antidisestablishmentarianism" sera découpé en plusieurs sous-tokens. En français, un mot courant comme "données" peut être un seul token, tandis que "désintermédiation" sera segmenté.
### Principaux algorithmes
**BPE (Byte Pair Encoding).** Algorithme le plus répandu, utilisé par les modèles GPT d'OpenAI. Il part de caractères individuels et fusionne itérativement les paires les plus fréquentes jusqu'à atteindre un vocabulaire de taille cible (souvent 50 000 à 100 000 tokens). L'implémentation tiktoken d'OpenAI est une version optimisée de BPE.
**WordPiece.** Variante développée par Google pour BERT. Similaire à BPE mais utilise la vraisemblance du corpus plutôt que la fréquence brute pour décider des fusions. Préfixe les sous-tokens intermédiaires avec "##" pour indiquer qu'ils ne commencent pas un mot.
**SentencePiece.** Développé par Google, fonctionne directement sur le texte brut sans pré-tokenization par espaces, ce qui le rend adapté aux langues sans séparation explicite des mots (japonais, chinois). Utilisé par les modèles Llama de Meta et les modèles Mistral.
**Byte-level BPE.** Variante qui opère sur les octets plutôt que les caractères Unicode, garantissant la capacité à encoder n'importe quel texte, y compris les emojis ou les caractères rares. Utilisé par les modèles Claude d'Anthropic et GPT-4.
### Impact sur les coûts
Les fournisseurs de LLMs facturent à l'usage en nombre de tokens (entrée + sortie). Comprendre la tokenization est donc directement lié à la maîtrise des coûts. Quelques repères :
- En anglais, 1 token correspond en moyenne à 4 caractères ou 0,75 mot.
- En français, le ratio est moins favorable : environ 1 token pour 3 caractères, car les accents et les mots plus longs consomment plus de tokens.
- Du code source génère généralement plus de tokens que du texte naturel, en raison des noms de variables, de l'indentation et des caractères spéciaux.
Cette différence a des implications concrètes : un même document traduit en français coûtera 20 à 30 % de tokens de plus que sa version anglaise.
### Fenêtre de contexte
Chaque LLM a une **fenêtre de contexte** (context window) mesurée en tokens — c'est la quantité maximale de texte qu'il peut traiter en une seule fois, prompt inclus. Cette limite est une contrainte directe de l'architecture Transformer sous-jacente. GPT-4 propose jusqu'à 128 000 tokens, Claude jusqu'à 200 000, Gemini 1.5 Pro jusqu'à 2 millions.
Pour les systèmes RAG, la tokenization détermine combien de documents récupérés peuvent tenir dans le contexte, ce qui influence directement la qualité des réponses.
### Impact sur les performances multilingues
La tokenization est un facteur méconnu des performances multilingues des LLMs. Un tokenizer entraîné principalement sur de l'anglais aura un vocabulaire optimisé pour cette langue : les mots anglais courants seront des tokens uniques, tandis que les mots d'autres langues seront fragmentés en davantage de sous-tokens. Cela signifie que pour un même budget de tokens, le modèle peut traiter moins de texte en français qu'en anglais, et ses performances tendent à baisser sur les langues sous-représentées.
Les tokenizers récents (comme ceux de Llama 3 ou Mistral) intègrent des données multilingues dès l'entraînement du vocabulaire, améliorant le ratio tokens/mot pour les langues européennes.
### Tokenization et prompt engineering
La conscience de la tokenization aide en prompt engineering : des instructions concises et des mots courants consomment moins de tokens. Les espaces en début de ligne, la ponctuation superflue ou les répétitions inutiles augmentent la consommation sans apporter de valeur sémantique. Certaines techniques comme le few-shot prompting doivent arbitrer entre le nombre d'exemples fournis et le budget de tokens restant pour la réponse.
---
### Qu'est-ce que le vibe coding ?
Source : https://www.hymaia.com/qu-est-ce-que/vibe-coding/
Le vibe coding est une approche de développement logiciel où le développeur décrit ce qu'il veut en langage naturel et laisse une IA générer le code correspondant. Popularisé par Andrej Karpathy en février 2025, ce terme désigne un mode de programmation où l'on "code au feeling" avec l'IA comme exécutant.
Le **vibe coding** est une pratique de développement logiciel dans laquelle le développeur exprime ses intentions en langage naturel — descriptions, instructions, corrections — et délègue l'écriture du code à un assistant IA. Le terme a été introduit par Andrej Karpathy, cofondateur d'OpenAI et ancien directeur de l'IA chez Tesla, dans un post sur X (anciennement Twitter) en février 2025.
### L'idée originale
Karpathy décrivait sa propre expérience : il codait en décrivant ce qu'il voulait à un LLM, acceptait les suggestions sans toujours lire le code en détail, et corrigeait les erreurs en copiant-collant les messages d'erreur dans le chat. Son expression "I just see things, say things, run things, and copy-paste things, and it mostly works" résume l'approche. Le "vibe" fait référence à cette sensation de coder "au feeling", guidé par l'intuition plutôt que par une compréhension ligne par ligne du code produit.
### Comment ça fonctionne en pratique
Le vibe coding s'appuie sur des outils d'IA générative spécialisés pour le code :
**IDE augmentés.** Des éditeurs comme Cursor intègrent un LLM directement dans l'environnement de développement. Le développeur peut sélectionner du code, demander une modification en langage naturel, et l'IA réécrit le passage. L'outil Claude Code d'Anthropic pousse le concept plus loin en permettant de piloter l'ensemble du workflow de développement depuis le terminal.
**Générateurs d'applications.** Des plateformes comme Bolt, Lovable ou v0 (Vercel) permettent de décrire une application complète en quelques phrases et obtiennent un prototype fonctionnel en minutes. L'utilisateur itère ensuite par des instructions successives : "ajoute un bouton de connexion", "change la couleur du header", "connecte le formulaire à une API".
**Assistants intégrés.** GitHub Copilot, Codeium ou Amazon CodeWhisperer suggèrent du code en temps réel à partir du contexte du fichier ouvert et des commentaires du développeur.
### Ce que le vibe coding change
**Abaissement de la barrière d'entrée.** Des personnes sans formation en programmation peuvent créer des prototypes fonctionnels. Des product managers, des designers ou des entrepreneurs construisent des MVPs sans dépendre d'une équipe technique. Cela rejoint le mouvement des "product builders" — des profils hybrides qui combinent vision produit et capacité d'exécution technique via l'IA.
**Accélération du prototypage.** Pour les développeurs expérimentés, le vibe coding accélère les phases exploratoires : tester une idée, construire un POC, valider une architecture. Le code produit n'est pas nécessairement de qualité production, mais il permet de valider rapidement des hypothèses.
**Nouveau rapport au code.** Le vibe coding déplace la compétence clé du développeur : de "écrire du code" vers "formuler des intentions claires et évaluer le résultat". C'est une forme de prompt engineering appliquée au développement logiciel.
### Les risques et limites
**Dette technique invisible.** Le code généré par l'IA peut fonctionner sans que le développeur comprenne comment. Les bugs subtils, les failles de sécurité ou les mauvaises pratiques passent inaperçus quand personne ne lit le code en détail.
**Dépendance au modèle.** Si le LLM ne comprend pas une technologie spécifique ou récente, le vibe coder se retrouve bloqué sans les compétences pour déboguer manuellement.
**Scalabilité limitée.** Le vibe coding fonctionne bien pour des projets de petite à moyenne taille. Sur des codebases complexes avec de nombreuses interdépendances, les modifications en langage naturel deviennent ambiguës et le LLM perd en cohérence.
**Sécurité.** Du code généré sans revue approfondie peut contenir des vulnérabilités. Les guardrails de sécurité (linting, tests automatisés, revue de code) restent indispensables, voire davantage qu'avant.
### Vibe coding vs programmation traditionnelle
Le vibe coding ne remplace pas la programmation — il la complète. Les développeurs expérimentés l'utilisent comme un accélérateur tout en gardant la capacité de comprendre, modifier et déboguer le code produit. Les non-développeurs l'utilisent pour créer des outils internes ou des prototypes, en acceptant les limites de ce qu'ils ne maîtrisent pas.
La distinction qui se dessine est celle entre le "vibe coding" pur (accepter le code sans le comprendre) et le "AI-assisted coding" (utiliser l'IA comme un outil de productivité tout en restant maître du code). Les deux pratiques coexistent, avec des niveaux de risque différents.
---
### Qu'est-ce qu'un workflow dynamique en Agentic Coding ?
Source : https://www.hymaia.com/qu-est-ce-que/workflows-dynamiques-claude-code/
Un workflow dynamique est un script JavaScript avec lequel Claude Code orchestre plusieurs sous-agents de manière déterministe : création et configuration des agents, passage de paramètres, récupération des résultats, attente de complétion. Le script peut ensuite être sauvegardé et réutilisé.
Un **workflow dynamique** est un mécanisme d'Agentic Coding, disponible dans Claude Code, qui permet d'orchestrer une architecture multi-agents à partir d'un script JavaScript plutôt que d'une suite d'échanges en langage naturel. Le script pilote la création des sous-agents, leur configuration, le passage de paramètres, la récupération de leurs résultats en sortie et l'attente de complétion de certaines tâches avant de poursuivre.
### Une couche déterministe sur l'orchestration multi-agents
L'orchestration multi-agents pilotée uniquement par un prompt reste, par nature, non déterministe : le même prompt peut donner lieu à un enchaînement d'agents différent d'une exécution à l'autre. Le workflow dynamique inverse cette logique en fixant l'enchaînement dans du code : quels agents sont créés, dans quel ordre, avec quels paramètres, et ce qu'on fait de leurs résultats. On garde la flexibilité de l'IA à l'intérieur de chaque agent, mais le squelette d'exécution devient reproductible.
### Ce que le script permet de faire
Le script JavaScript d'un workflow dynamique peut notamment :
- **Créer des sous-agents** et les configurer avec un rôle, des instructions ou des outils spécifiques.
- **Passer des paramètres** à chaque agent au moment de sa création.
- **Récupérer les données produites en sortie** par un agent, pour les réutiliser dans la suite du script.
- **Attendre la complétion** de certaines tâches avant de déclencher les étapes suivantes, notamment lorsque plusieurs agents tournent en parallèle et que leurs résultats doivent être consolidés.
Une fois qu'un workflow fonctionne comme voulu, le script peut être sauvegardé et réutilisé pour de futures exécutions, sans avoir à reformuler l'orchestration à chaque fois.
### Les limites à connaître
**La consommation de tokens.** Un workflow dynamique fait souvent intervenir plusieurs agents en parallèle, chacun consommant ses propres tokens. Le coût cumulé peut monter rapidement, surtout sur des workflows à plusieurs étapes ou avec un grand nombre de sous-agents.
**Un accès restreint à l'API Node.js.** Même s'il s'agit d'un fichier JavaScript, le script n'a pas accès à l'intégralité de l'API Node.js : pas d'appels réseau via `fetch`, pas d'accès au système de fichiers. Le script reste cantonné à l'orchestration des agents, pas à des opérations d'entrée-sortie arbitraires.
### Quand utiliser un workflow dynamique
Les workflows dynamiques trouvent leur intérêt dès qu'une tâche gagne à être décomposée entre plusieurs agents spécialisés, mais que l'enchaînement doit rester prévisible d'une exécution à l'autre : revue de code croisée par plusieurs agents, traitement en parallèle d'un lot de fichiers, ou toute tâche qui bénéficierait d'une orchestration multi-agents sans dépendre entièrement de l'interprétation d'un prompt à chaque lancement.
---
## Blog
### FWD Conférence revient en 2026 : même communauté, nouvelle ère
Source : https://www.hymaia.com/blog/fwd-conference-revient-en-2026/
La conférence data & IA de référence revient le 16 novembre 2026, sous un nouveau nom, pour explorer l'ère agentique.
C'est la conférence où il faut aller si vous voulez du concret. C'est la conférence où venir en équipe pour partager et se challenger le temps d'une journée.
Le rythme est soutenu, plus de 40 talks dans la journée avec 25 minutes maximum par talk. C'est pour moi la durée idéale de concentration.
Et ce qui fait la différence, ce n'est pas le programme sur le papier. C'est ce qui se passe entre les talks. Les conversations dans les couloirs, les connexions, les idées qu'on ramène au bureau le lendemain et qui changent quelque chose.
Pour cette troisième édition, on revient le 16 novembre 2026 à la Cité Universitaire de Paris. Avec Hymaïa, le Modern Data Network et Christophe Blefari. Et avec plus de 600 participants attendus.
Mais avant de parler de ce qui arrive, une petite explication s'impose.
## Pourquoi FWD Conférence ?
On a changé le nom. Plus Forward Data Conference, mais FWD Conférence.
Pas parce que la data a disparu du sujet. Mais parce qu'aujourd'hui on y parle IA, et demain ce sera autre chose. Les équipes qu'on accompagne ne se demandent plus "comment on fait de la data". Elles se demandent "comment on fait tourner des systèmes d'agents en production, comment on gouverne tout ça, et comment on garde la main sur ce qui compte".
## Ce qui change en 2026 : l'ère agentique
L'édition 2025 explorait comment aligner data et business, comment construire des produits data qui créent de la valeur, comment faire de la GenAI au-delà du marketing.
En 2026, ces questions sont toujours là. Mais une nouvelle s'est imposée : comment est-ce qu'on construit des systèmes d'agents fiables, à l'échelle, dans des organisations réelles ?
Ce n'est plus une question de POC. C'est une question d'infrastructure.
## Les quatre grandes thématiques
**Data Foundations for Humans & AI**
Avant de parler d'agents, il faut parler de fondations. Data modeling AI-ready, qualité, observabilité, cost engineering. Les bases qui permettent à des humains de décider et à des systèmes d'agir. Sans elles, rien ne tient.
**Agentic Systems Engineering**
Le cœur de l'édition 2026. Évaluation de modèles, gestion du contexte, architectures multi-agents, sécurité, contrôle des coûts. Comment on construit des systèmes qui agissent de manière fiable, et pas juste en démo.
**Engineering Shifts**
L'IA transforme les pratiques existantes : développement logiciel, data engineering, analytics, product engineering. Pas de remplacement. Une transformation profonde des métiers et des workflows.
**Leading the AI Shift**
La dimension organisationnelle. Comment on embarque les équipes, comment on gouverne, comment on définit les responsabilités, comment les modèles opérationnels évoluent. Parce que les sujets techniques ne suffisent pas si l'organisation ne suit pas.
## Ce qui ne change pas
La mission reste la même : *Accelerating careers, growing teams and shaping the future of the French and European Data community. Together.*
Et le format aussi : des keynotes inspirantes, des retours terrain sans filtre, des workshops concrets pour aller plus loin, et suffisamment d'espace pour que les vraies conversations aient lieu.
Rien de tel qu'un aftermovie pour retrouver l'ambiance de l'édition 2025 :
## Rendez-vous le 16 novembre
La FWD Conférence se tient le 16 novembre 2026 à la Cité Universitaire de Paris, de 8h30 à 20h00.
Les inscriptions sont ouvertes. Les annonces speakers arrivent prochainement sur LinkedIn.
Si vous voulez être dans la salle quand ça se passe, c'est le moment.
Découvrir la FWD Conférence 2026
---
### Leboncoin x hymaïa : Former les Product & Engineering Managers aux enjeux Data & IA
Source : https://www.hymaia.com/blog/leboncoin-x-hymaia-former-les-product-engineering-managers-aux-enjeux-data-ia/
Comment leboncoin forme ses Product & Engineering Managers aux enjeux Data & IA.
L’intelligence artificielle n’est plus une option : c’est un levier de croissance et de performance produit. Chez **leboncoin**, cette conviction se traduit déjà par plus de [**70 fonctionnalités IA en production**](https://youtu.be/ExiLjRIiwsI?feature=shared), portées par une transformation en profondeur du modèle produit-tech-data.
Mais intégrer efficacement l’IA dans des produits digitaux demande plus qu’une technologie : cela nécessite **une compréhension fine de ses spécificités,** et une **collaboration fluide entre Product, Tech et Data**. C’est dans cette optique que leboncoin a fait appel à **Hymaïa**, pour accompagner et former **80 Product Managers et Engineering Managers** à travers un parcours sur-mesure, mêlant **acculturation, montée en compétence et mise en pratique.**
**🎯 Un objectif clair : intégrer la Data & l’IA au coeur des produits et du quotidien des Product & Engineering Managers**
Cette formation vise à fournir aux PM et EM toutes les bases nécessaires pour :
- Comprendre les fondamentaux de la Data et de l’IA, en lien avec les cas d’usage produits et métiers
- Différencier les produits Data/IA des produits software classiques : incertitude, itération, dépendance à la donnée…
- Adapter les outils et méthodes du Product Management au contexte spécifique des projets IA pour maximiser la valeur métier
- Intégrer l'IA dans son quotidien pour maximiser sa productivité
**🧩 Une pédagogie ancrée dans les usages, construite sur mesure**
Chez hymaïa, nous croyons à une pédagogie **expérientielle**, **collaborative et applicable dès le terrain**.
Le parcours proposé par Hhymaïa combine :
- **La Fresque de la Data et de l’IA** pour poser une vision partagée des enjeux éthiques, technologiques et métiers
- Un programme **« Data & AI Product Manager »** structuré autour de cas concrets, d’ateliers pratiques, et de contenus théoriques accessibles aux non-tech
- Des **formats en petits groupes**, favorisant les échange entre pairs, la transversalité produit-tech, et le diffusion progressive des bonnes pratiques IA
**💡 Un accompagnement aligné avec les ambitions IA de leboncoin**
Le travail mené par Lleboncoin sur l’IA repose sur des principes forts : **industrialiser** sans gadgetiser, **mesurer l’impact**, **favoriser la transparence et outiller les équipes**. L’accompagnement proposé par hymaïa répond à ces enjeux :
- 👉 Acculturer les PM & EM pour qu’ils soient moteurs dans la détection, le cadrage et le pilotage des opportunités IA
- 👉 Structurer les échanges Produit-Tech-Data pour gagner en fluidité, en pertinence et en responsabilité
- 👉 Favoriser une culture Data transverse, cohérente avec l’intégration des Data Scientists dans les squads produit
**🚀 Un pas de plus vers l’intégration d’une IA utile et mesurable**
Former 80 PM et Engineering Managers, c’est **s’assurer que les décisions produit intègrent dès aujourd’hui les spécificités IA**. C’est aussi donner les moyens aux équipes de :
- Prioriser les bons cas d’usage
- Choisir les bons modèles
- Monitorer les bons indicateurs
- Et livrer des fonctionnalités utiles, durables, mesurables
**Vous aussi, vous cherchez à accélérer l’adoption de l’IA dans vos produits ?**
Hymaïa accompagne les entreprises dans le développement d’une **culture Data & IA à grande échelle**, grâce à des **formations sur-mesure**, du **conseil projet**, et des **événements pour faire communauté**.
📩 Parlons-en !
---
### Forward Data Conference revient en 2025 : encore plus ambitieuse, plus collective, plus inspirante !
Source : https://www.hymaia.com/blog/forward-data-conference-2025/
La Forward Data Conference revient en 2025 pour connecter toute la communauté Data & IA.
Des conférences sur la Data et l’IA, il y en a beaucoup. Mais une conférence qui rassemble réellement toute la communauté, qui connecte les expertises et qui fait avancer nos pratiques collectivement ? Il n’y en a qu’une : la Forward Data Conference.
Et elle revient le 24 novembre 2025 à Paris, pour une deuxième édition encore plus ambitieuse.
Co-organisée par Hymaïa, le Modern Data Network et Christophe Blefari, la Forward, c’est bien plus qu’un événement : c’est un moment clé pour penser l’avenir de la Data & de l’IA, ensemble.
**Une communauté qui grandit, un événement qui s’élève**
En [2024](https://www.forward-data-conference.com/archive), nous avons planté une graine. En 2025, nous voulons la faire fleurir.
La première édition, c’était un pari. Et il a dépassé toutes nos attentes.
Dès l’ouverture, on voulait que cette conférence ne serait pas comme les autres :
🧘♂️ Une respiration collective les yeux fermés, animée par François Laurain pour bien commencer la journée.
🎹 Un pianiste sur scène – le brillant Tiankai Feng – qui accueillait chaque speaker avec une chanson personnalisée (!).
🎙 Un podcast en live pour discuter de l’avenir du métier de CDO avec Virginie Cornu et Claire Lebarz, animé par l’incomparable Robin Conquet.
Et surtout, des talks qui ont marqué les esprits :
- [Hannes Mühleisen](https://youtu.be/1QSs5XY8Hvc) et sa masterclass sur DuckDB.
- [Joe Reis](https://youtu.be/2sIKh_J60xA), qui a mêlé MMA et data modeling dans une keynote aussi originale que percutante.
- [Anne-Claire Baschet](https://youtu.be/Q4Yd7zzsZ2Y), venue raconter l’implémentation concrète de l’IA générative chez Mirakl.
- [Paul Marcombes](https://youtu.be/ehB80iZjdwU), avec une démo enthousiasmante de BigFunctions.
- [Naim Kosayyer](https://youtu.be/uDB6siv9Ols), qui a captivé la salle avec un talk sur la réduction des hallucinations des LLMs.
- [Adrien Sedeaud](https://youtu.be/27k4W4eudq8), qui nous a montré comment la data aide à façonner les champions de demain à l’INSEP.
- Et [Tiankai Feng](https://youtu.be/tY8LpWjZTng), encore lui, qui a clôturé la journée avec un talk aussi sensible qu’essentiel : Humaniser la stratégie data.
Mais au-delà des contenus, ce qu’on retient, c’est l’énergie.
Une vraie communauté : des expert·es brillants, accessibles, curieux et bienveillants, des échanges passionnants pendant les pauses, une ambiance unique.
**L’ambition 2025 : inspirer, structurer, outiller**
La Forward 2025, c’est une conférence pour tous ceux qui construisent aujourd’hui l’avenir de la Data & de l’IA : stratèges, builders, makers, décideurs, tech leads, CPO, CDO, Head of Data, Product Managers, ML Engineers, Analytics Engineers…
Notre mission ne change pas :
👉 **_Accelerating careers, growing teams and shaping the future of the French (and European) Data community. Together._**
Mais cette année, nous voulons aller encore plus loin :
💡 En proposant des visions éclairées, pour se projeter dans les transformations à venir
🛠 En partageant des actions concrètes, immédiatement transposables dans vos équipes
🤝 En favorisant des connexions durables, entre profils, rôles et expertises
**Les 4 grandes thématiques de 2025**
Nouveauté cette année : nous passons de 3 à 4 grands piliers, pour refléter les évolutions majeures du secteur et mieux structurer les discussions.
**1- Data & AI Strategy, Organisation & Products**
- Comment structurer, aligner et faire évoluer des équipes Data & IA ?
- Comment créer des produits data performants et utiles ?
- On parlera stratégie d’adoption, IA à l’échelle, operating models, data product thinking et plus encore.****
**2- ML, AI & GenAI Engineering**
- MLOps, GenAI toolkits, IA responsable, architectures hybrides… place aux experts qui construisent le réel, au-delà du buzz.
**3- Analytics & Data Engineering**
- Data Quality, Data Contracts, Observabilité, Analytics Engineering, DataOps, outils de gouvernance : on décortique les fondations des plateformes data
**4- Product, Tech & Business Alignment (NOUVEAU)**
Parce que la Data & l’IA n’ont de valeur que lorsqu’elles créent de l’impact business, cette thématique explore l’alignement entre produit, tech, métiers et data.
- On parlera delivery, prise de décision augmentée, collaboration cross-fonctionnelle et mesure d’impact.
**Au programme : talks, workshops, débats… et rencontres**
Nous restons fidèles à ce qui a fait le succès de la première édition :
- Des keynotes inspirantes pour ouvrir les perspectives
- Des REX concrets de grandes entreprises et scale-ups
- Des workshops collaboratifs pour apprendre en pratiquant
- Des formats courts, pour challenger ses idées et s’ouvrir à d’autres points de vue
- Et surtout : des échanges humains, entre passionnés, curieux, experts et leaders
**Une conférence pas comme les autres**
Forward, c’est aussi une certaine idée de la conférence.
Pas une vitrine. Pas un tunnel de pitchs.
Mais un moment de respiration et de projection.
Un lieu où chaque profil, chaque rôle, chaque expérience trouve sa place.
Où l’on peut venir en équipe, apprendre ensemble, et repartir avec des idées actionnables dès le lendemain.
**🎟 Rejoignez-nous le 24 novembre 2025**
✌️Toutes les informations disponibles sur le site de la [Forward Data Conference](https://www.forward-data-conference.com/)
📍 Paris — Maison Internationale, Cité Universitaire
🎫 [Billetterie ouverte](https://www.billetweb.fr/forward-data-conference-2025)
🗓️ Bloquez la date dès maintenant dans vos calendriers !
👉 [Suivez-nous sur LinkedIn](https://www.linkedin.com/company/forward-data-conference/) pour découvrir les premières annonces de speakers, de thématiques et de partenaires.
---
### Forward Data Conference Paris 2024 : Participer à la 1ère édition de la conférence internationale Data & IA
Source : https://www.hymaia.com/blog/forward-data-conference-paris-participer-a-la-1ere-edition-de-la-conference-internationale-data-ia/
Pourquoi et comment nous avons créé la Forward Data Conference, conférence Data & IA à Paris.
Des conférences Data & IA, il y en a beaucoup. Mais, à notre goût, aucune capable de fédérer véritablement notre communauté dans toute son étendue.
Soit trop commerciale, soit trop niche.
Nous sommes en juillet 2024 lorsque nous pensons qu'il manquait dans notre paysage une conférence majeure Data & IA en France et en Europe qui rassemble et fédère cette communauté.
Alors nous nous sommes entourés des meilleurs réseaux et personnes pour mener à bien un nouveau projet.
C’est ainsi qu’**Hymaïa** s’est joint au **Modern Data Network** et à **Christophe Blefari** afin de créer la [Forward Data Conference](https://www.hymaia.com/event/forward-data-conference).
Le 25 novembre 2024, nous avons organisé la première édition de la Forward Data Conférence.
## Une conférence majeure Data & IA à Paris
Cette conférence n’est pas centrée uniquement sur l’intérêt individuel et l’unique popularité de têtes d’affiches.
Sa mission, nous l’avons écrite dès le premier jour : **Accelerating careers, growing teams and shaping the future of the French Data community. Together.**
_Together_. C’est bien ça la clé. Car il n’y aura pas de futur pour la Data et l’IA sans un travail collaboratif et une connexion entre les différentes expertises et disciplines.
A travers cette conférence, notre objectif est de matérialiser un Hub de partage et de savoir.
Un moment et un lieu pour que :
- Toute une équipe puisse se réunir et grandir ensemble, où chaque profil trouve sa voie ;
- Chacun puisse développer son T-Shape : approfondir son expertise principale et élargir sa zone d'apprentissage ;
- Les équipes puissent partager les meilleures pratiques et apprendre les unes des autres ;
- Les silos cèdent leur place à l’empathie et la collaboration entre tous les praticiens.
## Inspirer, partager, apprendre ensemble
Afin de matérialiser cela, nous avons décidé d’organiser le déroulé de la conférence via différents axes :
- Des talks, bien entendu, afin de partager ses convictions et projeter dans le futur ;
- Des workshops et rencontres, où des équipes pourront se croiser, débattre, et apprendre ensemble ;
- Des débats, sans consensus mou, pour confronter les idées et les visions.
Pour résumer, pas que que du top-down, pour favoriser les rencontres et les apprentissages collectifs, voilà notre ambition.
## En 2024, c'était 3 thématiques pour rassembler et “connect the dots"
Pas besoin d’une liste pléthorique de thématiques malgré la diversité potentielle de sujets pour une conférence sur un domaine aussi large.
Nous en avons défini trois, représentatifs des principaux champs d’activité et des compétences, ainsi que représentatifs de la composition des équipes.
### 1\. Strategy, Organisation, Data & AI Products
Cette thématique est faite pour parler création et croissance d’équipes Data, Data & AI Strategy, Data Mesh, mais aussi Data & AI Product Management et lien entre Produit et Data
### 2\. AI & ML Engineering
L’endroit rêvé pour parler MLOps, IA (Générative ou pas) et ML Engineering
### 3\. Data & Analytics Engineering
Le futur des Data et Analytics Engineers s’inscrit ici. On y parlera DataOps, Data Quality, Data Observability, Platform Engineering, Analytics Engineering et Tracking.
## 300 places, pour faciliter les échanges
Ce sera la première édition de la Forward Data. Nous privilégions l’expérience vécue à la quantité, afin de vous faire vivre la journée que nous aimerions vivre.
En 2024, la Forward Data Conference présente un programme riche et diversifié avec 40 sessions au total, réparties dans 3 salles différentes (Main Stage, Future Room et Predict Room). La conférence est véritablement internationale avec 17 présentations en anglais et 15 en français.
Le contenu est structuré autour de trois grands thèmes :
- Data Analytics & Engineering (17 sessions)
- Stratégie, Organisation & Produits (10 sessions)
- AI, ML & Engineering (8 sessions)
Les formats sont variés pour s'adapter à différents types de contenus :
- 15 présentations de 25 minutes
- 9 workshops pour une expérience plus pratique
- 8 lightning talks de 5 minutes
La majorité des sessions se déroulent sur la Main Stage (26 talks), suivie par la Future Room (12 talks) et la Predict Room (9 talks), offrant ainsi une expérience bien équilibrée entre les différentes salles.
Le détail du programme 2024 est ici : [https://www.forward-data-conference.com/programme/programme-2024](https://www.forward-data-conference.com/programme/programme-2024)
## Comment participer à l'édition 2025 ?
### 1\. En achetant ses billets
Nous souhaitons favoriser les entreprises venant en équipe. C’est pourquoi une réduction de 20% est appliquée pour tout achat d’un pack de 5 billets.
[Voici la page de notre billetterie 2025](https://www.billetweb.fr/forward-data-conference-2025)
### 2\. En proposant un (ou plusieurs) talk
Malheureusement, le CFP est terminé. Nous avons reçu beaucoup de propositions. Nous ne cherchons pas que des “têtes d’affiches”, et souhaitons pouvoir trouver des perles rares : des entreprises et personnes qu’on ne croise pas à toutes les conférences et tous les meetups, mais qui ont des retours d’expérience et des convictions incroyables.
### 3\. En sponsorisant l’événement
Plusieurs packages sont possibles. [Contactez-nous directement](https://www.forward-data-conference.com/contact) pour en parler.
Pour toute autre information, rendez-vous sur le [site de la conférence](https://www.forward-data-conference.com/), et suivez le compte [Forward Data](https://www.linkedin.com/company/forward-data-conference) pour vivre les inside de l’organisation !
Looking Forward to Forward Data !
---
### Tracking des accès à la donnée dans AWS
Source : https://www.hymaia.com/blog/tracking-des-acces-a-la-donnee-dans-aws/
Comment suivre et auditer les accès en lecture à la donnée sur AWS (S3, Athena) avec CloudTrail, EventBridge, Lambda et Firehose.
## Surveiller les accès à la donnée dans AWS
Au sein d'une Data Platform nous pouvons avoir besoin de surveiller les accès à la donnée en lecture de l'ensemble de nos utilisateurs. AWS a d'ailleurs publié un article nommé [Auditing, inspecting, and visualizing Amazon Athena usage and cost](https://aws.amazon.com/fr/blogs/big-data/auditing-inspecting-and-visualizing-amazon-athena-usage-and-cost/) qui propose une solution pour le mettre en place.
Dans cet article je vais expliciter comment j'ai implémenté l'architecture décrite par AWS et vous partager mes conseils.
Les exemples de code qui seront donnés dans l'article seront des extraits pour éviter la surcharge. Pour récupérer les exemples complets, je vous invite à aller voir notre [repository GitHub sur le tracking d'accès à la donnée sur AWS](https://github.com/hymaia/tracking-data-access-aws).
Voici ce que nous allons déployer ensemble dans cet article :

## Quels types d'accès surveiller ?
Dans l'exemple que nous allons implémenter, nous choisirons de surveiller les types d'accès les plus courants sur AWS :
- Un GetObject sur S3
- Une requête via Athena
## Quelles informations collecter ?
Ce qui est intéressant c'est de pouvoir vérifier qui a accédé à de la donnée, quand, et quelle donnée ? Pour cela il est intéressant de récupérer à minima :
- Le chemin dans S3 du fichier
- L'identifiant de la personne
- La date et l'heure à laquelle la requête a été lancée
- La requête SQL (si c'est Athena)
- L'action (si c'est S3)
## Les événements à collecter
### Les événements S3
Sur S3 nous n'avons qu'un événement à collecter, c'est le `GetObject`. C'est l'événement produit quand on télécharge un fichier, peu importe comment. Directement depuis la console web ou via son terminal en local avec un simple `aws s3 cp`, les deux produiront un `GetObject`.
Pour le récupérer nous avons besoin de créer un CloudTrail spécifique. Dans la documentation Terraform de aws_cloudtrail, on trouve un exemple qui s'appelle [Logging All S3 Object Events Except For Two S3 Buckets By Using Advanced Event Selectors](https://registry.terraform.io/providers/hashicorp/aws/latest/docs/resources/cloudtrail#data-event-logging).
Cet exemple est intéressant car comme son nom l'indique, il permet de récupérer tous les événements venant de S3 sur des objets sauf pour 2 buckets. C'est un pattern très pratique quand par défaut on veut tout surveiller, sauf exception.
Notre exception sera le bucket S3 qui stockera les données de surveillance d'accès à la donnée, qui ne fait pas partie de la donnée métier de la data platform.
### Les événements Athena
Sur Athena c'est un peu plus compliqué. Par défaut lorsqu'on lance une requête, on peut capter les types d'événements avec EventBridge.
Nous avons bien l'heure à laquelle la requête a été lancée, mais c'est tout. Pour avoir les informations sur l'identité de l'utilisateur, il va falloir passer par un CloudTrail encore une fois.
## Capter les événements
CloudTrail nous permet de collecter les événements pour les stocker sur S3. Sauf qu'en l'état, ces événements ne sont pas requêtables simplement via Athena.
Nous avons besoin d'une étape de traitement des événements pour récupérer les informations qui nous intéressent. Pour cela nous pouvons utiliser une Lambda. Mais pour la déclencher il faut capter les événements de CloudTrail et les envoyer vers notre Lambda.
EventBridge est la solution poussée par AWS pour ce cas d'usage. Je trouve également que ce service est idéal dans notre cas car :
- Le service est gratuit tant qu'on est sur des événements managés par AWS envoyés à un service managé du même compte, c'est notre cas ici
- Nous n'avons pas besoin d'un temps de réaction très rapide
- Nous n'avons pas besoin d'une garantie dans l'ordre de traitement des événements
Il nous faut créer 2 règles pour nos 2 types d'événements.
Il y a une petite subtilité pour les événements de `GetObject` sur S3. Lorsque nous lançons une requête avec Athena par exemple, celui-ci va s'occuper à notre place de faire des `GetObject` sur S3. Si vous avez une source de données composée de milliers de fichiers que Athena doit lire, cela va créer 1000 lignes dans notre table de surveillance des accès à la donnée.
Comme nous avons prévu de traquer les requêtes faites avec Athena, il est plus pratique d'ignorer les `GetObject` de celui-ci pour éviter d'être inondé d'événements redondants. Pour cela il suffit de surveiller le champ `sourceIPAddress` pour filtrer l'IP de Athena.
## Traitement sur les événements
Pour traiter nos événements et conserver que les informations qui nous intéressent, on va utiliser une Lambda.
Ce qui va le plus nous intéresser c'est le code de la Lambda, que je vous propose en Python.
### Le handler
Comme nous pouvons recevoir 2 événements différents dans notre Lambda, le handler est un simple if / else qui redirige le parsing en fonction du type d'événement reçu.
Une fois le parsing fait, on l'envoie à Firehose pour qu'il écrive des micro batchs en parquet sur S3.
### Récupérer les informations d'un GetObject sur S3
Ici pas trop de surprise, l'événement contient tout ce dont on a besoin, il n'y a qu'à se servir.
### Récupérer les informations d'une requête Athena
L'événement que reçoit notre Lambda en sortie de EventBridge contient tout sauf 1 information : la requête SQL lancée. Le champ `queryString` qui contient la requête SQL est caché.
Pour obtenir cette information, il faut requêter Athena via le `queryExecutionId`.
## Écrire les informations dans S3
Dernière étape, écrire dans S3 ce qu'on a collecté et rendre la donnée accessible dans le Glue Catalog.
Pour cela Firehose est notre ami. Ce service fonctionne comme un accumulateur de données qui va écrire après qu'une de ses 2 conditions soit remplie :
- Un certain temps s'est écoulé
- Une certaine quantité de données a été reçue
Nous pouvons également configurer Firehose pour qu'il écrive au format parquet. Pour cela il faut lui donner une table Glue décrivant le schéma de la donnée cible.
Dernier point à ne jamais négliger quand on traite de la donnée : le partitionnement. Dans 5 ans, lorsqu'on aura collecté quelques centaines de Go de données, il sera beaucoup plus confortable et moins cher de pouvoir optimiser nos recherches d'accès en filtrant sur des partitions. La date du jour est l'exemple le plus typique.
**Attention :** on va rencontrer un problème avec Firehose et le partitionnement, c'est qu'il ne gère pas lui-même la mise à jour dans le catalogue Glue des nouvelles partitions créées. Cela signifie que dans notre cas, où chaque jour nous créons une nouvelle partition, il va falloir mettre à jour la table, par exemple avec la commande `MSCK REPAIR TABLE`.
Mais pour une version plus automatisée, on pourrait utiliser les crawlers de Glue. Un prochain article peut-être.
## Plus qu'à tester !
Pour tester je vous invite à suivre les instructions du [repository GitHub](https://github.com/hymaia/tracking-data-access-aws) où vous retrouverez le terraform complet ainsi que le code de la Lambda.
## Aller plus loin
Quelques idées pour aller plus loin.
Nous aurions pu collecter d'autres informations comme :
- l'adresse IP de l'utilisateur
- la quantité de données traitée par la requête Athena
Actuellement chaque requête sur la table qui historise les accès à la donnée est elle-même historisée dans cette table, ce qui pourrait être filtré.
Nous pourrions mettre en place une DLQ en cas d'échec de traitement d'un événement par la Lambda, pour éviter d'en perdre.
Dans l'article d'AWS sur lequel je me suis basé, il est proposé de créer 1 pipeline d'ingestion par type d'événement afin de bien tout séparer. Cela signifie dans notre cas qu'on devrait créer 2 lambdas, 2 firehoses et 2 tables Glue.
---
### De la Magie à la Maîtrise : Démystifier l’IA pour maximiser son adoption
Source : https://www.hymaia.com/blog/de-la-magie-a-la-maitrise-demystifier-lia-pour-maximiser-son-adoption/
Surconfiance, désillusion... Comment passer de la pensée magique à une vraie maîtrise de l'IA.
## Transformer la perception de l'IA pour une adoption réussie
L'un des principaux défis à surmonter pour l'adoption généralisée de l'IA en entreprise est la perception qu'elle relève de la "magie" plutôt que d'un ensemble d'outils compréhensibles qui boostent la productivité.
Cette perception peut entraîner deux réactions problématiques :
**1 - L’illusion d’infaillibilité**
Lorsque les équipes voient l'IA comme une technologie magique, leurs attentes deviennent souvent irréalistes, conduisant à :
- Une **confiance excessive** : accepter les résultats sans analyse critique, risquant des décisions basées sur des informations imprécises
- Un **découragement rapide** : abandonner des initiatives prometteuses quand l'IA ne répond pas à ces attentes démesurées
**2 - L'Effet Dunning-Kruger dans l'Adoption de l'IA**
Comme l'expliquait [Tristan Charvillat lors de l'**AI Product Day**](https://youtu.be/NRxG0clMQAE?feature=shared):"_On commence par un pic... on devient rapidement confiant qu'on maîtrise tout... On se sent au sommet, mais en réalité, on découvre à peine la surface._"

Cette phase initiale de surconfiance précède généralement une "vallée du désespoir" lorsque les équipes réalisent que l'IA n'est pas magique mais nécessite une compréhension approfondie. Beaucoup d'organisations restent bloquées dans cette vallée, sans jamais atteindre une mise en œuvre efficace.
### La Vérité sur les LLM
Un malentendu courant est de croire que les LLM sont conçus pour produire des vérités absolues. En réalité, ils sont programmés pour générer des réponses qui paraissent plausibles et cohérentes, mais pas nécessairement pour fournir "la vérité".Cette nuance est essentielle pour développer une approche éclairée de l'IA.
### Une approche structurée pour maîtriser l'IA
Les entreprises qui réussissent leur transformation IA suivent un cadre méthodique pour passer de la "pensée magique" à une véritable maîtrise :
1. Créer des parcours d'apprentissage sur mesure
2. Cultiver la pensée critique
3. Mener des expérimentations ciblées
Explorons ces trois piliers en détail.
#### **Des formations adaptées aux besoins spécifiques**
Les formations génériques sur l'IA manquent souvent leur cible. Les entreprises les plus avancées développent des programmes personnalisés qui expliquent :
- Le fonctionnement concret des LLM et leur processus de génération
- L'importance cruciale des données dans les performances de l'IA
- Les techniques pratiques d'ingénierie de prompts
- Les méthodes d'évaluation des résultats obtenus
Les programmes les plus efficaces privilégient l'application pratique aux concepts théoriques, avec des contenus adaptés à chaque métier – les besoins du marketing étant naturellement différents de ceux du service juridique.
#### **Cultiver un regard critique constructif**
Les organisations performantes encouragent leurs équipes à analyser intelligemment les résultats de l'IA en comprenant :
- L'origine et la qualité des données d'entraînement
- L'influence des prompts sur les réponses générées
- La nature probabiliste du fonctionnement de l'IA
- Les limitations et cas particuliers à surveiller
Cette approche critique, loin d'être un frein, devient un accélérateur d'adoption éclairée.
#### **L'expérimentation comme moteur d'apprentissage**
Plutôt que d'aborder l'IA de façon abstraite, les organisations les plus matures mettent en place une démarche d'expérimentation structurée :
- Commencer par des cas d'usage ciblés à forte valeur ajoutée
- Définir des critères de succès mesurables
- Établir des cycles de feedback rapides
- Documenter les réussites comme les apprentissages
### L'exemple de PayFit : une adoption réussie à grande échelle
PayFit a orchestré sa stratégie d'adoption avec l'initiative "AI Connect Week" – une semaine immersive dédiée à l'IA comprenant 10 à 15 conférences :
"_Nous avons organisé quelque chose que nous appelions la Semaine de Connexion IA. C'était une semaine complète où nous avions, je pense, environ 10 ou 15 conférences d'acteurs internes discutant et montrant ce qu'ils faisaient. Également des partenaires externes qui expliquaient ce qui se passe actuellement_."
Cette approche a permis de :
- Présenter des applications concrètes plutôt que des concepts abstraits
- Montrer des résultats tangibles obtenus par d'autres équipes, créant une émulation positive
- Exposer les collaborateurs aux innovations du secteur grâce à des experts externes
L'objectif allait au-delà de l'information : il s'agissait de susciter l'enthousiasme et l'envie d'explorer.
PayFit a délibérément privilégié une approche sur mesure plutôt que des formations standardisées :
_"Nous avons fait une formation personnalisée. C'est important de préciser personnalisée car les formations génériques peuvent être soit trop longues à absorber, soit trop génériques pour pouvoir les mettre en pratique."_
Pour pérenniser cette dynamique, PayFit a instauré un réseau de **AI Champions** dans chaque département :
"Ce sont des relais opérationnels qui ont la responsabilité du succès au sein de leurs équipes. Ce ne sont pas des personnes techniques. Ce sont souvent des opérationnels. Mais qui ont passé un temps significatif à travailler sur la technologie. Ils commencent donc à saisir les concepts clés que j'ai mentionnés auparavant."
Pour soutenir ces ambassadeurs, l'entreprise a développé des tableaux de bord de suivi :
"Si je suis un responsable commercial, je peux que j'ai deux personnes qui utilisent l'IA beaucoup plus que les autres. Je peux aussi voir avec quels agents ils communiquent. Je peux donc comprendre pourquoi ces personnes le font quand d'autres ne le font pas."
Les résultats de cette approche sont remarquables :
- 150 utilisateurs quotidiens actifs
- Plus de 60% de l'organisation utilisant l'IA chaque semaine
- Des gains d'efficacité spectaculaires (le mapping de comptes, qui prenait 7-10 minutes, s'effectue désormais en quelques secondes)
- Un assistant "PayFit Copilot" adopté par plus de 75% des administrateurs dans trois pays, avec plus de 1000 interactions quotidiennes
_"En un an et demi, nous avons réussi à passer de presque zéro capacités et compétences dans cette technologie à quelque chose de bien intégré et à fort impact pour notre organisation."_
Pour découvrir l'intégralité du retour d'expérience PayFit : [https://www.youtube.com/watch?v=NJ\_1PFRFneY](https://www.youtube.com/watch?v=NJ_1PFRFneY)
### **Conclusion : La passage de la Magie à la Maîtrise**
L'évolution de la perception de l'IA, de la magie à la maîtrise, suit un parcours prévisible :
1. **Découverte enthousiaste** : Les équipes sont captivées par les possibilités de l'IA
2. **Phase de surconfiance** : Optimisme basé sur une compréhension superficielle
3. **Période d'ajustement** : Recalibrage des attentes face à la complexité réelle
4. **Montée en compétence** : Développement d'une compréhension approfondie grâce à l'apprentissage structuré
5. **Excellence opérationnelle** : Intégration efficace et stratégique de l'IA fondée sur une vision réaliste
Grâce à approche structurée pour démystifier l'IA – formation personnalisée, pensée critique, expérimentation ciblée, supervision humaine, métriques pertinentes et déploiement progressif – il est donc possible de transcender la perception magique pour atteindre une maîtrise réelle de cette technologie transformatrice.
---
### 10 écueils limitant l’impact de la Data sur les produits et organisations
Source : https://www.hymaia.com/blog/10-ecueils-limitant-limpact-de-la-data-sur-les-produits-et-organisations/
10 écueils qui empêchent les organisations de passer la Data à l’échelle. Les connaissez-vous ?
**Nous entrons aujourd’hui dans l’ère de la Data At Scale :** les premiers succès de Produits Data arrivent et des enseignements ont été tirés. Le souhait est maintenant de passer à l’étape supérieure : favoriser le lancement de plusieurs Use Cases Data en parallèle et démocratiser la Data au sein de toute l’entreprise pour que chacun puisse être en capacité de prendre des décisions à partir de celle- ci. **En d’autres termes : devenir Data Centric. Sauf que ce passage à l’échelle est un chemin semé d’embûches,** et c’est un véritable accompagnement au changement qu’il faut opérer, tant au niveau organisationnel que technologique et méthodologique.
Forts de nos expériences et de nos rencontres avec de nombreux Data Leaders, **nous avons recensé 10 écueils à éviter afin de franchir un cap et amplifier l’impact de la Data sur les produits et organisations.** De l’organisation stratégique au dimensionnement des équipes en passant par les bonnes pratiques de développement de Produits Data, chaque composante aura son lot d’erreurs potentielles. Vous vous reconnaîtrez peut-être dans certaines et pourrez être dans la proactivité pour d’autres. Quelle que soit votre situation, l’objectif est de vous aider à prendre du recul pour prendre les bonnes décisions.
Nous avons organisé nos pensées comme un recueil de points de blocages régulièrement observés lorsque l’on souhaite franchir un cap dans l’impact de la Data dans son organisation et ses produits. Les écueils peuvent être regroupés en trois grandes catégories :

## Écueils Organisationnels
- Voir les équipes Data comme des “vendeuses de services”
- Ne pas avoir une équipe Data assez diversifiée
- Croire que la culture Data s’arrête à l’équipe Data
- Ne pas investir dans son équipe Data
## Écueils Méthodologiques
- Se lancer trop vite dans des Use Cases complexes
- Tomber dans le piège du PoC infini
- Être pris au piège par ses propres biais
## Écueils Techniques
- Penser que sa donnée est de confiance et ne pas investir dans sa qualité
- Penser que la Data est exempte des bonnes pratiques de Software Engineering
- Penser “one-shot” pour l’industrialisation du Machine Learning
Chaque écueil fera l’objet d’un article dédié.
Si vous souhaitez plutôt avoir l’ensemble à portée de main, rien de plus simple ! Vous pouvez [télécharger notre eBook](https://eu1.hubs.ly/H01QVgc0) dédié directement en pdf, ou bien vous le procurer en version imprimée ou Kindle sur [Amazon](https://www.amazon.fr/%C3%89cueils-limitant-limpact-produits-organisations-ebook/dp/B0BFJQP2P9/) !
---
### 10 leçons apprises en 8 ans dans le conseil
Source : https://www.hymaia.com/blog/10-lecons-apprises-en-8-ans-dans-le-conseil/
Diversité, autonomie, patience, convictions... Les leçons essentielles du conseil Data & IA.
Travailler dans le conseil, c'est s'immerger dans un monde où le changement est la seule constante et les défis font partie du quotidien. C'est un domaine qui séduit les esprits curieux, désireux d'élargir continuellement leur champ d'expérience. Mais être consultant va aussi au-delà de la maîtrise technique. Cela demande une capacité à s'adapter rapidement et à aborder chaque projet avec une perspective fraîche.
Voici un aperçu des leçons tirées après plusieurs années passées dans le conseil. En voyez-vous d’autres ?
## 1) Un arc-en-ciel de possibilités
_Dans chaque expérience, il y a une leçon à découvrir._
En tant que consultant, on s’expose à une grande diversité sous plusieurs angles : différents projets, différents secteurs, on utilise des méthodes variées, on joue avec plein d'outils.
Cette diversité constitue l'un des aspects les plus captivants de notre métier. Elle nous offre l'opportunité de collaborer avec différentes équipes, ce qui enrichit notre expérience professionnelle, nous permet d'acquérir et de perfectionner en permanence notre expertise. Ce perpétuel apprentissage rend le travail stimulant et gratifiant.
## 2) Éphémère mais impactant
_Brève présence, longue influence._
Dans cette aventure, nos séjours sont temporaires. Nous posons les fondations, lançons les initiatives, mais parfois, nous partons avant de voir tous les fruits de notre travail. C'est un peu comme planter un arbre dans un jardin : même si nous ne sommes pas là pour voir toutes ses fleurs éclore, nous savons que nous avons contribué à quelque chose de beau et de durable.
## 3) Cultivateurs d’autonomie
_Accompagner, c'est marcher à côté, pas devant._
Notre mission, c'est aussi de rendre les équipes avec lesquelles on travaille capables de voler de leurs propres ailes une fois qu'on est parti. C'est comme enseigner à quelqu'un à pêcher plutôt que de lui donner un poisson : on partage notre savoir pour qu'il continue à grandir même en notre absence.
## 4) La magie du partage
_La connaissance est le seul bien qui grandit quand on le partage._
Chaque expérience est une histoire à raconter, chaque leçon apprise est un trésor à offrir. En partageant les connaissances, les découvertes et la veille technologique, nous enrichissons non seulement nos clients mais aussi nous-mêmes, tissant un réseau vibrant d'échanges et de croissance. Embarquons nos clients dans les discussions, dans les conférences et dans l’écriture des articles ensemble !
## 5) Penser comme le patron
_Agir avec responsabilité, c'est voir au-delà de son propre rôle._
Adopter le mindset du dirigeant de l'entreprise cliente peut transformer l'approche d'une mission. Se responsabiliser en imaginant être à la tête de l'entreprise permet d'avoir un regard plus stratégique sur les problématiques rencontrées, favorisant ainsi des solutions qui s'alignent avec les objectifs à long terme du client. Est-ce que j’aurai pris cette décision si j’étais en tête de cette entreprise ?
## 6) Regard neuf
_Les yeux neufs découvrent de nouveaux mondes._
Arriver dans une nouvelle équipe, c'est avoir la chance de voir les choses d'un œil neuf. On observe, on analyse les points forts et les points à améliorer, et on partage nos découvertes. C'est un peu comme être le nouveau dans la classe qui remarque ce que les autres ne voient plus.
## 7) La patience est une vertu
_La patience est la compagne de la sagesse._
Dans ce métier, il faut savoir prendre son temps. Avant de proposer des solutions, on s'immerge dans l'environnement, on apprend à connaître les gens, les processus.
Cela représente un défi notable pour un consultant. Les clients nous sollicitent, s'attendant parfois à ce que nous disposions immédiatement d'une solution prête à l'emploi, alors que les stratégies les plus efficaces sont celles conçues sur mesure pour s'intégrer au contexte spécifique de l'entreprise, plutôt que d'être importées toutes faites de l'extérieur.
## 8) Respecter les règles
_Respect: la fondation de toute collaboration._
Chaque entreprise a ses propres règles, et en tant que consultant, on les respecte. Que ce soit les horaires, la manière de s'habiller ou la confidentialité des projets, on s'adapte. Ce sont les piliers sur lesquels repose notre intégrité professionnelle.
## 9) L’art de l’équilibre dans une relation tripartite
_Équilibre: conjuguer efficacité et épanouissement._
Naviguer avec équilibre entre soi, le client et le cabinet est une leçon clé en conseil. Cultiver une proximité avec le client pour offrir une valeur optimale, tout en restant engagé au sein de son entreprise, demande finesse et discernement. Cela représente un défi, certes, mais aussi une opportunité d'apprentissage. Face aux obstacles, le partage d'expériences avec les collègues s'avère être une source de soutien, d'innovation et de prise de recul.
## 10) Avoir des convictions, pas des certitudes
_Rien n'est plus dangereux que la certitude d'avoir raison._
L'expérience renforce nos convictions, essentielles pour soutenir les idées et innover.
Toutefois, il faut veiller à ne pas tomber dans le piège de la certitude absolue. Cet état d'esprit peut nous fermer aux nouvelles idées et nous empêcher de reconnaître nos erreurs ou d'apprécier les contributions d'autrui. Favorisons une culture du dialogue, de l'innovation et du respect mutuel, des valeurs essentielles pour une collaboration productive et enrichissante.
### Conclusion
Ces années passées dans le conseil m'ont enseigné que chaque expérience, aussi éphémère soit-elle, est une occasion de rencontrer des nouvelles personnes, d'apprendre, de grandir et de laisser une trace positive. Dans le conseil, chaque projet est une aventure, chaque défi une leçon, et chaque interaction, une chance d'enrichir et d'être enrichi.
---
### 3 enseignements à connaître avant de créer son équipe data
Source : https://www.hymaia.com/blog/3-enseignements-a-connaitre-avant-de-creer-son-equipe-data/
3 leçons clés avant de construire votre équipe Data, tirées de 5 ans d’expérience terrain.
# Un peu de contexte

Devant le faible nombre de ressources disponibles sur le sujet à cette époque, l’intuition était souvent le recours principal à l’heure de faire des choix.
Encore aujourd’hui, il est difficile de trouver des informations fiables, exemptes de toute influence économique directe.
Tapez simplement "_Should we centralize or decentralize our data teams ?_" dans votre navigateur. Pour notre part, il faut chercher jusqu’au 7° lien pour trouver un article qui ne soit pas directement lié à un éditeur de logiciel. Et en cliquant sur ce lien, on se rend compte que l’auteur n’est autre que le CEO d’un acteur majeur de la documentation. Le premier article indépendant n'apparaît donc pour nous qu'à la deuxième page des résultats. Et c’est aussi le cas pour une question plus large comme : “_How to build a data team from scratch_”.
C'est pourquoi nous avons décidé avec Christelle de prendre du recul et de partager avec des astuces qu’elle aurait aimé connaître plus tôt.
Pour ce faire, nous n’allons pas simplement nous appuyer sur notre seule expérience de ces problématiques. Nous sommes forcément biaisés.
Afin de viser une plus grande exhaustivité et neutralité, nous avons réalisé une enquête auprès du **Modern Data Network**, une communauté de data leaders & experts français, qui a rassemblé les réponses de 52 entreprises différentes principalement issues de la tech française avec des effectifs inférieurs à 1000 personnes pour des équipes data de tailles moyennes (de 1 à 200 collaborateurs).
Forts de cette donnée collectée, nous avons pu dégager 3 principales leçons pour te guider dans tes futurs choix.
## Leçon #1 : Choix d’équipe et choix de stack sont fortement liés
Nous souhaiterions tous que la stack technique, et donc l’équipe qui va avec, découle directement des besoins business et que tout soit parfaitement aligné. La réalité est souvent bien différente avec des existants et des contraintes supplémentaires qu’il faut savoir gérer.
Ce dont il faut être conscient, c’est qu’il existe une forte interdépendance entre la manière dont on constitue son équipe et la stack technique sous-jacente.

A ce moment, Christelle a touché du doigt son premier enseignement :

Illustrons cette relation d’interdépendance en nous concentrant sur le lien entre la structuration de son équipe et le choix d’acheter sa stack ou de la construire en interne (_le Build vs Buy_).
### Le dilemme du _Build VS Buy_ est fortement dicté par le choix du profil dirigeant l’équipe data
Reprenons notre sondage. Parmi les équipes sondées, plus de la moitié (57%) sont dirigées par des personnes ayant un profil technique. Et ce choix a un impact fort sur la propension à construire ses propres outils en interne plutôt que d’acheter des solutions sur étagère.

### Plus on achète d’outils, moins on a besoin de recruter : Oui et Non !
Il est classiquement admis que plus on “_buy_”, moins on a besoin d’embaucher de collaborateurs dans une équipe. On pourrait alors se dire que les équipes plus orientées business sont moins pléthoriques. Mais la réalité est plus complexe.

Cela peut s’expliquer par le fait que les petites équipes n'ont pas le budget nécessaire pour investir dans des solutions externes coûteuses ou pour gérer une multiplicité de partenaires, tandis que les grandes équipes disposent des ressources nécessaires pour créer des outils de très bonne qualité sur mesure en interne à moindre frais et plus adaptés à leurs besoins.
### Il est plus difficile de décentraliser une équipe data lorsque l’on choisit de _build_ majoritairement
En effet, maintenir à coût économique acceptable un panel d'outils internes à la fois _user friendly_ et adapté à des profils orientés business délocalisés dans les entités métiers peut être un challenge perdu d’avance.

Décentraliser peut a fortiori engendrer des coûts IT plus élevés, liés à un potentiel besoin grandissant du nombre de licences de certains outils.
Tous ces éléments sont donc à méditer au moment de choisir sa stratégie _Build vs Buy_, et son équipe. Sans oublier les notions de coûts associés.
## Leçon #2 : Une réorganisation, c’est surtout un coût humain
Au cours des années 2010, l'idée même d'une équipe data pouvait sembler surprenante dans les entreprises où les données n'étaient pas au cœur du produit.
Lorsque la data est devenue une priorité, la centralisation s'est imposée comme moyen de développer des équipes techniquement compétentes, capables de mener des projets et d'obtenir rapidement des résultats.
Aujourd'hui, la tendance est plutôt à une décentralisation, mais pas de manière isolée comme auparavant. Il s'agit plutôt de petites équipes indépendantes et pluridisciplinaires, avec un centre de compétences chargé d'assurer l'harmonisation de la qualité et des processus entre les équipes. Le bien nommé “**_Data Mesh_**“.

_NB : Si vous souhaitez en savoir plus sur le sujet, voici un_ [_article qui vous en dit plus sur l’implémentation du Data Mesh chez Blablacar_](https://www.hymaia.com/blog/data-mesh-blablacar) _!_
Cela signifie-t-il qu'il faut se précipiter pour réorganiser afin de suivre la tendance du moment et gagner en maturité et en efficacité ? Pas si sûr !
### Ne jamais négliger le coût humain d’une réorganisation
Soyons clairs, la réorganisation est un processus naturel qui se produit constamment dans toutes les entreprises.
Cependant, cela représente un risque important sur le plan humain, et étant donné que la stack et l'équipe sont interdépendantes, une réorganisation peut être plus difficile à mettre en œuvre.
Il est donc important de prendre son temps et de s'assurer que la structure cible corresponde aux besoins de l’entreprise et à la structure historique de l'équipe. En d’autres termes : un changement d’organisation doit répondre à une problématique claire.
### Modèle hybride ou décentralisé ?
A partir d'une taille critique de 15 personnes, deux choix sont possibles : un modèle hybride ou un modèle décentralisé.

En revanche, s'il y a de nombreux clients internes diversifiés et moins structurés, il sera très difficile de délocaliser des équipes pluridisciplinaires dans chacun des domaines sans surcharger en effectifs et sans retomber dans les travers de la décentralisation des années 2010.
Finalement, si l'on opte pour un modèle décentralisé, il est très important de maintenir un partage de connaissances solide et des liens forts pour éviter que les équipes ne se sentent isolées.
## Leçon #3 : Pour faire grandir son équipe, le recrutement n’est qu’une facette d’une plus grande équation
Construire son équipe, c'est avant tout une question humaine.
Christelle nous raconte son vécu sur ce point :

Ce challenge se pose effectivement dans tous les domaines, mais il est encore plus prégnant dans un domaine aussi compétitif et techniquement pointu que la data, où certaines entreprises peuvent se permettre d'offrir des salaires hors normes.
De plus, lorsqu'on embauche des jeunes diplômés dans des structures de petite taille qui n'ont pas encore une solide infrastructure RH en place, le manager doit réfléchir à la manière de former et de faire évoluer ses collaborateurs.
Un des premiers défis qui va se poser lorsque l’on cherche à faire grandir son équipe, c’est de la spécialiser. Quelques chiffres du sondage montrent bien ce challenge :

La manière de vous y prendre pourra aller de la réembauche et du changement de toute l’équipe à l’accompagnement des personnes pour les faire évoluer sur un chemin ou un autre.
Pour y parvenir, cela passe avant tout par l'explication claire aux collaborateurs de ce que l’entreprise attend d'eux, et cela peut se faire à travers deux éléments fondamentaux.
### Proposer régulièrement à chacun des objectifs clairs, mesurables en termes de temps et de qualité.
Ces objectifs peuvent porter aussi bien sur la feuille de route du produit que sur le développement personnel.
Bien que simple, cela donne une direction à suivre et une source de motivation.
Cela permet d’inscrire la personne dans quelque chose de plus grand qu’elle et qui lui donne du sens, tout en lui donnant les moyens de se développer pour y parvenir.
Cela ressort clairement dans les entretiens libres du sondage :

### Mettre en place un cadre clair de compétences attendues à chaque niveau de séniorité.
La fameuse grille de compétences. Bien qu’efficace, elle peut être à double tranchant.
Tout d'abord, si les éléments constitutifs de ce cadre sont trop vagues ou peu clairs, cela peut créer de la frustration et les collaborateurs pourraient l'interpréter comme un moyen de leur refuser des promotions en utilisant un cadre d'excuses formelles.
Deuxièmement, si le cadre indique clairement qu'un collaborateur mérite une promotion et que celle-ci ne se concrétise pas, cela pourrait précipiter son départ.
Élaborer un bon cadre de compétences n’est pas chose aisée. Il est important d'y inclure à la fois des éléments techniques et des compétences comportementales.
Par exemple, même si l'ambition est de devenir un expert technique, il est important de développer ses compétences pédagogiques et de communication, car on s'attend à ce qu'une personne très expérimentée soit à la fois une référence technique pour l'équipe mais aussi le principal formateur des nouveaux arrivants.
De plus, il est important de distinguer l'impact d'un collaborateur à travers la réalisation de ses objectifs de l'excellence opérationnelle, afin de mettre en évidence le compromis entre qualité et quantité, et d’éviter d’inciter ses collaborateurs à faire vite et mal sans s’en rendre compte.
En conclusion, c’est un moyen d’accompagner son équipe historique dans les changements qui l’attendent et de s’assurer que quand l’équipe grandit, le collaborateur grandit avec elle. C’est d’ailleurs un élément clé mis en avant dans le [Projet Oxygen de Google](https://rework.withgoogle.com/blog/the-evolution-of-project-oxygen/) qui vise à énumérer les principales caractéristiques des meilleurs managers chez eux, le 6ème étant “Supports career development and discusses performance”.
Et c’est d’autant plus important si l’on réfléchit aux restructurations et aux motivations qui l’accompagnent :

## Conclusion : La data, c’est de l’humain
Ce qui ressort de ces trois leçons, c’est que la dimension humaine est prépondérante dans tous les challenges quotidiens d’un Head of Data.
Sortant souvent d’une formation d’ingénieur, notre biais récurrent est de tout voir comme un problème technique auquel apporter une solution technique.
Sauf que la réalité est toute autre. Même la solution technique est fortement conditionnée par le choix des personnes de son équipe.
**Il y a une interdépendance totale entre les membres de l’équipe et les choix techniques et organisationnels que l’on est amenés à faire.**
Le comprendre au plus tôt dans le dimensionnement de votre équipe et de votre stack vous aidera à éviter de tomber dans des pièges très fréquents.
A vous de jouer !
---
### 8 défis pour l’inférence locale de LLMs sur mobile
Source : https://www.hymaia.com/blog/8-defis-pour-linference-locale-de-llms-sur-mobile/
Faire tourner des LLM sur mobile : 8 défis à surmonter avant d'y arriver.
L'une des tendances les plus intéressantes en ce moment est l'inférence locale des LLM, et plus particulièrement sur mobile.
L'inférence locale offre de nombreux avantages pour l'IA et l'IA générative en particulier, principalement en termes de consommation de ressources distribuées, de confidentialité et d'utilisation hors ligne. Pourtant, il est clair que nous en sommes encore aux tout premiers jours, et de nombreux obstacles sont à surmonter avant que cela devienne une option complètement viable.
Cependant, le domaine de l'IA générative évoluant à grande vitesse, cette approche - surtout dans une vision où les agents intelligents joueront un rôle central - pourrait rapidement devenir un élément technologique clé.
Aujourd'hui, nous allons examiner les principaux obstacles que les développeurs, les chercheurs et les entreprises sont susceptibles de rencontrer lorsqu'ils apportent l'inférence de LLM sur les appareils mobiles. Nous en avons recensé 8, dans lesquels nous allons plonger sans plus tarder.
## 1\. **Le défi de la fragmentation**
En 2025, créer des applications mobiles signifie toujours supporter les deux écosystèmes dominants : Android et iOS. Chaque plateforme a ses particularités, et les solutions qui fonctionnent bien sur l'une peuvent échouer sur l'autre.
Même au sein d’un même système, les différences de puces et d’architectures matérielles peuvent poser des défis. Par exemple, sur Android, la diversité des fabricants entraîne des écarts dans les caractéristiques des processeurs des devices
Comme pour le développement mobile traditionnel, assurer la cohérence sur l’intégralité des systèmes nécessite des efforts et des tests supplémentaires, notamment lors du portage de modèles ou de leur adaptation pour des outils spécifiques à chaque plateforme.
De plus, tous les frameworks d'inférence ne sont pas compatibles avec Android et iOS à la fois. Les plus rapides, comme [MLX](https://github.com/ml-explore/mlx), sont spécifiquement conçus pour les puces Apple Silicon et pour tirer parti de ces avantages. Votre modèle pourrait avoir besoin d'être _porté_, introduisant des divergences potentielles dans le comportement ou les performances. Les ingénieurs devront donc constamment valider la compatibilité et les performances pour éviter ces écueils.
## 2\. Le compromis entre qualité, rapidité et taille du modèle
Les facteurs techniques comme la vitesse d’inférence, la taille du modèle et l'empreinte mémoire sont cruciaux pour une UX satisfaisante et, _in fine_, pour l'adoption. Ne pas fournir un modèle rapide, forcer les utilisateurs à attendre de longues minutes pendant le téléchargement de gigaoctets de poids, ou faire planter votre application conduira à une expérience inutilisable.
Réaliser un modèle de taille réduite, et donc plus rapide et léger, passe souvent par la compression de modèles de plus grande taille, à travers de techniques telles que la [quantisation](https://huggingface.co/docs/optimum/concept_guides/quantization), le [pruning](https://en.wikipedia.org/wiki/Pruning_\(artificial_neural_network\)) ou la [distillatio](https://en.wikipedia.org/wiki/Knowledge_distillation)n. Cependant, bien que la recherche évolue à grande vitesse, ces techniques de compression peuvent en revanche réduire la qualité et la précision de l’inférence.
De plus, à mesure qu'ils prennent confiance avec les services de ChatBot LLM, vos clients s'attendront probablement à ce que votre service supporte une longue fenêtre de contexte, ce qui requiert des techniques avancées de compression et de gestion de la mémoire, car les contraintes de mémoire imposent des fenêtres de contexte limitées à environ 8k tokens.
Il est en tout cas essentiel de peser chaque compromis par rapport à votre cas d'utilisation pour trouver le bon équilibre entre la qualité de la sortie et l'expérience utilisateur. Ce ne sera pas la plus simple des taches.
## 3\. **APIs système limitées, voire inexistantes**
Construire votre propre solution est actuellement la seule option viable, car les SDK des systèmes d'exploitation manquent d'APIs _first-party_ pour utiliser les modèles fondamentaux installés avec le système d'exploitation lui-même.
Par exemple, sur iOS, Apple Intelligence offre des fonctionnalités d'IA limitées pour votre application : le supporter via App Intents contribuera à améliorer l'intelligence globale du système d'exploitation - ce qui est bien, mais cela ne répondra probablement pas à vos besoins en termes de fonctionnalités.
## 4\. Choisir le bon moteur d'inférence
Choisir le bon moteur d'inférence est une décision structurelle. En revanche, comme le domaine est encore relativement nouveau, aucun moteur d'inférence aujourd'hui ne garantit une base de développeurs robuste et un retour d'information suffisant pour construire confortablement votre produit.
Certains moteurs, comme [PyTorch ExecuTorch](https://pytorch.org/executorch-overview), sont multiplateformes, tandis que d'autres, comme MLX, ne le sont pas, mais garantissent en revanche une exécution plus rapide sur les puces Apple. De plus, les modèles sont rarement mis à disposition pour tous les moteurs et le portage de modèles d'un moteur à un autre peut entraîner des différences de comportement.
## 5\. **Observabilité et contrôle**
L'inférence locale limite la capacité des développeurs à surveiller les modèles en temps réel. Contrairement à l'inférence sur serveur, qui bénéficie de bibliothèques d'observabilité éprouvées comme LangSmith, l'inférence locale propose peu d'outils prêts à l'emploi, obligeant souvent les développeurs à créer leurs propres solutions.
Le manque d'observabilité pose un risque significatif pour votre produit et vos utilisateurs, car les LLM peuvent halluciner / confabuler sans que vous en soyez conscient.
## 6\. **Protection de la propriété Intellectuelle**
Une fois un modèle déployé localement, sa protection devient une tâche complexe. Bien que des solutions comme le chiffrement des poids ou l'obfuscation du code d'inférence puissent être envisagées, ces méthodes sont encore sous-explorées.
En l'absence de protections adéquates, les concurrents peuvent analyser et reproduire votre modèle, ce qui réduit considérablement votre avantage concurrentiel. Ce risque est particulièrement important dans un environnement où l'innovation et la propriété intellectuelle sont des atouts cruciaux.
## 7\. **Sécurité et garde-fous**
L'inférence sur serveur bénéficie de _guardrails_, des mécanismes basés sur des modèles de langage qui analysent en temps réel les entrées et sorties d'un LLM pour détecter d'éventuelles informations sensibles, telles que des contenus dangereux pour l'utilisateur ou des données personnelles.
Dans un contexte local, leur mise en place est possible mais plus complexe, car elle nécessite l'exécution de modèles supplémentaires dans un contexte déjà contraint en ressources. Cela engendrerait donc des impacts négatifs sur la mémoire et la latence, posant ainsi un dilemme délicat entre performance et sécurité.
## 8\. Outils
LangChain, bases de données vectorielles, LlamaIndex : l'inférence côté serveur dispose d'une large gamme d'outils pour construire des solutions complexes de manière relativement facile. Certains de ces outils existent dans une version compatible mobile (il y a aussi un LangChain.swift - dernier commit il y a 8 mois) mais ils manquent du support nécessaire pour en faire des options vraiment robustes. Construire vos propres outils, d'un autre côté, est ambitieux, pour le moins.
Malgré les défis, réaliser l'inférence locale de LLM est loin d'être infaisable. [PrivateLLM](https://privatellm.app/en), une application tierce disponible sur l'App Store, démontre que des résultats impressionnants peuvent être obtenus avec de petits modèles de 1B dont les poids ne dépassent pas 500MB avec le moteur d’inférence [MLC LLM](https://llm.mlc.ai). La vitesse est impressionnante et la qualité, bien qu'imparfaite, est plus que suffisante pour des raisonnements basiques, des résumés et des interactions textuelles.
Il va sans dire, comme mentionné dans l'introduction, que le domaine évolue rapidement, et nous pouvons nous attendre à ce que ces défis soient abordés un par un dans les mois à venir.
Même ainsi - ou peut-être pour cette raison même - ce domaine est incroyablement excitant et captivant comme peu d'autres technologies récentes.
**Pour aller plus loin, nous vous recommandons :**
- [Awesome LLMs on Device](https://github.com/NexaAI/Awesome-LLMs-on-device), précieux catalogue de papiers de recherche, modèles et moteurs d’inférence _on Device_
- [Introduction to On-Device AI](https://www.deeplearning.ai/short-courses/introduction-to-on-device-ai/) par Deep Learning AI, une ressource pour découvrir les bases de l’IA embarquée, bien que pas spécifique aux LLMs.
- Notre livre [LLM & IA Générative - La voie de la raison](https://www.hymaia.com/blog/llm-ia-generative-la-voie-de-la-raison), qui aborde certains parmi les sujets de cet article
- [**Un café avec nous !**](https://www.hymaia.com/pages-contact/contact) Pour discuter, échanger sur vos projets ou explorer ensemble des formations adaptées à vos besoins.
---
### À la découverte de Azure OpenAI
Source : https://www.hymaia.com/blog/a-la-decouverte-de-azure-openai/
Azure OpenAI décrypté : la première offre cloud intégrant des services clé en main de GenAI.
Comme son nom l’indique, Azure OpenAI se base sur les services d’**OpenAI**, la société américaine célèbre pour le lancement de **ChatGPT**.
Nous allons découvrir comment cette collaboration permet aujourd’hui de créer un produit personnalisé basé sur le LLM (**Large Language Model**) le plus connu de ce début d’année.
## Avant de commencer : un peu d’historique
L'histoire de la collaboration entre Microsoft et OpenAI remonte à plusieurs années, lorsque Microsoft a investi massivement dans OpenAI.
En 2019, Microsoft investissait déjà un milliard de dollars dans la société tandis qu’en 2020, ils faisaient l’acquisition d’une licence exclusive pour l'utilisation de GPT-3, le modèle de langage développé par OpenAI. En janvier 2023, Microsoft a franchi une étape majeure en investissant 10 milliards de dollars supplémentaires en échange contre 75% des profits futurs d'OpenAI et obtenant une participation de 49% dans la société.
Au même moment Microsoft a commencé à intégrer les solutions d'OpenAI, notamment le modèle GPT-3.5, dans son offre B2C (le moteur de recherche Bing) et Cloud (Azure).
### Vue d'ensemble d'Azure OpenAI
La nouvelle offre Azure OpenAI est une extension de la gamme de services d'intelligence artificielle proposés par Azure, qui incluait déjà d’autres solutions d’IA, telles que Speech Studio, Language Studio, Vision Studio, et bien d’autres.
Le récent ajout d'OpenAI permet aux clients de construire de solutions personnalisées basées sur les modèles GPT-3.5 et GPT-4 en fournissant deux fonctionnalités essentielles :
- Fine-Tuning d’un modèle ;
- Bring Your Own Data (en Preview) : ajout d’une source de données personnalisée à partir de fichiers textuels.
En plus des API REST traditionnelles, Azure propose également un SDK Python ainsi qu'une interface Web orientée no-code. L'objectif déclaré d'Azure OpenAI Service est de rendre la mise en service d’une solution d'IA Générative accessible à tout type de profil, y compris des personnes n’ayant jamais programmé auparavant.
### Fine Tuning ou Bring Your Own Data
Azure OpenAI offre deux services principaux pour la création d'un chat personnalisé, à savoir :
1. **Fine-tuning** : un processus qui permet d'adapter un modèle existant à de nouveaux cas d’utilisation ou l’ajout de fonctionnalité qui n’était pas initialement présente dans le modèle. Par exemple, le Fine Tuning peut être nécessaire pour la compréhension d’un vocabulaire avancé, pour la prise en charge d’un nouveau langage de programmation ou pour opérer de l’analyse de données dans de contextes inconnus par le modèle original.
2. **Bring Your Own Data** : afin d’augmenter la base de connaissance du modèle avec des données spécifiques à une entreprise ou à un nouveau une case mais utilisant un vocabulaire pour la plupart générique. Ceci peut par exemple être utile lors de la création d’un “ChatGPT” fournissant des informations internes à l’entreprise ou pour créer un moteur de recherche personnalisé pour vos utilisateurs.
## Concepts Principaux
Pour créer un service personnalisé basé sur OpenAI, plusieurs éléments sont nécessaires.
Voici les principaux building blocks :
1. **Deployment** : Dans le contexte d'Azure OpenAI Service, le déploiement fait référence à l'environnement dans lequel le service est hébergé. Il permet de gérer différentes versions de modèles et de déployer des _endpoints_ pour le service.
2. **Model** : Le modèle est au cœur du service. Pour les versions personnalisées basées sur OpenAI, au moment de la rédaction de cet article (juillet 2023) il est possible d’utiliser des modèles tels que gpt-35-turbo 0613 (GPT Turbo 3.5 de juin); gpt-35-turbo 0301 (GPT Turbo 3.5 de mars); gpt-35-turbo-16k 0613 (GPT Turbo 3.5 avec support de 16k tokens de juin) et gpt-4 (sur demande).Bien évidemment, chaque modèle a ses spécificités et peut avoir un impact sur le pricing et le comportement du service.
3. **Cognitive Search** : La solution Azure Cognitive Search fait référence à une base de données comparable à Elasticsearch qui servira de base de connaissances pour le modèle. Ces données sont stockées séparément du modèle lui-même et ne dépendent pas de la version du modèle utilisé. Cela permet de conserver la base de connaissances même en cas de changement de modèle.
4. **Blob Storage** : Pour créer et entraîner le modèle personnalisé, il est nécessaire de disposer d'un système de stockage pour les données brutes. Via _Blob Storage_, que l’on peut considérer comme étant l’équivalent de AWS S3, Azure offre des solutions de stockage adaptées à ces besoins, permettant de traiter, analyser et utiliser les données pour l'entraînement et le développement du modèle.
Il est important de noter qu’au moment de l’écriture de cet article, le déploiement d'un service personnalisé basé sur OpenAI nécessite une demande d'accès spécifique auprès d'Azure. Dans notre expérience, la réponse (positive) est arrivée dans les heures suivantes l’émission de la demande. Une fois l'accès accordé, il sera bien évidemment possible de commencer à utiliser les fonctionnalités d'OpenAI Studio et d'exploiter les avantages des modèles et des outils mis à disposition.
### Fine Tuning
Afin d’opérer du Fine Tuning, l’étape principale sera de préparer des datasets d'entraînement (training) et de validation pour affiner les modèles. Ces ensembles de données vous permettent de spécifier des exemples supplémentaires qui aideront le modèle à mieux comprendre le domaine d'application. Ainsi, il est recommandé d'avoir des centaines voire des milliers d'exemples pour obtenir des résultats pertinents.
Dans Azure OpenAI, le processus d'ajout des datasets peut passer par la console Web ou par l’API. Une fois les ensembles de données ajoutés, il sera possible de lancer des tâches de fine-tuning. Le résultat de cette opération sera un _fine-tune-results_ qui pourra être utilisé comme modèle de votre Chat personnalisé.
### Bring Your Own Data
En ce qui concerne **Bring Your Own Data**, la fonctionnalité est similaire à celle exposée par le plugin OpenAI "_Retrieval Plugin_", sauf qu’elle se retrouve ici pré-configurée avec les autres services Azure, et notamment _Cognitive Search_ et _Blob Storage_.
Concernant Azure Cognitive Search, il a été adapté pour prendre en charge les cas d'utilisation de recherche par vecteur, grace à une mise à jour récente.
#### Pour rappel, la recherche par vecteurs est nécessaire à la réalisation de recherche « _nearest neighbor_ » et qui est à la base de l’indexation des tokens dans un LLM. Autrement dit, lorsqu'un utilisateur effectue une recherche, le texte est transformé en vecteurs et comparé à la base documentaire également représentée par des vecteurs correspondants. Cette approche permet de trouver des corrélations et des résultats pertinents.

Le sourcing des données dans “_Bring Your Own Data_” est actuellement possible de trois manières :
1. **Manuelle**, à partir d'une instance Cognitive Search préexistante ;
2. **Semi-automatique**, en indexant le contenu d'un conteneur _Blob Storage_ qui sera ensuite déversé dans Cognitive Search ;
3. **Entièrement automatique**, en utilisant une interface d'upload de fichier qui s'affichera directement dans la console Azure OpenAI.
Dans les modalités 2 et 3, les formats supportés sont actuellement .txt, .md, .html, .pdf, .docx et .pptx avec une limite de 16Mo par fichier.
## Démo
Puisque une séquence d’images vaut plus qu’un article entier, nous vous proposons une courte démo réalisée pour montrer la création d’un chat basé sur _Bring Your Own Data_ avec Azure OpenAI.
## Notre retour d’expérience
Dans notre démo, nous avons ajouté une base documentaire personnalisée à Azure OpenAI, composée d'articles et de podcasts issus des publications d'Hymaïa.
Dans notre démo il est possible de voir un résultat de recherche plutôt pertinent, qui suit les instructions (mise en forme en bullet points) et garde le contexte en occasion de la question « tu peux m’en dire plus sur le dernier point ? ». Aussi, il est important de le rappeler, l’échange s’est déroulé entièrement en langue française.
Dans la suite de nos expérimentations (hors démo) tout n’est pas parfait cependant. Par exemple, en réponse à des questions telles que "Qui est François ?" ou "Qui est Aramis Auto ?", l'IA a effectivement fourni des réponses basées sur les informations de la base documentaire, mais certaines d’entre elles n'étaient pas tout à fait exactes en raison d'une compréhension limitée des textes.
De plus, lorsqu'on lui a demandé de répondre de manière humoristique, la précision concernant le ton de la réponse a semblé avoir été totalement ignorée.
Dans nos itérations, nous avons également remarqué que le découpage des paragraphes des textes source jouait un rôle important dans la compréhension du texte : lorsque les contenus présentaient de longs paragraphes (c'est-à-dire des blocs de textes séparés par des sauts de ligne), les informations qu’ils contenaient ne semblaient avoir été prises en considération. Cela semble être en accord avec les [limitations connues](https://www.linkedin.com/posts/philipp-schmid-a6a2bb196_are-vector-databases-here-to-stay-yes-activity-7085908435686285312-QVfB) concernant les LLM.
D’un point de vue de l’interface utilisateur et de l’expérience no-code, Azure OpenAI présente encore des hics assez répandus, notamment des ressources qui, dans nos tests, ne se créaient pas correctement ou des messages d’erreur indéchiffrables. Ceci est certainement dû à la jeunesse du service, dont la partie “_Bring Your Own Data_” est actuellement en “_Preview_”.
### Propriété et sécurité de la donnée
L’une des problématiques les plus à même de susciter de l’inquiétude, à juste titre, concernant le développement de services basées sur l’IA Générative est la propriété et la sécurité de la donnée. Autrement dit, qui est le propriétaire des informations utilisées pour fine-tuner un modèle ou étendre sa base de connaissance ? Et avec quels acteurs ces informations sont partagées ?
Côté Azure, la réponse est formulée dans l’article [**Data, privacy, and security for Azure OpenAI Service**](https://learn.microsoft.com/en-us/legal/cognitive-services/openai/data-privacy) de la Knowledge base d’Azure.
Deux éléments sont à considérer :
1. Par défaut, les services Azure OpenAI intègrent un service d’[Abuse Monitoring](https://learn.microsoft.com/en-us/azure/cognitive-services/openai/concepts/abuse-monitoring) dont le but est de “_détecter et atténuer les instances de contenu récurrent et/ou de comportements suggérant une utilisation du service d'une manière susceptible de violer le Code de conduite ou d'autres conditions applicables au produit_”. Le service de _Abuse Monitoring_ est appliqué par défaut à votre projet et une demande spécifique et motivée doit être soumise afin de le désactiver.
2. En revanche, les données de fine tuning ou “_Bring Your Own Data_” ne sont pas utilisées pour re-entrainer ou améliorer les modèles de base ou tiers. Également, aucun prompt ou aucune réponse n’est re-injectée dans le modèle - ce qui permettra d’éviter de fuite de données de votre organisation.
### Coûts
En ce qui concerne les coûts, cela dépend de 3 éléments de l’architecture de la solution : _Blob Storage_, _Cognitive Search_ et _Azure OpenAI_.
_Azure Cognitive Search_ est disponible à partir d’un minimum de 75 $ par mois pour une instance de 2 Go et 3 Search Units. Il est aussi important de noter que le plan gratuit n’est pas compatible avec la solution Azure OpenAI.
En ce qui concerne l'inférence des requêtes, le prix varie en fonction du nombre de tokens supportés. Pour la version gpt3.5, le tarif est de 0,002 $ pour 1000 tokens, tandis que pour les versions gpt4 8k et gpt4 32k, les tarifs sont respectivement de 0,06 $ et 0,12 $ pour 1000 tokens.
### Vers un paysage concurrentiel élargi
Azure OpenAI n'est plus le seul sur le marché de l’IA Générative. D'autres fournisseurs majeurs, tels que GCP et AWS proposent ou proposeront bientôt des solutions similaires. Les solutions de GCP se baseront notamment sur les LLM PaLM et PaLM 2, tandis qu'AWS, avec Bedrock, offrira des modèles tiers tels que Claude d'Anthropic et Jurassic-2 d'AI21.
Il est donc prévu que la concurrence s'intensifie dans ce domaine, offrant ainsi davantage de choix aux utilisateurs.
### Informations accessoires sur cet article
Cet article a été rédigé en partie grâce à un outillage composé par [MacWhisper de Jordi Bruin](https://goodsnooze.gumroad.com/l/macwhisper), basé sur _OpenWhisper_, utilisé pour convertir en format textuel une présentation interne issue de notre HymaDay de juin, et ChatGPT, dont nous nous sommes servis pour synthétiser le texte et améliorer la forme.
---
### Benchmark Apache Spark : Préparation du test TPC-DS
Source : https://www.hymaia.com/blog/benchmark-apache-spark-preparation-du-test-tpc-ds/
Benchmark Spark : Yarn vs Kubernetes. Préparation du test TPC-DS et choix du jeu de données.
_NB : Cet article a été co-écrit avec Romain Sagean, SRE chez Alma_
## Les données TPC-DS
Le [**Transaction Processing Performance Council**](https://fr.wikipedia.org/wiki/Transaction_Processing_Performance_Council) (TPC) est un organisme qui met à disposition des scénarios de benchmark standard. Cela permet de comparer tout ce que l’on veut via un référentiel commun.
Pour **Spark**, il est commun d’utiliser le jeu de données TPC-DS. Il a été conçu pour des benchmarks de traitement SQL. Il est donc idéal pour **Spark** et sa bibliothèque **Spark SQL**.
Plusieurs méthodes existent pour obtenir le jeu de données du benchmark TPC-DS dont de multiples projets open source. Les jeux de données sont également présents intégralement sur des stockages publics.
Il est également possible de choisir la taille du jeu de données que nous souhaitons utiliser. Cela peut aller de 1Go à 100To.
## Objectif du benchmark
La première question que nous nous sommes posés est : quel impact y a-t-il à choisir **Yarn** ou **Kubernetes** sur le temps de traitement d’un job **Spark** ?
À partir de là nous avons réfléchi à des objectifs plus précis pour un benchmark et nous en avons retenus 3 :
- Qui est le plus rapide / résilient pour un shuffle entre **Kubernetes** et **Hadoop** ?
- Qui est le plus performant pour la création et la maintenance de dizaines d’executeurs en parallèle ?
- Quel est l’impact d’un stockage décentralisé comme un **Object Storage** par rapport à **HDFS** dans un cluster **Hadoop** ?
## Préparer son jeu de données
Si nous voulons tester les différences entre deux exécutions à plusieurs dizaines d’executors, nous avons besoin de choisir un jeu de données assez volumineux. Notre première idée a été de nous lancer avec le plus gros volume possible de donnée : 100To.
Générer 100To de données est une tâche qui coûterait très cher en infrastructure et prendrait beaucoup de temps. C’est pourquoi nous avons choisi de récupérer la donnée venant d’un Bucket [S3 public d’AWS](https://s3.console.aws.amazon.com/s3/buckets/redshift-downloads?prefix=TPC-DS/®ion=us-east-1), dans lequel la donnée est disponible pour 3To, 10To, 30To ou 100To.
Nous avons choisi **Scaleway** comme Cloud Provider. Pour en savoir plus sur ce choix, je vous redirige vers notre article sur **les limites de l'Object Storage de Scaleway face à Spark qui est à paraitre prochainement**.
Le service managé Object Storage de **Scaleway** est compatible avec l'API S3 d’**AWS**. Cela signifie que nous pouvons nous en servir comme si c'était un bucket S3 d’**AWS** mais configuré sur une autre région avec d'autres credentials. Et pour cela **Scaleway** nous suggère un outil nommé [Rclone](https://www.scaleway.com/en/docs/tutorials/migrate-data-rclone/) qui permet de migrer facilement le contenu d’un Object Storage vers un autre, peu importe le Cloud Provider. Sa vraie plus-value dans notre cas est la façon dont Rclone va gérer nos credentials à notre place puisque nous devons nous authentifier à **AWS** et **Scaleway** en même temps. Pour accéder au bucket S3 public d'**AWS**, n'importe quel credential correspondant à un compte **AWS** suffit.
Une fois que nous avons suivi [le tutoriel de Scaleway pour configurer Rclone](https://www.scaleway.com/en/docs/tutorials/migrate-data-rclone/), il ne reste plus qu'à lancer notre commande de clonage :
`rclone copy --progress aws:redshift-downloads/TPC-DS/2.13/100TB/ scaleway:datalake-spark-benchmark/data/TPC/100TB`
## Bien choisir son volume de données
Quand nous avons lancé la commande la première fois, nous avons été surpris du débit de transfert de fichier entre les deux systèmes de stockage. Environ 6 mo/s en moyenne. À ce rythme là, pour 100To de données, nous y étions encore 1 an plus tard.
Il s’avère que Rclone utilise notre connexion internet pour transférer les données d'un bucket à un autre. Ce n'est pas grave, nous pouvons louer une VM GP1-XL de chez **Scaleway** qui offre 10 Gb/s de bande passante, ce qui devrait prendre 22 heures tout au plus pour les 100To. Pourtant, une fois lancé sur la GP1-XL de **Scaleway** nous plafonnons à 100 mo/s.
Le problème, c’est qu’un stockage objet comme S3 et celui de **Scaleway** ont un coût en temps non fractionnable lorsque l'on souhaite écrire un fichier. Que celui-ci fasse 1mo ou 100Go, il y a toujours un temps de synchronisation entre chaque écriture de fichier. Dans notre cas, les différents fichiers du jeu de données fournis par **AWS** ont été découpés en morceaux de 128mo. Il y a donc des dizaines de milliers et que pour 1 seconde passée à copier un fichier, nous perdons quelques secondes à communiquer avec notre stockage objet et la vitesse moyenne affichée plafonne à 100 mo/s.
Nous avons donc à nouveau réfléchi à nos ambitions et nos objectifs pour notre benchmark. Nous savons que nous avons besoin d’un gros jeu de données, et par défaut nous voulions le plus gros. Mais est-ce vraiment nécessaire pour obtenir de bons résultats d’avoir 100To de données ? Si on y repense, cela prendrait énormément de temps même avec des centaines d’executors de traiter autant de données. De plus nous avons estimé que quelques dizaines d’executors en parallèle nous suffisaient pour pouvoir répondre à nos questions.
C’est pourquoi nous avons finalement choisi de partir sur 10To de données pour le TPC-DS. Cela nous a pris une journée pour le télécharger avec une GP1-XL de **Scaleway**.
## Ce que nous retenons
Le **TPC** met à notre disposition des scénarios de benchmark. Celui qui nous intéresse pour **Spark** et tout traitement basé sur une logique SQL est le TPC-DS.
Nous avons choisi la taille de notre jeu de données en fonction des réponses que nous cherchons avec notre benchmark. 10To de données nous parait suffisant pour justifier de lancer des jobs **Spark** de plusieurs dizaines d’executors, et donc être capables de déterminer s'il y a un impact entre l'utilisation de **Yarn** ou **Kubernetes** lorsque l'on a besoin de beaucoup d'executors.
Nous aurions pu utiliser plus de données, mais il a également fallu être réaliste avec les moyens que nous avions à notre disposition. Nous avons estimé que l’apport sur les résultats n’aurait pas été à la hauteur des coûts mis en place pour traiter 100To de données.
Rclone nous a permis de cloner facilement toute la donnée mise à disposition par **AWS** vers notre Object Storage chez **Scaleway**. Il faut quand même faire attention parce que l'outil utilise notre bande passante pour transférer les données. C'est pourquoi nous avons loué une VM chez **Scaleway** pour cette tache.
La prochaine étape est de réussir à exécuter une requête du benchmark TPC-DS avec **Spark** sur la donnée que nous avons récupéré. Pour cela, il faudra attendre le prochain épisode.
---
### Le Data Business Model Canvas
Source : https://www.hymaia.com/blog/data-business-model-canvas/
Un canvas pour cadrer vos projets Data : la règle des 3U (Utile, Utilisable, Utilisé).
Le Data Business Model Canvas proposé est un outil inspiré de Business Model Canvas de [Alex Osterwalder](https://www.alexosterwalder.com/), adapté aux besoins des projets Data en se basant sur nos expériences. Ci-dessous, vous trouverez un **template** téléchargeable ainsi qu’une **liste de questions** plus détaillées pour chaque composant afin de vous guider dans son remplissage. La liste n’est pas exhaustive, n’hésitez pas à ajouter vos propres questions (et à nous les partager !).
Le Data Business Model Canvas est conçu pour être utilisé dès la phase d'idéation. Si on le remplit en une fois, il y a de fortes chances qu’il devienne obsolète, ce qui peut provoquer des divergences entre les utilisateurs et les développeurs. Il est important de le **partager** avec tous les acteurs et **mettre à jour régulièrement**, dès que les nouvelles informations sont mises à disposition. Il peut être construit au fur à mesure, en commençant par les premières cases.
**Téléchargez le guide et le template du Data Business Model Canvas** [**ici.**](https://eu1.hubs.ly/H01q7160)
## Liste de questions
### Problème
Quel problème rencontrez-vous ?
Quelle est la root cause de votre problématique ?
Si ce problème était résolu, qu'est ce que ça changerait dans la vie de l'utilisateur ?
### Valeur & Rendement
Quelle est la valeur attendue ?
Qu’est-ce que le projet pourrait apporter à votre entreprise ?
Comment mesurer son apport de valeur ?
Quel est le retour sur l’investissement espéré ?
### Existant
Comment répondez-vous à cette problématique aujourd'hui ?
Qu'est-ce qu'il manque ?
### Risques
Quelles sont les contraintes identifiées avant le démarrage ?
Quels sont les risques ?
Y-a-t-il des risques liés à l’adoption ?
Y-a-t-il des risques d’accès aux données ?
Peut-on anticiper certains risques ?
### Utilisateurs
Qui sont les potentiels utilisateurs ?
Comment utiliseront-ils vos résultats ?
Qui sont les points de contact ?
Comment collaborer entre l’équipe Data et les utilisateurs ?
### Données
De quelle donnée avons-nous besoin ?
Quelles sont les données nécessaires ? Externes et internes ?
Quelle est leur qualité ? Est-ce qu’elles ont été deja utilisées / validées ?
Quelle est leur disponibilité ?
Quelle est leur horizon temporel ?
### Mesures d’évaluation
Comment valider que les résultats apportent de la valeur ?
Quelles sont les métriques Business ? Techniques ?
### Livrable attendu
Quelle est la version minimale acceptable ?
Quelles sont les décisions que l’outil va aider à prendre ?
Quel est le niveau d’interprétabilité attendu ?
Comment le résultat sera utilisé pour prendre les décisions ?
Doit-il être intégré à un outil existant ou est-ce un outil à part entière ?
Quelle forme doivent prendre les résultats pour qu’ils soient actionnables sans difficulté ?
Bon cadrage et merci d’avance pour vos feedbacks !
---
### Data Literacy - 4 actions pour démocratiser la Data
Source : https://www.hymaia.com/blog/data-literacy-4-actions-pour-commencer-a-democratiser-la-data-au-sein-de-votre-entreprise/
Data Literacy : 4 actions concrètes pour démocratiser la Data dans votre entreprise.
Par conséquent, pour assurer la gouvernance de la donnée sans avoir à augmenter le nombre des profils Data, il est nécessaire de former ses équipes et d’être capable de parler le même langage entre les profils techniques et non techniques.
C’est là où nous avons besoin de la **Data Literacy**.
## La D**ata Literacy, c’est quoi ?**
La Data Literacy (_la littératie de données ou la culture des données en français_) désigne la **capacité à identifier, collecter, traiter, analyser et interpréter les données afin de pouvoir prendre les décisions en se basant dessus.**
S’il est clair qu’aujourd’hui la majorité des entreprises sont dotées de moyens pour collecter et exploiter la donnée, force est de constater que l’accès à cette donnée est souvent limité, et que son utilisation peut faire peur à un grand nombre de collaborateurs peu initiés à la Data.
Par où commencer pour démocratiser la Data au sein de votre entreprise ?
## Data Literacy, par où commencer ?
Passons en revue 4 actions afin de franchir un cap dans la démocratisation de la Data dans l’entreprise via la Data Literacy.
### Action #1 - S’aligner sur un vocabulaire commun
Quand les équipes parlent un langage totalement différent, cela a bien évidemment des conséquences négatives sur l’appropriation de la Data à plus grande échelle dans l’entreprise et sur la réussite de nombreux Produits Data. À titre d’exemple, il n’est pas rare que deux départements d’une même entreprise n’aient pas la même définition de ce qu’est un “client actif” ou une “transaction”.
Il apparaît donc nécessaire d’aligner au plus tôt chaque acteur touchant de près ou de loin aux problématiques Data sur le vocabulaire et les rôles qui y sont associés. Quelques exemples pour y parvenir :
- Créer un **lexique partagé** pour s’assurer que tout le monde ait la même définition ;
- Faire des interviews des différentes directions métier afin d’assurer l’homogénéité dans la définition d’un “client” ou d’un “utilisateur” ;
- Mettre en place des ateliers de clarification et d’alignement sur les rôles, compétences et responsabilités des différents profils data (du Data Engineer au Data Analyst, en passant par le Product Manager Data).
### Action #2 - Mettre en place des sessions de Vis-ma-vie
Parler le même langage ne veut pas dire parler “tech”, bien au contraire. Il est certes nécessaire de comprendre les concepts de la Data, mais il n’est pas moins important d’avoir une sensibilité sur les enjeux business et les problèmes que les équipes opérationnelles peuvent rencontrer.
Un des moyens pour y parvenir est le concept de **vis-ma-vie** dans l’entreprise. Il s’agit d’une ou plusieurs journées passées dans un autre département de l’entreprise pour comprendre le quotidien, les responsabilités et les enjeux d’un collègue. Cela permet de découvrir le métier d’un autre, mieux comprendre ses besoins et par conséquent de collaborer de manière plus efficace.
### Action #3 - Former vos collaborateurs
Que ce soit à travers de formations externes\* ou internes, il est important d’organiser des sessions de partage pour parler des principaux concepts de la Data sans oublier la prise en main des outils de l’entreprise.
L’objectif n’est pas de reprendre ses études pour devenir Data Engineer, mais d’avoir des premiers outils pour comprendre les enjeux et répondre aux questions suivantes :
- C’est quoi la Data ?
- Quelle Data peut-on collecter ?
- Comment y accéder ?
- Comment l’analyser ?
- Comment fiabiliser ? Et interpréter ?
Cette démarche de formation et d’acculturation Data peut se mettre en place de plusieurs manières :
#### Niveau 1 : À destination de l’ensemble des collaborateurs de l’entreprise, comex inclus
Ce premier niveau a pour objectif la démocratisation et la démystification de la Data, afin de créer un alignement et une sensibilité de chaque personne à ses enjeux, et ainsi réduire la barrière mentale que l’on peut se mettre lorsque les mots “data” ou “IA” sont prononcés.
Cela pourra prendre la forme de webinars ou de workshops courts.
#### Niveau 2 : A destination des “Business Users”
Ce deuxième niveau a pour objectif que chaque personne puisse être capable de prendre des décisions informées par la donnée, en utilisant les bons outils et en ayant les bons réflexes méthodologiques et techniques.
Pour atteindre cet objectif, des sessions de formation plus intensives, sur quelques jours, peuvent s’avérer nécessaires.
#### Niveau 3 : À destination des équipes expertes de la Data
Ce troisième niveau vise à former et à maintenir une veille constante des experts de la donnée sur les technologies et méthodologies qui sont dans leur champ de compétence.
Cela pourra prendre la forme de formations en interne comme en externe, mais aussi via la possibilité d’assister à des conférences spécialisées ou de mettre en place des temps dédiés de veille et de partage au sein des équipes.
### Action #4 - Mettre l’accent sur la communication
Mettre en place une communication régulière sur les avancements et les succès des initiatives Data est crucial afin de créer de l’engouement au sein de l’entreprise. Le manque de transparence entre les équipes favorise des silos que la communication permet de briser.
Créer une plateforme Data, développer des modèles de Machine Learning ou encore construire des dashboards - toutes ces activités des équipes Data sont au service de la mission de votre entreprise et non l’inverse. La communication entre les profils techniques et non tech est donc indispensable pour la réussite d’un projet dès la phase de cadrage.
Pour les premiers échanges, vous pouvez vous munir d’un outil comme le [Data Business Model Canvas](https://www.hymaia.com/blog/data-business-model-canvas) qui a pour but d’aligner les parties prenantes sur un nouveau Produit Data.
Quelques bonnes pratiques sont à garder en tête concernant la communication sur les avancées des initiatives Data :
- **Communiquer régulièrement** (toutes les une à deux semaines). Un piège est d’attendre trop longtemps entre chaque communication, ou d’attendre d’avoir terminé un Use Case avant de communiquer dessus.
- **Ne pas trop simplifier.** La vulgarisation est bien sûr importante pour ne pas noyer les lecteurs d’informations, mais nous vous mettons en garde contre les raccourcis trop grands qui peuvent faire penser à vos interlocuteurs que tout est simple et rapide à mettre en place, ce qui pourrait engendrer un nombre grandissant de demandes business peu qualifiées et peu réalistes.
- Certaines équipes Data s’appuient directement sur le **département marketing & communication** de leur entreprise afin de co-créer une communication récurrente au bon niveau de détail permettant de toucher un maximum de personnes.
En conclusion, **la mise en place d’une véritable culture data est un vecteur fort d’accélération de la réussite de vos initiatives data à l’échelle de l’entreprise**. Mettre en place des initiatives de **Data Literacy** s’avère donc essentiel pour aller dans ce sens.
Que vous soyez en train de vous diriger vers une organisation Data Mesh ou non, c’est cette culture qui permettra à l’équipe Data de passer d’un positionnement de “vendeurs de services Data” à celui d’équipe au service de la création de valeur Business.
---
### Data Stories : Le Data Mesh chez Blablacar
Source : https://www.hymaia.com/blog/data-mesh-blablacar/
Comment BlaBlaCar repense son organisation Data en s’inspirant des principes du Data Mesh.
## Le contexte Data de Blablacar
Chez Blablacar, la **data est rattachée à l’Engineering**. C’est une entité d’une quarantaine de personnes, répartie en 6 équipes : 5 squads pluridisciplinaires, et une dernière équipe orientée plateforme (nommée Data Ops).
Beaucoup de métiers de la Data sont représentés dans cette entité : **Data Analysts, Data Scientists, Software Engineers et Data Engineers**. Cela leur permet d’avoir une grande autonomie dans la réalisation de projets de bout en bout.
## The Why : La nécessité d’opérer plus efficacement à l’échelle
Commençons par la commencement.
Nous sommes début 2021. À ce moment, l’**entité Data est organisée par couches technologiques** : une équipe Data Engineering, une équipe Data Science, et ainsi de suite. C’est une approche assez classique dans les entreprises, permettant de créer de véritables **pôles d’expertises** qui peuvent développer des pratiques et des outils communs.

L’inconvénient est que la stack technique, résultante de cette organisation, était elle-aussi composée de différentes couches technologiques, dont l’interopérabilité et la fluidité de transition pour un même projet devenaient de moins en moins optimales.
La stack est la conséquence de l’organisation (loi de Conway). Une organisation par pôles d’expertises produit une stack par couche technologique.
Ce modèle a petit à petit été remis en cause devant le constat suivant : face à la croissance des besoins business, et donc de l’équipe data, il devenait de plus en plus **difficile d’opérer efficacement à l’échelle**.
Les équipes data commençaient petit à petit à devenir des **goulots d’étranglement**, la vitesse de delivery de gros projets augmentait, les priorisations des Use Cases n’étaient pas claires, pas plus que l’ownership de certains sujets comme la Data Quality.
A titre d’exemple, absorber et délivrer de la donnée venant de nouvelles entités était devenu très long et compliqué. De plus en plus de cas d’usage Data Science apparaissaient, notamment avec du streaming, pour lesquels il devenait difficile de faire évoluer l’architecture pour servir ces besoins.
La problématique : opérer plus efficacement à l’échelle
Face à ce problème grandissant, **la nécessité d’un changement d’organisation est devenue une évidence**.
L’idée d’équipes autonomes liées à des domaines dans lesquels elles opèrent est alors venue assez naturellement.
## The How : Le Data Mesh comme source d’inspiration, mais pas la seule
Forcément, face à ces constats, les **principes du Data Mesh**, décrits dans de nombreux articles et livres, semblent coller parfaitement et apparaître comme une évidence.
Mais un sujet aussi important, qui touche autant à l’aspect humain, ne doit pas être pris à la légère. Appliquer des principes théoriques **_by the book_** sans autre source d’inspiration n’apparaît pas comme la bonne solution.
Que faire alors ? Par quoi commencer ? Vers qui se tourner ?
Comme souvent dans les problématiques actuelles en data, la réponse se trouve sous nos yeux. **Il n’y a pas meilleure source d’inspiration que les équipes Product & Engineering qui sont juste à côté**, car elles ont déjà vécu des transformations similaires par le passé. Il est en effet assez fréquent de retrouver des feature teams pluridisciplinaires en Software Engineering. En outre, les principes du Data Mesh ne sont pas sans rappeler ceux du Domain Driven Design, qui a fait ses preuves depuis des années en Engineering.
L’Engineering a plusieurs années d’avance sur la Data concernant beaucoup de sujets, c’est une grande source d’inspiration.

S’inspirer des challenges organisationnels qu’ils ont rencontré, comprendre les enjeux d’une transformation vers des architectures micro-services et la manière dont on fait collaborer les équipes entre elles, voilà des retours d’expérience précieux pour une réussite de sa transformation d’organisation data !
## The What : Chronologie de la transformation vers le Data Mesh
Un tel changement ne doit pas s’opérer en mode Big Bang, mais de manière incrémentale en apprenant au fur et à mesure et en ajustant en temps réel. Chronologiquement parlant, voici les étapes franchies chez Blablacar :
- **Q3 2021** : Constat est fait des limites actuelles de l’organisation. S’ensuit une phase de diagnostic du problème et de définition de la vision ;
- **Q4 2021** : Onboarding des managers pour créer un alignement sur les problématiques et la vision cible. S’ils ne se sentent pas _owners_ de ce changement, ils ne seront pas moteurs et cela sera un frein au changement ;
- **Q1 2022** : Création de deux premières équipes afin d’entamer le changement sans faire de Big Bang et apprendre au fur et à mesure ;
- **Q2 2022** : Création des 4 équipes restantes ;
- **Fin 2022** : Tous les changements de _reporting line_ sont faits depuis 6 mois, et certaines équipes en sont déjà à leur 3ème trimestre de fonctionnement ;
- **2023** : Continuer les migrations techniques, qu’il avait été décidé de ne faire qu’une fois les changements organisationnels faits, car c’est avant tout un changement culturel et humain.
Forcément, au moment de faire des choix dans sa transformation, beaucoup de questions se posent ! Revenons sur quelques-unes qui sont sur beaucoup de lèvres.
### Comment choisir par quelles équipes commencer ?

On aimerait tous avoir un plan tout tracé et qui fait parfaitement sens ! La réalité est souvent plus pragmatique.
BlaBlaCar a choisi de **commencer par les domaines qui semblaient les plus simples à rendre indépendants**. Mais aussi de **prendre en considération des mouvements internes qui étaient déjà prévus** et qui ont accéléré certains changements plutôt que d’autres. Les dernières équipes à avoir été créées étaient celles dont les domaines étaient plus imbriqués et difficiles à bien isoler.
**Faut-il travailler sur tous les piliers du Data Mesh en même temps ?**
La réponse est propre à chaque organisation et à ses priorités.
Chez BlaBlaCar, ça n’a pas été le cas. En l’occurence, le pilier **_Data As A Product_** est peut-être celui où il y a eu le moins d’investissement à ce stade de la transformation. Typiquement, il n’y a pas de PO Data par domaine chez Blablacar !
Certains puristes pourront alors s’exclamer que cette organisation n’est pas un Data Mesh ! Et ils auront peut-être raison… en théorie. Au final, ce qui compte n’est pas d’avoir respecté à la lettre des principes théoriques, mais de faire les choix qui ont le plus de sens à ce moment pour répondre au besoin.
BlaBlaCar n’a pas de PO/PM dédié au sein des équipes data
De même, l’autonomie des squads au point de gérer elles-mêmes leurs pipelines d’ingestion n’a pas été poussée aussi loin. Certaines activités sont encore centralisées, car dans leur contexte il apparaissait plus simple de garder un certain nombre de choses mutualisées. Cela aurait rajouté trop de changements d’un seul coup pour les squads, qui en avaient déjà beaucoup à absorber sans cela.
### **Y a-t-il des changements à opérer en dehors de la data, notamment côté Business ?**
Encore une fois, la réponse dépendra du contexte.
Chez BlaBlaCar, il y a eu très peu d’impact organisationnel en dehors de la data, car nous ils ont **opéré le changement d’organisation data de telle sorte qu’elle soit le miroir de l’organisation en domaines d’un point de vue métier**. Ils restent donc une unité data à part entière (alors que dans la littérature, il faudrait qu’elle soit complètement intégrée dans les domaines) dans l’organigramme de l’entreprise, mais ont un fonctionnement totalement calqué sur les grands domaines métier de l’entreprise.

Adopter une organisation en miroir des domaines métier pour faciliter la transformation et limiter l’impact sur les autres équipes
## Zoom sur quelques détails d’implémentation
### La gouvernance fédérée
Afin de garder une cohérence et des pratiques communes au sein d’une même expertise technique malgré ce nouveau découpage, BlaBlaCar a créé des **Chapters**, **des communautés de pratiques par expertise** où chacun peut se retrouver, se faire challenger sur ses choix et apprendre de ses pairs.
Ces Chapters ont un lien direct avec la notion de **gouvernance fédérée** du Data Mesh, avec un ou plusieurs membres de chaque Chapter au sein de l’équipe de gouvernance. Ils sont les garants de l’harmonisation des pratiques malgré la dispersion des personnes au sein des différentes équipes.
L'autonomie et les frontières entre les squads ont besoin d'un contrepoids : une gouvernance fédérée et des pratiques communes.
D’un point de vue gestion d’entreprise, c’est aussi un moyen pour BlaBlaCar d’éviter que les managers gèrent trop de responsabilités. **Avoir des Chapter Leads est donc aussi un moyen de responsabiliser des contributeurs individuels.**
Cette task force de gouvernance gère des sujets qui touchent à la fois à la gouvernance de la donnée (cataloging, quality, lineage, etc.) ainsi qu’à la gouvernance des équipes (règles de fonctionnement et de synergies entre les équipes) ou des périmètres (déplacement des frontières, création de nouveaux domaines).
### La Data Platform et son équipe
**À date, BlaBlaCar garde une équipe data centrale, nommée Data Ops.** Elle fournit l’infrastructure et les services nécessaires aux autres équipes, et crée également certains patterns d’ingestion pour les consommateurs que sont les Data Engineers dans les squads.
L’ingestion de la donnée de production est gérée par l’équipe centrale, mais les transformations sont de la responsabilité des squads.
Au quotidien, l’équipe Data Ops se synchronise avec le Chapter Data Engineering qui représente toutes les squads, ce qui permet de parler d’une même voix concernant toutes les contraintes potentielles au niveau des squads. Cela permet de converger assez vite vers des solutions.
Dans l’implémentation, notamment en ce qui concerne les migrations techniques, l’équipe Data Ops les prépare, et communique auprès des squads lorsqu’ils peuvent les effectuer.
Avec la taille actuelle de l’entité data, ce fonctionnement est tenable sans que cette équipe centrale soit un goulot d’étranglement. Au fur et à mesure que l’équipe grandira et gagnera en maturité, certaines parties seront probablement redistribuées dans les squads.
Pour éviter une nouvelle création de silos, et faire en sorte que chacun comprenne et apprenne des autres, certaines personnes de l’équipe DataOps peuvent aller (même temporairement) au sein d’une squad et inversement. Cela a deux grandes vertus : garantir que les outils et patterns que fournissent l’équipe Data Ops répondent bien aux besoins des squads qui sont leurs clients, et permettre aux équipiers de découvrir d’autres sujets.
## Quels résultats et enseignements ?
### L’impact humain de cette transformation
**Des feedbacks positifs de la part des squads**
Preuve de la pertinence de cette transformation : **les squads font aujourd’hui des retours très positifs sur les synergies que cette nouvelle organisation a créé** en fonctionnant en équipes pluridisciplinaires, chose qu’il était très difficile de faire fonctionner avant.
La majeure partie du voyage se déroule dans l'esprit des gens. Passer à une architecture distribuée, c'est 80% de changement de mentalités.
**La population la plus impactée : les Data Engineers**
L’impact du changement le plus difficile à gérer concernait une population en particulier : **les Data Engineers**.
Ces derniers ont vu la manière dont ils travaillent complètement modifiée, ce qui est un changement lourd à vivre. Les embarquer au plus tôt dans le projet de transformation est probablement l’une des choses qu’ils auraient fait différemment si c’était à refaire.
A bon entendeur !
**L’impact du dimensionnement d’équipe par domaine**
Autre point de douleur qui a dû être géré : étant donné leur taille d’équipe et le découpage fait, **BlaBlaCar se retrouve avec certaines équipes où il n’y a qu’une seule personne sur une expertise donnée**, ce qui est difficile à vivre pour certains.
Les Chapters mentionnés plus haut répondent, au moins en partie, à cette problématique.
### **L’importance d’un bon sponsorship pour une transformation réussie**
**Une organisation est une réponse à un problème**. Le diagnostic de ce problème est donc primordial.
Il ne faut pas partir avec une solution en tête, puis embarquer et évangéliser les _stakeholders_ sur le problème qui découle de cette solution. C’est tout l’inverse ! Une fois que tout le monde a convergé sur le bon problème et qu’un alignement a été créé, il devient tout de suite plus simple d’embarquer les différents interlocuteurs sur la solution à implémenter.
Une organisation existe pour résoudre un (et un seul) problème. Le diagnostic de ce problème est donc primordial.
Et pour avoir ce sponsorship, il n’y a pas de secret : plus vous êtes capables de quantifier le ROI de vos projets, plus vous pourrez avoir du buy-in de la part du management. **Savoir quantifier le coût que représente un pipeline mal géré ou une donnée de mauvaise qualité est un élément très important qui pourra permettre de prioriser les changements**.
### Le lien avec les équipes Produit
L’organisation miroir mise en place a l’avantage de réduire le nombre d’intervenants à contacter pour anticiper les sujets. Une squad travaille notamment avec 2-3 PM côté produit, ce qui facilite les choses. Précédemment, chaque couche technologique était en interaction avec tous les PMs !
Il est important d’avoir construit en amont des bonnes relations avec les équipes Produit et Engineering afin de ne pas découvrir les nouvelles features au dernier moment.
## Quelques conseils pour conclure
Cette transformation de BlaBlaCar vers le Data Mesh est avant tout un challenge humain, et il ne faut pas négliger le temps nécessaire pour créer l’alignement qui facilite la transition. **Ce n’est donc pas tant un challenge technique (même s’il ne faut pas négliger la difficulté de cette partie) qu’un challenge de change management.**
Si vous vous posez la question de savoir si c’est le bon moment pour vous d’envisager une transformation vers le Data Mesh, vous pouvez vous appuyer sur l’heuristique suivante, suite au retour d’expérience de BlaBlaCar :
- Faire une organisation Mesh si vous n’avez qu’une seule squad n’a pas de sens ;
- En-dessous de 3 à 4 squads, il est important de se poser la question de savoir si c’est vraiment nécessaire ;
- Au-delà de 3 à 4 squads et s’il y a un besoin de grande diversité des expertises au sein des squads, cela commence à devenir intéressant car on arrive vite à une organisation à 30-40 personnes.
Le risque est de faire de la distribution trop tôt et donc de créer des silos et une divergence des pratiques si vos équipes ne sont pas encore assez matures. **Il est donc important d’avoir déjà des équipes ou des communautés de pratiques communes en amont.**
**S’il y a bien une chose à retenir, c’est qu’il ne faut pas chercher à implémenter une solution si on ne comprend pas le problème que l’on tente de résoudre.**
Le Data Mesh est **_une_** solution, mais il est important de faire son propre diagnostic en amont avant de s’y lancer tête baissée.
Les articles et livres sur le sujet sont d’excellents moyens de s’ouvrir les chakras et d’identifier de potentielles solutions, mais cela ne doit pas se faire au détriment du temps à consacrer au bon diagnostic du problème à résoudre.

---
### DataFrames PySpark & Pandas : très similaires à l'usage, mais un fonctionnement interne très différent
Source : https://www.hymaia.com/blog/dataframes-pyspark-pandas/
DataFrames PySpark vs Pandas : très similaires à l’usage, mais un fonctionnement interne très différent.
L’erreur classique est de lire un gros volume de données avec **Spark**, le convertir en **Pandas** parce qu’on est plus à l’aise pour débugger et de continuer toutes nos transformations avec **Pandas**, parce que… bah c’est pareil non ?
Bah non. Et la sentence sera sans équivoque : _Out Of Memory_ (**OOM**), _Java Heap space_. Mais qu’est-ce que cela signifie réellement ? Reprenons depuis le début et prenons le temps de bien détailler les différences entre **Pandas** et **PySpark**.
## Qu’est-ce que la Java Heap ?
Lorsqu’une application Java est lancée, il faut allouer des ressources pour exécuter le code mais aussi pour tout ce qui est [gestionnaire de thread et compilateur JIT](https://docs.oracle.com/cd/E13150_01/jrockit_jvm/jrockit/geninfo/diagnos/underst_jit.html). La mémoire allouée pour exécuter le code est appelée [Java Heap, et pour le reste on parle de Non-Heap](https://www.journaldev.com/2856/java-jvm-memory-model-memory-management-in-java).
## Je code en python, pourquoi j’ai une erreur Java ?
**Spark** étant développé en **Scala**, il utilise une **JVM** pour fonctionner. Lorsque vous utilisez l’**API** **Python** de **Spark**, votre SparkContext est créé dans un process **Python** mais **Spark** crée également un process **JVM** qui s’appelle **Py4J**. Ce process fait le lien entre votre SparkContext **Python** et les _Spark Workers_ qui font partie du monde Java en convertissant les instructions **PySpark** en leur équivalent **Scala Spark**.

Pour les **UDFs**, c’est l’inverse. Mais nous y reviendrons une prochaine fois dans un article dédié.
Maintenant que l’on sait que même en **PySpark** nous utilisons des **JVMs**, on comprend mieux pourquoi on se retrouve avec des erreurs **Java** en **Python**.
## La cause la plus fréquente de l’OOM Java Heap Space
D’après mon expérience, la cause la plus fréquente d’une erreur _OOM Java Heap space_ dans une application **Spark** est un collect() appelé sur un Dataset un peu trop gros. C’est cette cause qui nous intéressera.
La méthode collect() sert à récupérer le contenu d’un **DataFrame** dans une Liste. C’est à dire que l’intégralité de votre jeu de données sera téléchargée et chargée en mémoire sur votre _driver_ _Spark_. Si celui-ci fait 200Go, il vous faudra 200Go de mémoire vive pour que cela fonctionne. Sinon c’est l’_OOM Java Heap space_.
En introduction, je vous parlais de convertir un **DataFrame Spark** en **Pandas**. Étant donné qu’en Pandas nous manipulons également des **DataFrames** avec une API très similaire, nous avons tendance à penser que cela fonctionne de la même façon que **Spark**. Dans la réalité, la méthode toPandas() fait la même chose que la méthode collect() et l’objet **Pandas DataFrame** fonctionne comme un super dictionnaire **Python**.
Donc, si jamais le **DataFrame** que vous souhaitez convertir en **Pandas** fait 200Go et que vous n’avez pas 200Go de mémoire vive sur votre _driver_, c’est encore l’**OOM**.
## La différence entre Spark et Pandas
Alors que **Pandas** est une simple bibliothèque de structure de données **Python**, **Spark** est une application distribuée qui va utiliser plusieurs _workers_ pour traiter la donnée. Pour répartir cette donnée sur l’ensemble des _workers_, **Spark** va la découper en plusieurs morceaux en suivant 3 règles.
### Fichiers de moins de 4mo
On ne le répétera jamais assez, **Spark** est conçu pour traiter des gros volumes de données (à partir de plusieurs dizaine de Go). Mais il peut arriver que lors de l’écriture d’une source de données partitionnée, certaines partitions soient très petites. Lorsque **Spark** doit lire des fichiers de moins de 4mo, il les regroupe pour former une seule partition en mémoire afin d’optimiser le traitement. Cette valeur est configurable, ce paramètre s’appelle [spark.sql.files.openCostInBytes](https://spark.apache.org/docs/latest/sql-performance-tuning.html#other-configuration-options).
### Fichiers de 4mo à 128mo
Pour tous les fichiers entre 4mo et 128mo, **Spark** créera une partition par fichier et par tâche qu’un _worker_ peut traiter en parallèle.
### Fichiers de plus de 128mo
Pour tous les fichiers de plus de 128mo, **Spark** découpera le fichier en blocs de 128mo. Cette valeur est configurable via le paramètre [spark.sql.files.maxPartitionBytes](https://spark.apache.org/docs/latest/sql-performance-tuning.html#other-configuration-options). Vous l’aurez remarqué, cette valeur correspond à la taille des blocs par défaut dans **HDFS**. Cela a été fait exprès pour choisir par défaut d’optimiser les performances de **Spark** sur **HDFS**.

### Traitement des partitions dans Spark
Maintenant que l’on sait comment **Spark** découpe la donnée en partitions, il faut comprendre comment il les traite. Pour cela, il faut comprendre la notion de tâche.
Dans **Spark**, un job est composé de _stages_. Les _stages_ sont des successions de transformations sur la donnée qui commencent et terminent sur un _shuffle_.
Exemple :

Ici, nous avons 3 _stages_ :
1. De la lecture de notre fichier parquet à la méthode groupyBy() qui prépare un _shuffle_ ;
2. De la méthode count() qui crée un _shuffle_ jusqu’au join() ;
3. Du join() qui crée un _shuffle_ jusqu’à l’écriture de notre fichier.
Si nous prenons notre premier stage, il contient 4 transformations :
1. Une lecture de fichier ;
2. Un filtre ;
3. Une projection (select()) ;
4. Un groupBy().
Ces 4 transformations mises bout à bout forment une tâche et cette tâche sera assignée à chaque partition de notre jeu de données. Pour accélérer le traitement, **Spark** distribue cette tâche sur chaque _worker_. En fonction des ressources disponible sur un _worker_ et de sa configuration, celui-ci peut traiter plusieurs tâches en parallèle. Par défaut, un _worker_ utilise 1 CPU par tâche. La mémoire vive est partagée entre toutes les tâches.
## Spark et Pandas : ce qu’il faut retenir
Si on résume, dans un job **Spark** la donnée n’est pas chargée entièrement par les _workers_. Elle est découpée en partitions de taille variable et traitée morceau par morceau, parallélisée sur un grand nombre de machines. Cela permet de traiter indifféremment des fichiers de 1Go ou de 100To sans provoquer d’**OOM** à cause de la _Java Heap_.
Dans un job **Pandas**, qui au final n’est qu’un simple process **Python**, la donnée doit être entièrement chargée en mémoire sur une seule machine pour être traitée, ce qui crée des limitations sur les ressources de la machine en question.
Cela ne signifie pas pour autant que nous ne pouvons plus profiter de **PyPlot** via **Pandas**. Il va juste falloir être un peu malin et choisir le bon outil au bon moment. Si vous souhaitez afficher des graphiques via **PyPlot**, il vous faudra par exemple faire quelques agrégations en amont qui réduiront la taille de votre données.
Pour tout ce qui concerne les transformations à appliquer à la donnée, en passant par **Spark** tout ira très bien.
Après avoir appliqué vos agrégations et obtenu un **DataFrame** assez petit pour être chargée en mémoire par le _driver_, vous pouvez faire votre conversion en **Pandas**. Cette étape doit être la dernière avant d’appliquer votre **Dataviz**.
---
### De l'idée au déploiement : Créer un produit d'IA générative avec Bedrock
Source : https://www.hymaia.com/blog/derriere-les-coulisses-dun-produit-dia-generative-avec-amazon-bedrock/
Retour d’expérience sur la construction d’un produit d’IA Générative avec Amazon Bedrock.
_Qu’est-ce qu’on pourra faire avec ?_
Une question qu’on se pose souvent dès qu’une nouvelle technologie débarque dans nos vies. Et c’est d’autant plus le cas avec l’IA Générative, dont le potentiel semble parfois dépasser notre propre imagination.
C'est en nous posant cette question que, ayant comme cas d'usage l’organisation de nos événements Hymaïa, nous nous sommes lancés le défi d'exploiter l'IA générative pour **améliorer l'expérience des participants à nos conférences** et meetups.
Quelques jours après nous avons donc sorti le **POC pour un nouveau service** : un service de **RAG** (Retrieval Augmented Generation) capable de fournir, en temps (quasi) réel :
1. le **résumé de la présentation** en cours par le conférencier
2. **répondre à des questions** sur l’ensemble des présentations d’une journée de conférence.
Nous ne le nierons pas : cet outil est aussi une excuse pour nous mettre à l'épreuve, construire des convictions solides sur la mise en place d'un service complet, englobant front-end, back-end, storage et, bien sûr, l'intégration d'un _Large Language Model_.
Dans cet article nous présenterons la solution, les choix technologiques ainsi que les résultats.
## 1\. Solution
Comme présenté plus haut, notre solution consiste en un RAG se reposant sur un base documentaire créée en temps réel à partir de la transcription des présentations d’une conférence.
Nous avons donc conçu 2 produits :
1. Un outil de résumé de la présentation en cours sous forme de 5 points essentiels, avec un niveau de détail ajusté pour permettre une lecture rapide en quelques secondes.
2. Un outil de Q&A permettant aux participants de poser des questions telles que "_Qu'est-ce qu'un Produit Data ?_" et d'obtenir une réponse élaborée, citant également les sources.
Pour le choix des briques technologiques nous nous sommes basé sur 4 critères d’acceptance principaux :
- Temps de réalisation contenu : nous devions mettre en place une solution opérationnelle en un temps très court, avec seulement 5 jours avant notre prochain événement.
- Coûts limités : nous souhaitions des coûts de fonctionnement réduits, avec une possible tarification à l'usage pour l'ensemble du système.
- Temps réel : la capacité à utiliser le service pendant la présentation, avec une latence minimale ; les utilisateurs ne devant pas attendre plusieurs minutes après la fin de la présentation pour consulter le résumé.
- Scalabilité : les services devaient pouvoir être utilisés par un nombre d'utilisateurs concurrents allant de 1 à quelques dizaines. Rien de particulièrement ambitieux, mais suffisant pour imposer certaines contraintes.
## 2\. Fonctionnement
Voici une représentation graphique des composants de la plateforme. Pour plus de détails, nous vous invitions à vous référer à la Partie 3 : “Choix Techniques”.

Comme présenté dans le schéma, le produit utilise un front-end d’enregistrement sous forme de page Web, actionné par un opérateur humain, qui devra lancer l’enregistrement en occasion de chaque talk d’une conférence en fournissant également un titre et, possiblement, une courte phrase de contexte, utilisée pour améliorer la qualité du speech-to-text. Ce front-end enregistre donc l’audio en segments de 30 secondes pour ensuite les transferrer dans un bucket S3, configuré pour déclencher l’exécution de la lambda de Speech-to-Text basée sur Whisper.
Les segments de texte en output sont ensuite fusionnés en continu dans un seul document pour chaque talk, qui est ensuite converti sous forme de vecteurs d’embedding par Amazon Bedrock Knowledge Base.
Deux autres front-ends se servent de l’API Bedrock pour demander :
1. le résumé du dernier talk, à l’aide d’un prompt simple à base d’une approche one-shot learning
2. les query de l’utilisateur pour l’interface question/réponse
## 3\. Choix techniques
Aux critères fonctionnels décrits en introduction de l’article, nous en avons ajouté un 5e, plus technique : celui de ne dépendre que d'un seul fournisseur de services et de ne pas utiliser les API "haut-niveau" d'OpenAI. Ce choix découle de la volonté de nous conformer à l’approche privilégiée par les entreprises, qui consiste à rationaliser les fournisseurs pour simplifier la facturation et la gestion des ressources.
À plus d’un an de distance de la présentation de ChatGPT, vrai “Game changer” dans le domaine, les plateformes pour le développement de services basés sur l’IA Générative sont désormais nombreuses. Cependant, dans le but, purement technique, de monter et renforcer nos compétences sur l’offre Générative AI de AWS, nous avons choisi de nous servir de ce dernier.
De manière particulière, nous avons opté pour l'utilisation d'AWS Bedrock Knowledge Base, qui permet d’enrichir un LLM par une base documentaire pour la création de RAGs serverless.
Il est donc temps de définir l’architecture. Le service repose sur 4 briques principales:
1. Le Speech-to-Text : permet de convertir la voix du présentateur en un texte qui servira de base documentaire.
2. Le stockage des documents textuels : ceux-ci sont répertoriés dans une base de données vectorielle où nous enregistrons la représentation numérique (embeddings) des textes.
3. Le LLM permettant de fournir une réponse “augmentée” (c'est-à-dire, enrichie et contextualisée) à partir du prompt en entrée et des documents.
4. Les front-ends auxquels les utilisateurs accèdent pour utiliser les services.
### 3.1 Speech-to-Text
Bien que AWS propose des services sur étagère de Speech-to-Text, pour ce projet nous avons fait le choix d’utiliser OpenAI Whisper, que nous avions utilisé par le passé dans d’autres contextes et qui nous avait pleinement satisfait.
Un aspect plutôt intéressant de Whisper est en particulier sa frugalité en termes de ressources. Les versions “small” et “medium” de ce modèles permettent notamment d’être exécutées en CPU. Après quelques itérations, et des tests de performance sur AWS Fargate, nous avons pris le choix d’exécuter l’inférence (c-a-d la transcription de la parole en texte) sur une instance Whisper exécutée à l’intérieur d’une Lambda AWS, via un layer custom.
En particulier, cette solution remplit parfaitement nos critères de maitrise des coûts mais aussi de performance : le speech-to-text d’un segment audio de 30 secondes via Whisper sur une AWS Lambda ne demande pas plus que 10-12 secondes pour la version “small” du modèle, et 20-24 secondes pour la version “medium”.
Nous aurions bien évidemment pu opter pour la version basée sur API proposée par OpenAI, mais cela aurait été relativement plus cher, en plus d’être en contradiction avec notre choix d'intégrer l'ensemble du système sur AWS.
### 3.2 Stockage des documents
Une fois les segments audio transcrits, ils sont stockés dans des répertoires S3 avant d'être convertis en vecteurs et stockés via le service Amazon Bedrock Knowledge Base. Ce dernier simplifie grandement la mise en place d'un RAG en se chargeant des étapes de création et de mise à jour de la base de données. Un détail technique intéressant est que les données sont stockées dans une instance OpenSearch Serverless, accessible séparément en cas de besoin. Bien que Amazon Bedrock Knowledge Base permette l'utilisation d'autres bases vectorielles comme Pinecone, nous avons choisi de ne pas explorer cette possibilité dans le cadre de ce projet. Quant au modèle d'embedding, nous avons choisi le seul disponible au moment du développement du projet : AWS Titan G1.
### 3.3 LLM
Pour notre couche de génération, Bedrock permet de choisir parmi nombreux modèles LLM, tels que Llama 2, Claude, Amazon Titan et d’autres. Dans le cadre de notre projet nous avons choisi l’excellent Claude Instant 1.2, plus rapide que Claude 2, et possédant une context window de 100.000 tokens. Par ailleurs, à différence de la plupart des modèles, Claude Instant 1.2 est également compatible avec les services de RAG serverless de Bedrock Knowledge Base ce qui simplifie ultérieurement notre choix.
### 3.4 Front-Ends
La couche front-end se compose de trois applications Web distinctes :
1. La première application fournit l'affichage du résumé de la présentation en cours.
2. La deuxième offre une interface de questions-réponses, comprenant un champ de texte permettant à l'utilisateur de poser des questions.
3. La troisième application fournit l'interface d'enregistrement destinée à l'opérateur du service.
Ces trois applications présentent une architecture simple, basée sur du HTML et du Vanilla JS, qui interagit avec des fonctions AWS Lambda exposées via un API Gateway.
Pour ce qui est des deux premières applications, leur simplicité est en partie due au niveau d'abstraction offert par l'API de Bedrock, qui, bien que sa documentation soit actuellement assez sommaire, reste très accessible.
Quant à l'application fournissant l'interface d'enregistrement, elle utilise les API d'enregistrement audio du navigateur et est responsable du découpage en segments de 30 secondes. Cette approche peut sembler sub-optimale car le découpage est réalisé de manière basique, entraînant parfois la coupure de certains mots en deux, alors que le serveur aurait pu effectuer un découpage plus intelligent. Néanmoins, cette méthode nous évite de maintenir un serveur de streaming, ce qui se traduit par des économies significatives.
## 4\. Résultats
Après une première itération, les résultats nous ont semblé rapidement prometteurs. Comme évoqué plus haut, pour le processing Speech-to-Text nous avions expérimenté des tasks AWS Fargate avant d’opter pour une AWS Lambda qui, lors d’un démarrage à chaud, offre des performances d'inférence très intéressantes. De plus, le temps de calcul et de stockage des embeddings sur AWS est de 5 secondes environ, ce qui est négligeable dans notre cas d’utilisation.
Concrètement, de bout en bout, le système est capable de produire un résumé d'une portion d'une présentation en 15 à 17 secondes après la fin de l'enregistrement du premier segment.

### 4.1. Optimisations
Pour réduire ultérieurement le délai de disponibilité du résumé, nous avons mis en place un petit contournement. En effet, grâce à la taille de la fenêtre de contexte de Claude Instant 1.2, le service de résumé n’a pas besoin de récupérer l’information depuis la base de données vectorielles, mais reçoit le verbatim du texte de la présentation en cours directement dans le prompt. Dans le cadre du service de résumé, cela nous permet donc d'économiser facilement les 5 secondes nécessaires à la vectorisation du document.
### 4.2. Limitations
Bien que globalement personnellement satisfaits par le résultat technologique (et du temps de développement du service) certaines limitations se sont manifestées à l’usage et demandent une réflexion approfondie.
En particulier, le modèle de Speech-to-Text ne prend pas en charge la _diarization_, c'est-à-dire la reconnaissance des intervenants lorsqu'il y a plusieurs voix. Cet aspect est particulièrement limitant lors d’interviews ou de tables rondes car dans ces cas le système ne pourra pas attribuer correctement les propos à chaque orateur. Par exemple, lors d’un podcast impliquant 2 intervenants X et Y, il sera impossible de répondre de manière précise à une question du type “Quel est l’avis de X ?” car le document issu du Speech-to-Text ne dispose pas de la metadonnée associant une phrase à une personne en particulier.
Il est également important de souligner que, lors de certains talks présentant un vocabulaire technique très spécifique, le speech-text, notamment dans sa version “small” peut présenter des lacunes de compréhension des termes et donc poser des difficultés de compréhension au RAG. Un modèle “large”, dans ces cas, pourrait améliorer la qualité du service mais ne pourra pas vraiment remplacer une première phase d’apprentissage des termes techniques utilisés. Cela est relativement facile car prévu par l’API du modèle Whisper mais demandra de la saisie manuelle d’information de la part de l’opérateur.
D'un point de vue produit, il est pertinent de noter que la génération en temps réel d'un résumé complet d'une présentation ne répond pas toujours aux besoins spécifiques de l'utilisateur final. Il pourrait être plus judicieux de lui offrir la possibilité de choisir la durée du résumé : soit l'intégralité de la présentation, soit les 5 à 10 dernières minutes, au cas où il aurait besoin de se remettre rapidement dans le fil du discours ou de comprendre les derniers concepts abordés par l'orateur.
## **5\. Coûts**
En ce qui concerne les coûts associés à ces services, les principales dépenses comprennent la base vectorielle OpenSearch, l'inférence "pay-per-use" du modèle linguistique Claude Instant, la fonction lambda hébergeant Whisper, ainsi que le stockage S3.
Parmi ces éléments, OpenSearch représente le poste de dépenses le plus élevé, avec un coût d’environ 6$ par jour.
Quant au Speech-to-Text sur Lambda, bonne surprise : son usage reste dans notre free tier et elle nous coute 0 après quelques centaines d’invocations. La vectorisation des documents a également un coût négligeable dans notre cas (0.01$), en vertu de son prix unitaire de $0.0001 chaque 1000 tokens d’input.
En ce qui concerne LLM, dans notre cas, la dépense, compte tenu de la faible volumétrie, est plutôt limitée, mais pas négligeable puisque, compte tenu du prix de 0.8$ par millions de token en input et 2.4$ par millions de token en output, la facture journalière après 3000 requêtes environ s’élève à 10$.
Au total, pour chaque jour d’exploitation, nous avons constaté une facture d’environ 15-16$.
## Conclusion et évolutions futures
Bien que les premiers résultats soient encourageants, le projet ne s'arrête pas là. De la _diarization_ à l’accélération du temps de traitement ou, encore, à la réduction des coûts le projet offre de nombreuses directions pour approfondir l’usage et la création de produits basés sur l’IA Générative. Nous souhaitons améliorer la qualité de l'expérience de nos utilisateurs, si vous avez des idées, n'hésitez pas à commenter l'article Linkedin associé à cette page.
---
### Ne pas avoir une équipe Data assez diversifiée
Source : https://www.hymaia.com/blog/ecueils-data-e2-ne-pas-avoir-une-equipe-data-assez-diversifiee/
Votre équipe Data a-t-elle toutes les compétences pour créer des Produits Data de bout en bout ?
Lorsque l’on parle d’équipe Data, les profils qui viennent assez souvent entête sont les Data Scientists et les Data Engineers. Ils ont en effet un rôle essentiel dans l’implémentation de Use Cases Data. Mais il y a de fortes chances pour que ces deux profils ne soient pas suffisants pour réellement pouvoir créer des Produits Data qui apportent de la valeur business, et **encore moins pour passer à l’échelle dans l’exploitation de la donnée de l’entreprise**.
Certains métiers semblent peu à peu disparaître au profit de nouvelles dénominations et pour s’adapter aux nouvelles tendances. D’autres en revanche reviennent sur le devant de la scène suite à la prise de conscience de certains manquements.
C’est notamment le cas du **Data Analyst** (certains utilisaient plutôt le terme Data Miner). La Data Analyse était une composante essentielle du business il y a quelques années. Les Data Analysts travaillaient moins l’aspect algorithmique et prévisionnel, et étaient vraiment focalisés sur la compréhension business via la donnée. Avec la vague de la Data Science, cette compétence s’est vue être petit à petit sortie des radars, face à la promesse de ces nouveaux profils et de tous ces algorithmes qui allaient révolutionner l’exploitation de la donnée. La conséquence négative de ces changements est qu’**un fossé s’est peu à peu creusé entre le business et la Data**. En effet, beaucoup de ces nouveaux experts de la donnée n’ont en réalité pas suffisamment de compréhension (ou d’intérêt ?) business, et sont plus intéressés par la performance algorithmique des modélisations.
C’est la raison pour laquelle beaucoup d’entreprises se réorganisent aujourd’hui afin de réintégrer cette composante essentielle et redonner ses lettres de noblesse à la Data Analyse. **Data Scientist et Data Analyst ne sont donc pas les mêmes métiers**, même si des synergies et des recouvrements peuvent être apparents.
Notre conviction est que l’important n’est pas tant de savoir combien de personnes ou de métiers différents vous devez intégrer au sein de vos équipes Data, mais bien de vous poser la question suivante: **toutes les compétences essentielles à la création de Produits Data de bout en bout sont-elles représentées au sein de vos équipes Data ?**
La question à vous poser : Toutes les compétences essentielles à la création de Produits Data de bout en bout sont-elles représentées au sein de vos équipes Data ?
Les compétences en question peuvent s’avérer extrêmement nombreuses. Nous en recensons ici une dizaine qui apparaissent régulièrement comme des compétences clé dans l’exploitation de la donnée à l’échelle dans les entreprises :
- **Data Product Management** : Challenger le QUOI et le POURQUOI avec les métiers, comprendre la donnée et être capable d’y accéder pour tirer les initiatives Data et les proposer au business ;
- **Data Engineering** : Mettre en place des pipelines de données dans un environnement scalable et de confiance, en respectant les principes du Software Craftsmanship ;
- **ML / MLOps Engineering** : Industrialiser, déployer et gérer des modèles de Machine Learning en production ;
- **Data Management / Stewardship** : Veiller à ce que les données soient accessibles, compréhensibles et réutilisables, ainsi que s’assurerde leur qualité et prioriser des actions pour aller dans ce sens ;
- **Data Analyse** : Requêter, croiser et analyser les données pour en tirer des enseignements et exposer des informations facilitant la prise de décision business ;
- **DataOps / Data Reliability Engineering** : Assurer la gestion de la donnée à l’échelle de l’entreprise, garantir sa qualité et son exploitabilité, et faire preuve de proactivité dans l’identification et la communication des erreurs ;
- **Data Science :** Identifier les croisements de données et les modélisations adéquates pour répondre à une problématique business définie ;
- **Data Visualisation** : Exposer la donnée de manière claire et intuitive afin de faciliter la prise de décision informée par la donnée ;
- **Data Architecture** : Penser, créer et faire évoluer des plateformes Data scalables.
Nous souhaitons ici mettre en avant une notion importante : celle de l’**interdépendance entre chaque profil Data**. Il ne s’agit pas de créer un monde siloté où un Data Scientist ne se contente que de créer des algorithmes sur des notebooks qu’il envoie ensuite aux Data Engineers pour qu’ils l’industrialisent une fois qu’il est satisfait. Au contraire, il nous paraît par exemple essentiel qu’un Data Scientist soit sensibilisé aux problématiques liées au Software Engineering et à l’industrialisation de modèles de Machine Learning, et qu’un Data Engineer comprenne les spécificités inhérentes au travail d’un Data Scientist. Il en est de même pour l’ensemble des profils Data, qui doivent absolument garder des frontières poreuses.
C’est la raison pour laquelle nous parlons plutôt des compétences clés requises pour la création de Produits Data de bout en bout, car une même personne pourra avoir plusieurs de ces compétences. Preuve supplémentaire de cette multidisciplinarité et porosité essentielle entre chaque profil : l’apparition de nouvelles appellations et nouveaux métiers tels que le **Machine Learning Engineer, le MLOps Engineer, ou encore le Data Reliability Engineer** (le pan Data du Site Reliability Engineer). L’ordre dans lequel vous intégrerez ces compétences dépendra fortement de la maturité de vos équipes et de votreexistant. Nous attirons cependant votre attention sur deux aspects importants :
- **Intégrer la dimension Business & Produit au plus tôt**. Un projet Data se perd dès que sa valeur business est elle-même perdue de vue ;
- Construire votre socle de données de manière pérenne afin d’avoir de la donnée de qualité, dans laquelle les utilisateurs peuvent avoir confiance, et pour laquelle ils peuvent retrouver toutes les informations dont ils ont besoin (son origine, ses transformations, sa fraîcheur, etc.). **Le manque de confiance dans la donnée est l’un des points de douleurs les plus fréquemment remontés par les utilisateurs.**
Notre recommandation : Construire une équipe Data diversifiée, sans laisser de côté les dimensions business et produit.
La diversité n’est pas qu’une question de compétences techniques. Elle est aussi apportée par des backgrounds différents. Vouloir recruter uniquement des profils venant des mêmes écoles est selon nous une erreur (nous y reviendrons notamment dans la section sur les biais), car vous risquez d’avoir des personnes ayant les mêmes modes de pensée et de fonctionnement. La diversité est cruciale dans la constitution d’une équipe Data, afin de challenger le statu quo et se remettre en question constamment.
Si vous souhaitez avoir l’ensemble des écueils à portée de main, rien de plus simple ! Vous pouvez [télécharger notre eBook](https://eu1.hubs.ly/H01QVgc0) dédié directement en pdf, ou bien vous le procurer en version imprimée ou Kindle sur [Amazon](https://www.amazon.fr/%C3%89cueils-limitant-limpact-produits-organisations-ebook/dp/B0BFJQP2P9/) !
---
### Croire que la Culture Data s’arrête à l’équipe Data
Source : https://www.hymaia.com/blog/ecueils-data-e3-croire-que-la-culture-data-sarrete-a-lequipe-data/
Avez-vous tous la même définition des rôles, responsabilités et enjeux de la Data au sein de votre entreprise ?
Ces dernières années ont fait la part belle à une mystification de la Data, faisant penser aux non-initiés que c’est un domaine totalement nouveau et nécessitant des compétences très approfondies pour être compris. La prolifération de nouvelles terminologies n’a pas aidé, et les communications sur les dernières avancées de la recherche sur l’Intelligence Artificielle non plus.
Résultat ? Un fossé s’est rapidement creusé entre les équipes Data et le reste de l’entreprise, avec le sentiment que ces équipes Data parlent un langage totalement différent. Cela a bien évidemment eu des conséquences négatives sur l’appropriation de la Data à plus grande échelle dans l’entreprise et sur la réussite de nombreux Produits Data.
**Et pourtant, la diffusion d’une culture Data à l’échelle de l’entreprise est une responsabilité essentielle, et souvent sous-estimée, des directions Data.**
On constate notamment un manque flagrant de définitions communes au sein des entreprises sur les rôles et responsabilités des différents acteurs de la Data. Pire, il suffit de chercher des définitions sur ce qu’est un Data Analyst sur le web pour se rendre compte que chacun a sa propre définition, allant de “gérer le Data Warehouse” à “apporter des réponses à des questions business grâce à la donnée”. Le spectre est donc large.
La question à vous poser : Avez-vous tous la même définition des rôles, responsabilités et enjeux de la Data au sein de votre entreprise ?
Ce manque d’alignement va bien au-delà des rôles, et même de la Data. En effet, il n’est pas rare que deux départements d’une même entreprise n’aient pas la même définition de ce qu’est un “client” ou une “transaction”. Partant de ce constat, difficile pour les équipes Data de satisfaire tout le monde avec des données et produits qui mettent tout le monde d’accord.
Il apparaît donc nécessaire d’aligner au plus tôt chaque acteur touchant de près ou de loin aux problématiques Data sur le vocabulaire et les rôles qui y sont associés. Quelques exemples pour y parvenir :
- Créer un **lexique partagé** pour s’assurer que tout le monde ait la même définition ;
- Faire des interviews des différentes directions métier afin de vous assurer d’une **homogénéité** dans la définition d’un “client” ou d’un “utilisateur” ;
- Mettre en place des **ateliers de clarification et d’alignement** sur les rôles, compétences et responsabilités des différents profils Data (du Data Engineer au Data Analyst, en passant par le Data Product Manager).
Cet alignement constitue votre première étape dans une démarche plus globale d’acculturation de toute l’entreprise à la Data.
Deuxième nécessité : sensibiliser et former le maximum de personnes à la Data. Pour cela, nous recommandons de mettre en place une démarche d’acculturation Data à plusieurs niveaux :
## Niveau 1 : À destination de l’ensemble des collaborateurs de l’entreprise, COMEX inclus
Ce premier niveau a pour objectif la **démocratisation et la démystification de la Data**, afin de créer un alignement et une sensibilité de chaque personne à ses enjeux, et ainsi réduire la barrière mentale que l’on peut se mettre lorsque les mots “Data” ou “IA” sont prononcés. Cela pourra prendre la forme de webinars ou de workshops courts.
## Niveau 2 : À destination des “Business Users”
Ce deuxième niveau a pour objectif que **chaque personne puisse être capable de prendre des décisions informées par la donnée**, en utilisant les bons outils et en ayant les bons réflexes méthodologiques et techniques. Pour atteindre cet objectif, des sessions de formation plus intensives, sur quelques jours, peuvent s’avérer nécessaires.
## Niveau 3 : À destination des équipes expertes Data
Ce troisième niveau vise à former et à maintenir une veille constante des experts de la donnée sur les technologies et méthodologies qui sont dans leur champ de compétence. Cela pourra prendre la forme de formations en interne comme en externe, mais aussi la possibilité d’assister à des conférences spécialisées ou de mettre en place des temps dédiés de veille et de partage au sein des équipes.
Notre recommandation : Mettre en place une démarche d’acculturation Data à plusieurs niveaux.
Dernier point, et non des moindres : la communication. En effet, mettre en place une communication régulière sur les avancements et les succès des initiatives Data est crucial afin de créer de l’engouement au sein de l’entreprise. Le manque de transparence entre les équipes favorise les silos que la communication peut permettre de briser.
Quelques bonnes pratiques sont tout de même à garder en tête pour la communication sur les avancées en Data :
- **Communiquer régulièrement** : Toutes les une à deux semaines. Un piège est d’attendre trop longtemps entre chaque communication, ou d’attendre d’avoir terminé un Use Case avant de communiquer dessus ;
- **Ne pas trop simplifier :** La vulgarisation est bien sûr importante pour ne pas noyer d’informations les lecteurs, mais nous vous mettons en garde contre les raccourcis trop grands qui peuvent faire penser à vos interlocuteurs que tout est simple et rapide à mettre en place, ce qui pourrait engendrer un nombre grandissant de demandes business peu qualifiées et peu réalistes ;
- **S’appuyer sur les équipes marketing et communication :** Certaines équipes Data s’appuient directement sur le département marketing & communication de leur entreprise afin de co-créer une communication récurrente et avec le bon niveau de détail permettant de toucher un maximum de personnes.
En conclusion, **la mise en place d’une culture Data est selon nous un vecteur fort d’accélération de la réussite de vos initiatives Data à l’échelle de l’entreprise**. C’est cette culture qui permettra à l’équipe Data de passer d’un positionnement de “vendeurs de services Data” à celui d’équipe au service du business pour créer de la valeur.
Si vous souhaitez avoir l’ensemble des écueils à portée de main, rien de plus simple ! Vous pouvez [télécharger notre eBook](https://eu1.hubs.ly/H01QVgc0) dédié directement en pdf, ou bien vous le procurer en version imprimée ou Kindle sur [Amazon](https://www.amazon.fr/%C3%89cueils-limitant-limpact-produits-organisations-ebook/dp/B0BFJQP2P9/) !
---
### Penser que la Data est exempte des bonnes pratiques Craft
Source : https://www.hymaia.com/blog/ecueils-data-e4-penser-que-la-data-est-exempte-des-bonnes-pratiques-de-software-craftsmanship/
Les bonnes pratiques du Software Engineering s’appliquent aussi à vos Produits Data.
Le monde de la Data a souvent été vu comme un univers parallèle, tellement spécifique qu’il doit avoir ses propres règles de gestion et de développement. **Encore aujourd’hui, la Data a un caractère “mystique” pour beaucoup de personnes non initiées, ce qui justifie la prise de certains raccourcis.**
L’un d’entre eux concerne l’application des bonnes pratiques de développement logiciel (ou **Software Craftsmanship**) à la création de Produits Data. Nous savons depuis de nombreuses années qu’afin d’obtenir un haut niveau de qualité dans un logiciel, un certain nombre de bonnes pratiques sont nécessaires : stratégie de tests, revues de code entre pairs, itérations courtes, mise en place de boucles de feedback pour participer à l’amélioration continue, etc. Dans le monde de la Data, nous avons souvent eu tendance à prendre des raccourcis en ce qui concerne ces bonnes pratiques, et c’est encore plus marqué en Data Science.
La question à vous poser :Gérez-vous vos Produits Data comme on gère un logiciel ?
Les entreprises ont déployé beaucoup de temps et d’efforts afin de mettre en place des bonnes pratiques autour de l’agilité, du DevOps, du Software Craftsmanship et du Product Management, mais lorsqu’il s’agit de la Data, toutes ces bases peuvent s’envoler en fumée. S’il est indéniable qu’il existe des particularités qui sont spécifiques à la Data (citons par exemple le côté exploratoire inhérent à la Data Science), il n’est pas nécessaire de réinventer la roue lorsque l’on sait déjà créer des logiciels et produits depuis des années et qu’il suffit alors de créer quelques adaptations plutôt que de retomber dans des tunnels de plusieurs mois.
Encore aujourd’hui, il n’est pas rare de constater un mode de fonctionnement où des Data Scientists travaillent de manière isolée, pour ensuite donner leurs travaux à des Data Engineers afin d’industrialiser le tout. Au-delà du fait que ce mode de fonctionnement ne fasse qu’agrandir des silos, c’est aussi un risque fort d’un point de vue technique.
En effet, que faire si le package utilisé change de version ? Que faire s' il n’est pas compatible avec les environnements de production ? Quid d’une dégradation des performances si l’on doit changer de langage ? Que faire si le temps de calcul est beaucoup trop long pour que le modèle soit utilisé en conditions réelles ?
Il est bien dommage de se rendre compte de ces problématiques seulement après que de longs mois d’exploration aient été dépensés.
Notre recommandation : Gérer la Data comme on gère du logiciel : appliquer les bonnes pratiques du **Software Engineering** en prenant en compte les spécificités de la Data.
Quelle que soit l’étape dans laquelle vous êtes dans votre projet Data, nous vous recommandons de mettre en place des bonnes pratiques issues du monde du développement logiciel. Citons notamment deux bonnes pratiques pour illustrer ce propos :
**Mettre en place une stratégie de tests pour chacun des composants de votre chaîne de traitement**
De la collecte de la donnée au réentraînement automatique d’un modèle, chaque brique doit avoir sa stratégie de tests adaptée.
**Mettre en place des revues de code entre pairs, ainsi que des revues de code croisées**
Faire en sorte que même le code “exploratoire” dans le notebook d’un Data Scientist puisse être relu par un Data Engineer est une bonne pratique permettant de faire en sorte que certains réflexes puissent être mis en place en termes de qualité de code ainsi que de facilité à l’industrialisation. Il en est de même dans le sens inverse, car permettre à un Data Scientist de relire le code des Data Engineers lui permet d’appréhender la complexité de la création de code selon les standards du développement logiciel, et de resserrer l’écart entre les deux mondes.
**Considérer un Produit Data comme du logiciel, c’est se donner les garanties de la création d’un produit dans lequel on peut avoir confiance, qu'il soit résilient et adaptable.** Les spécificités du monde de la Data ne doivent pas faire oublier les acquis de nombreuses années en termes de bonnes pratiques de développement logiciel.
Le DataOps est défini par [Gartner](https://www.gartner.com/en/information-technology/glossary/dataops) comme “une pratique collaborative de gestion des données visant à améliorer la communication, l’intégration et l’automatisation des flux de données entre les gestionnaires et les consommateurs de données au sein d’une organisation”.
Les connaisseurs des méthodologies DevOps y verront beaucoup de parallèles, et c’est bien normal, car le DataOps s’inspire des mêmes principes pour les appliquer aux équipes qui travaillent avec la donnée.
En voici ses principaux enjeux :
- Déploiements continus afin de réduire le délai de mise en production ;
- Tests automatisés pour s’assurer d’obtenir des données de meilleure qualité ;
- Contrôle des métadonnées afin de garantir une meilleure gestion des changements et éviter les erreurs ;
- Monitoring pour le suivi du comportement des données et de l’utilisation du pipeline afin d’identifier plus rapidement les défauts qui doivent être corrigés ;
- Collaboration constante entre les parties prenantes sur les données afin d’assurer une livraison plus rapide des données.
De son côté, le Data Reliability Engineer est tout simplement un SRE (Site Reliability Engineer) qui a un focus tout particulier sur les problématiques spécifiques de la Data citées plus tôt.
Vous l’aurez compris, les approches techniques et méthodologies de développement ont un rôle essentiel dans la quête d’une donnée de confiance. Mais cette quête ne se résout pas que par un volet technique. **En outre, une bonne gouvernance des données est l’un des piliers d’une stratégie Data performante**. Et ce point relève plus de problématiques organisationnelles que techniques.
L’un des pré-requis est d’avoir des personnes au sein de l’organisation qui ont pour responsabilité de gérer et maintenir cette gouvernance. Elles ont souvent une casquette de **Data Manager**, et doivent prioriser les sujets de qualité de la donnée ainsi que poser les définitions et rôles en interne autour du Data Management.
Un autre pré-requis communément admis est de se doter d’un **Data Catalog**, qui permet d’accélérer et de garantir la bonne gestion de ses données et de leurs propriétés.
Enfin, il va sans dire qu’il n’y a pas de bonne gestion et gouvernance de la donnée sans un respect des réglementations en vigueur, notamment la **RGPD** en Europe. D’autres réglementations, comme la _Digital Services Act_ ou la _Digital Markets Act,_ sont sur le point d’arriver et pourraient fortement affecter certains acteurs. Les changements techniques et organisationnels à opérer pour les respecter peuvent s’avérer complexes mais essentiels à mettre en place. Chaque acteur manipulant de la Data a une responsabilité forte dans sa gestion et son exploitation, et se doit d’être pleinement conscient de son impact sur ses utilisateurs et la société au sens large.
Au final, la mise en place effective d’une gouvernance des données n’est pas un simple projet technique, mais plutôt un programme de transformation à l’échelle de l’entreprise, et entre directement dans les prérogatives du Chief Data Officer.
Si vous souhaitez avoir l’ensemble des écueils à portée de main, rien de plus simple ! Vous pouvez [télécharger notre eBook](https://eu1.hubs.ly/H01QVgc0) dédié directement en pdf, ou bien vous le procurer en version imprimée ou Kindle sur [Amazon](https://www.amazon.fr/%C3%89cueils-limitant-limpact-produits-organisations-ebook/dp/B0BFJQP2P9/) !
---
### Voir les équipes Data comme des “vendeuses de services”
Source : https://www.hymaia.com/blog/ecueils-data-voir-les-equipes-data-comme-des-vendeuses-de-services/
Vos équipes Data doivent-elles encore convaincre le business de travailler avec elles ?
Un changement de perspective sur la place de la #data dans l’entreprise est nécessaire ! Le #chiefdataofficer et les équipes Data doivent passer d’un positionnement de “vendeurs de services” à celui de “partenaires privilégiés” du business pour les aider à prendre des décisions par la donnée.
L’objectif est de mettre la #data au cœur des enjeux stratégiques de l’entreprise et rompre le silotage entre les équipes Data et le reste de l’organisation.
Ces principes ne sont pas sans rappeler ceux du #datamesh, qui peut servir de source d’inspiration dans ce changement de paradigme.
Il y a une dizaine d’années, les entreprises étaient majoritairement organisées avec une DSI (Direction des Systèmes d’Information), la plupart du temps vue comme un centre de coûts par le business. Au fur et à mesure du temps, de plus en plus d’acteurs ont adopté une organisation qui **met le produit au cœur de leur stratégie**. Le rôle de CPO (Chief Product Officer) s'est alors largement répandu, au même titre que celui de CTO (Chief Technical Officer).
Directions technique et produit sont dorénavant écoutées par les COMEX, et travaillent ensemble pour réaliser des produits numériques qui répondent à une problématique métier bien identifiée.
En parallèle de ces mutations, la Data est devenue stratégique et de nombreuses organisations ont voulu devenir “**Data Centric**”. Des postes de CDO (Chief Data Officer) se sont créés, et les équipes et directions Data ont commencé à avoir un rôle de plus en plus central.
Tant qu’il s’agissait de mettre en place une plateforme Data et de stocker des données, la DSI pouvait largement prendre en charge cette responsabilité. Mais rapidement il a fallu aller un cran plus loin en **identifiant des Uses Cases business pertinents et en permettant à tous de comprendre la Data** pour prendre des décisions.
**Le positionnement de la Data dans l’entreprise apparaît donc crucial** pour avoir un réel impact global. L’un des écueils les plus souvent rencontrés est de considérer qu’elle doit être soit rattachée à l’IT, soit au business. Les deux situations favorisent malheureusement la naissance de silos. **Ce silotage est un ennemi mortel de l’établissement d’une culture Data pérenne.**
La question à vous poser : Vos équipes Data sont-elles encore obligées de convaincre vos directions business de l’intérêt de travailler avec elles ?
## Cas n°1 : La **Data est rattachée à l’IT**
Dans ce cas de figure, les équipes Data sont très vite labellisées “tech”. En conséquence, les enjeux Data sont mal compris des équipes business, et ces dernières peuvent alors prendre des engagements difficiles à tenir pour les équipes Data.
Une autre conséquence est que les directions business ont alors peu de temps à consacrer aux équipes Data car **la Data n’est pas intégrée dans leurs objectifs stratégiques**. Comme il est difficile de définir des critères de ROI sur les Uses Cases, les équipes Data **agissent alors de manière réactive aux demandes métiers et non de manière proactive**.
## Cas n°2 : L**a Data est rattachée au business**
Si la Data est côté business, les **Uses Cases identifiés seront certes alignés avec les enjeux business**, mais au risque de voir se créer une multitude de POCs (_Proofs Of Concept_) dans lesquelles l\*\*’IT n’est conviée qu’une fois ces derniers lancés\*\*.
Dans ces conditions, le POC aura beaucoup de mal à se convertir en MVP puis en produit, et cela ne se fera certainement pas dans les standards de développement logiciel mises en place dans l’entreprise. L’IT aura le plus grand mal à mettre en production ce POC une fois qu’il lui aura été livré, ainsi qu’à garantir le même niveau de performance dans les modèles prédictifs si d’aventure, il était nécessaire d’explorer d’autres langages ou librairies pour une réelle mise en production.
**Le business trouvera alors l’IT trop lent et, dans le pire des cas, trouvera des solutions pour mettre en production sans eux…**
Un changement de perspective sur la place de la Data dans l’entreprise est donc nécessaire. **Le CDO et les équipes Data doivent passer d’un positionnement de “vendeurs de services” à celui de “partenaires privilégiés” du business pour les aider à prendre des décisions par la donnée.**
Notre recommandation Envisager les équipes Data comme des partenaires privilégiés de chaque direction business, et incorporer des enjeux Data dans leurs objectifs stratégiques.
L’idéal pour ce faire est de vous assurer qu’il y ait une “voix de la Data” au COMEX de l’entreprise. Ainsi faisant, **la Data sera prise en compte dans les objectifs stratégiques de l’entreprise et de chaque direction**.
Mettre la Data au cœur des enjeux stratégiques de l’entreprise et rompre le silotage entre les équipes Data et le reste de l’entreprise sont des principes qui ne sont pas sans rappeler la notion de **Data Mesh**. Si un focus sur ce sujet dépasse le cadre de cet article et fera l’objet d’une prochaine étude dédiée, il peut être intéressant d’en avoir en tête les grandes lignes directrices :
- **Data Ownership By Domain** : la Data doit être gérée et servie par le domaine métier qui la génère ;
- **Data As a Product** : La Data est considérée comme un produit à part entière d’un domaine de l’entreprise et est exploitée par le reste de l’organisation ;
- **Data As a Self Service** : Avoir une infrastructure Data self-service utilisée en tant que plateforme agnostique aux domaines métiers ;
- Mise en place d'une **gouvernance fédérée** autour de la Data.
On comprend alors que la mise en place de ces principes est loin d’être uniquement un shift technologique, et s’apparente davantage à un shift organisationnel et culturel autour de la Data.
L’entreprise passerait alors d’un mode de fonctionnement où les équipes Data tentent de convaincre les autres directions de l’intérêt de travailler avec eux et d’avoir du budget pour créer des Use Cases à forte valeur ajoutée, à un mode de fonctionnement où, _de facto_, **chaque direction a le devoir d’incorporer la Data dans ses réflexions**, que ce soit via de l’acculturation ou bien la réalisation de projets stratégiques.
Si vous souhaitez avoir l’ensemble des écueils à portée de main, rien de plus simple ! Vous pouvez [télécharger notre eBook](https://eu1.hubs.ly/H01QVgc0) dédié directement en pdf, ou bien vous le procurer en version imprimée ou Kindle sur [Amazon](https://www.amazon.fr/%C3%89cueils-limitant-limpact-produits-organisations-ebook/dp/B0BFJQP2P9/) !
---
### GenAI au coeur du Produit et du Business : Takeaways
Source : https://www.hymaia.com/blog/genai-au-coeur-du-produit-et-du-business-takeaways/
Les takeaways de l'Hymaday GenAI : retours de Mirakl, Pernod Ricard, Malt, Nickel et Hymaia.
Cet article résume les enseignements clés de l’Hymaday “GenAI au coeur du Produit et du Business” qui a eu lieu le 24 septembre dernier en collaboration avec Malt, qui mêlait retours d’expérience sur des cas d’usage aussi bien internes qu’externes, dans des contextes et des typologies d’entreprises variées.
Les replays sont petit à petit disponibles sur notre [chaîne Youtube](https://www.youtube.com/playlist?list=PL_h6mFCmTXr9IWz3ksj9Cdj0bpzKufrmP), abonnez-vous pour être averti dès leur sortie !
## Mirakl : Comment gérer en production l’intégration de catalogue at scale - From AI-Assisted Feature to AI Product
_Speakers :_
- _Anne-Claire Baschet - Chief Data & AI Officer_
- _Arthur Delaitre - Manager AI Catalog_
Anne-Claire et Arthur ont partagé leur parcours sur la manière dont ils créent plus de valeur dans le produit Mirakl grâce à l'IA et à la GenAI.
### Étape 1 : AI-Assisted Feature
****Chez Mirakl, l’IA est intégrée dans le produit en développant leurs propres modèles depuis plusieurs années. Ils ont commencé par améliorer leurs fonctionnalités en intégrant l'IA comme un complément, permettant à leurs utilisateurs de simplifier leur expérience — réduisant ainsi les efforts de plusieurs semaines à seulement quelques jours.
### Étape 2 : AI Product
****Avec les possibilités offertes par la GenAI, une question s’est alors posée : “Et si nous réimaginions tout le processus d'intégration des catalogues de vendeurs avec une IA native et la GenAI ?”. Mirakl a transformé cette expérience en un processus en un seul clic, réduisant l'intégration de plusieurs jours à seulement quelques heures, avec une charge de travail considérablement allégée pour leurs vendeurs. La valeur ajoutée et le temps économisé sont donc immenses !

**4 enseignements principaux :**
- Cette expérience en un clic n’a été possible que parce que Mirakl a commencé par le problème, et non par la technologie, ce qui a permis de dépasser l'idée reçue que GenAI = conversationnel = interface de chat.
- Commencez par un "one-shot prompting", testez la performance des modèles de GenAI à grande échelle dès le début, et, en fonction des performances atteignables, concevez l’expérience en une seule équipe (Design, Produit et Data), le tout dans une période limitée pour rapidement confronter les utilisateurs à la solution.
- Ne surchargez pas les fonctionnalités dès le départ. Préférez une longue période de beta avec les utilisateurs pour évaluer la performance, identifier les problèmes et ajuster le produit à travers l’expérience, l’engineering et les algorithmes.
- Ne vous laissez pas bloquer par les coûts. Projetez-les à l’avance et identifiez des moyens de les réduire, comme le fine-tuning de plus petits LLMs, tels que Mistral Nemo ou LLaMA 3.1 (8B/70B).
## Pernod Ricard : Generative AI & Product - Knowledge Management Use Case
_Speaker : Stéphane Texier - Product Manager Tech Data Platform_
Dans ce REX, Stéphane explique comment Pernod Ricard intègre l'IA Générative pour gérer efficacement les connaissances internes, avec un focus particulier sur le HR Knowledge Bot.
Ce bot utilise des modèles de langage avancés (LLM) pour répondre à des questions précises à partir des documents internes, optimisant ainsi la recherche et l'accès aux informations RH.
Stéphane met également en avant l’outil PR GPT, une plateforme privée et sécurisée, offrant des capacités multimodales, allant de la génération de contenu à l'analyse de documents.

**3 Challenges et enseignements clés :**
- **Qualité des données en entrée** : "Garbage in, Garbage out" rappelle que des données de qualité sont essentielles pour obtenir des réponses pertinentes. Un volume important d'informations ne garantit pas une meilleure performance.
- **Tests indispensables** : L'automatisation des tests est possible, mais l'implication d'experts en la matière reste cruciale pour valider le contenu et éviter les erreurs ou hallucinations des modèles.
- **Évolution rapide de la technologie** : La technologie GenAI évolue à un rythme effréné, exigeant un suivi constant pour rester à jour et maintenir l'intégration fluide des solutions d'entreprise.
## Malt : From Hype to Reality: How Malt is using GenAI to revolutionize its user experience
_Speaker : Marc Palyart - ML Director_
Durant ce REX, Marc Palyart explique comment Malt utilise l'IA Générative pour révolutionner l'expérience utilisateur en passant du prototypage à une intégration complète dans ses produits, en l’illustrant via leur “AI Brief Builder”.
Son approche : Fake It (with GenAI) Until You Make It (with almost no GenAI). Marc explique qu’ils ont d’abord démarré par du prototypage 100% basé sur de la GenAI, puis ont petit à petit remplacé la GenAI sur des éléments clés par des plus petits modèles plus spécialisés (par exemple la détection de langage ou la prédiction de Job Category, qui sont critiques).

**Les Do’s et Dont’s qu’il partage :**
- Construire un protocole de test clair dès le départ
- Laisser l’humain contrôler les outputs que la GenAI produit
- Ajouter le plus de guardrails possible
- Ne pas utiliser la GenAI pour le matching
## Nickel : RAG et Search - Deux cas d’usage business chez Nickel
_Speaker : Paul Marcombes - Head of Data_
Paul retrace l’utilisation de la GenAI chez Nickel pour améliorer l’expérience client et les processus internes. Il met en avant une solution simple et gratuite permettant aux utilisateurs de questionner les retours des clients sur des plateformes comme l’App Store ou Trustpilot. Cette approche repose sur des technologies de RAG (retrieval-augmented generation) et la recherche hybride, adaptées à la gestion rapide et efficace des informations pour les équipes.
Paul propose également une démonstration de l’utilisation de GenAI dans la compréhension et l’analyse des retours clients via une app interne créée pour l’occasion.

**Son message essentiel:** Bien séparer la partie moteur de recherche de la partie génération de contenu. Les utilisateurs veulent voir la vraie data !

## Hymaïa : IA Générative - Transformations en cours
_Speakers :_
- _Thibaud Vienne - Lead Data Scientist_
- _Laurène Thenoz - Data Product Manager_
2024 a été une année d'apprentissage intense autour de la GenAI, où on a rapidement compris qu'il ne s'agissait pas simplement de recréer un ChatGPT bis. Les applications les plus courantes impliquent souvent des modèles de fondation (comme OpenAI ou Anthropic), encapsulés dans des applications spécifiques, avec un accent sur le **prompt engineering**. Des techniques comme le **fine-tuning** ou le **RAG** (Retrieval-Augmented Generation) se sont également imposées, permettant d'étendre les capacités des modèles en intégrant des bases de connaissances spécifiques. Viennent maintenant les **Agents**, dont nous entendons de plus en plus parler.
Côté complexité, la GenAI en production apporte des défis uniques, allant des hallucinations aux enjeux de confidentialité des données et à la cybersécurité. Les coûts restent une problématique à anticiper, mais des solutions émergent, comme la **compression des prompts** ou la **gestion du cache** pour limiter les frais liés aux appels aux modèles.
La clé pour tirer profit de la GenAI ? Identifier les bons cas d'usage, s'adapter aux changements de paradigme et ne pas céder à la _Fear of Missing Out_ (FOMO). Même si des obstacles techniques et organisationnels existent, il est essentiel de s'engager dès maintenant pour absorber la courbe d'apprentissage et ne pas être laissé sur le bord de la route quand le marché basculera définitivement vers l’IA.

**Les messages clés à retenir :**
- Le LLM n’est pas le challenge, mais tout ce qu’il y a autour
- Plus on augmente le périmètre, plus on augmente la complexité et les risques
- Appliquer les bonnes pratiques du Software Engineering et du Product Management est critique pour la réussite d’initiatives à base de GenAI
- Adapter le Product Management aux spécificités de la GenAI
- S’inscrire dans une transformation plus grande
---
### La Data n’est pas une fin en soi
Source : https://www.hymaia.com/blog/la-data-nest-pas-une-fin-en-soi/
La Data n'a de valeur que si elle sert un objectif business clair. Arrêtons d'en faire une fin en soi.
Devant ces constats, les entreprises ont dû revoir leur copie dans la gestion de leur patrimoine et de leurs équipes data. **La Data est maintenant entrée dans son ère “industrielle”,** avec une réelle prise de conscience de la nécessité d’une organisation et structuration autour de la donnée, afin d’enfin l’exploiter à son plein potentiel et à l’échelle. Et surtout, de **tirer les projets par la valeur business et non la “sexyness” de tel ou tel algorithme**.
De nombreux enseignements peuvent être tirés de ces dernières années qui ont vu le monde de la data prendre une ampleur sans précédents.
Le premier d’entre eux est que **La Data n’est pas une fin en soi**. Nous faisons face à une réelle **mystification de la data**, où beaucoup de personnes pensent que la data est un monde tellement à part qu’elle ne peut être gérée et exploitée que par des équipes d’experts qui font des choses que le reste du monde ne peut comprendre. Comment alors créer une appropriation et une acculturation des métiers lorsque l’on voit la data comme un monde à part et inaccessible ?
Un autre enseignement fondamental est que **les spécificités de la Data ne doivent pas faire oublier les bases et bonnes pratiques logicielles et produit déjà acquises**. Les entreprises ont en effet déployé beaucoup de temps et d’efforts afin de mettre en place des bonnes pratiques autour de l’**agilité, du DevOps, du Software Craftsmanship et du Product Management**, mais lorsqu’il s’agit de la Data, toutes ces bases peuvent s’envoler en fumée. Il y a certes des particularités qui sont spécifiques à la Data (citons par exemple le côté exploratoire inhérent à la Data Science), mais pourquoi réinventer la roue lorsque l’on sait déjà créer des logiciels et produits depuis des années et qu’il suffit alors de créer quelques adaptations plutôt que d’attendre plusieurs mois avant de se demander comment industrialiser un projet ?
Nous sommes donc convaincus que la Data n’est pas une fin en soi, et qu’**elle doit être mise au service de la raison d’être et des objectifs de l’entreprise, et non l’inverse.** Chaque entreprise a son propre “why”, ses ambitions et ses objectifs business. La Data doit permettre de contribuer à les atteindre et de gagner en impact. Se dire que nous allons magiquement tirer de la valeur de la data en l’explorant est une stratégie ayant peu de chances de réellement aboutir. Nous pensons qu’il ne faut pas inverser le sens des choses. **La valeur à tirer de la data vient directement de leur usage et apport pour le business de l’entreprise.**
Chez Hymaïa, nous sommes tellement convaincus de cela que nous en avons fait une obsession : **notre “why” est tout simplement d’aider nos clients à mettre la Data au service du leur.**
Nous aspirons à ce que la Data soit vue comme une base objective et impartiale sur laquelle l'entreprise s'appuie pour générer de l'**information** et du **savoir** **actionnables**, mais surtout **aider à la prise de décision et à la création de valeur business**.

Et pour cela, trois axes de travail nous semblent fondamentaux et interdépendants:
- S’assurer que les données ne soient pas que des nombres et des flux, mais reflètent bien le business et les utilisateurs ;
- Travailler sur la création et l’industrialisation de Produits Data de haute qualité, **centrés sur la valeur business ;**
- Contribuer à la démocratisation de la Data dans l’entreprise, afin que chaque personne puisse **prendre des décisions informées par la donnée**.
Travailler sur une réelle démocratisation et culture autour de la data nécessite de l’alignement, de la stratégie, de la formation, mais aussi d’acquérir la confiance du plus grand nombre. Et la confiance se gagne en montrant par l’exemple, en créant des Produits Data qui apportent réellement de la valeur et répondent à une problématique business concrète, et qui s’appuient sur des données de confiance et de qualité. Nous sommes convaincus que les équipes et départements data doivent avoir ces objectifs en tête. Un département Data doit donc être composé d’experts de la donnée capables de créer ces produits à haute valeur ajoutée, mais aussi être responsabilisé sur le fait de contribuer à démocratiser l’usage de la data au sein de toute l’entreprise, afin que chacun puisse prendre des décisions informées par la donnée. C’est ce qu’on appelle être **Data Centric**.
Comme si bien dit par l’ancien Head of Data Science d’AirBnb : [**“Data Isn’t Numbers, It’s People”**](https://medium.com/airbnb-engineering/at-airbnb-data-science-belongs-everywhere-917250c6beba)**.** En conclusion, et histoire de se répéter un peu, **la** **Data, ce n’est pas une fin en soi, c’est la “voix de vos utilisateurs”.**
Le monde de la Data est un monde passionnant, qui évolue sans cesse et qui nous réserve encore bien des surprises, c’est ce qui en fait sa beauté. Mais il est grand temps aussi de le démystifier, et d’en faire un accélérateur de notre business et de notre raison d’être d’entreprise.
Si vous vous reconnaissez dans ce discours, nous vous invitons à visiter notre site et le reste de notre blog pour en savoir davantage sur nos convictions et nos passions chez Hymaïa. Et pourquoi pas aller faire un tour sur [nos offres d’emploi](https://www.hymaia.com/nous-recrutons) !
---
### L’acculturation à la data n’est pas un travail unidirectionnel
Source : https://www.hymaia.com/blog/lacculturation-a-la-data-nest-pas-un-travail-unidirectionnel/
Je vous propose de voir l’acculturation à la data comme une quête bidirectionnelle, et non quelque chose à sens unique.
Je travaille dans ce domaine depuis près de 10 ans. Et pourtant, je reste impressionné, parfois apeuré, devant la quantité de nouveautés annoncées par tous ces acteurs de la Data et de l’IA qui publient révolution sur révolution.
Mettons-nous maintenant à la place des personnes ne venant pas de ce monde : Product Owners, Software Engineers, Business Owners, etc. Si en tant qu’acteurs de la data on peut se sentir dépassés, comment imaginez-vous que ces personnes se sentent face à ce domaine ?
Face à ce constat, les entreprises expliquent vouloir créer une **culture data**, et **acculturer les métiers et les stackeholders à la data**.
Mais c’est un chemin difficile, avec de la résistance au changement à la clé.
Mon feeling me dit que cette difficulté est en grande partie due au fait que nous, les data practitioners, essayons de faire adhérer les autres métiers à notre langage, sans réellement chercher à comprendre leurs besoins.
Nous mettons souvent l’accent sur ce qui rend la data si spéciale, plutôt que d’insister sur **ses points communs avec d'autres domaines comme l’Engineering ou le Product Management.**
Je vous propose de voir l’acculturation à la data comme une quête bidirectionnelle, et non quelque chose à sens unique.
L’intérêt ? Que chacun, de part son domaine d’expertise, puisse créer des liens avec les sujets qui leur sont familier, plutôt que de devoir s’approprier de nouveaux concepts éloignés de leur expertise du quotidien.
En trois mots : **Connecting The Dots**.
Voyons cela plus en détails.
## Le problème avec le terme “acculturation”
Même si notre ami Robert définit l’acculturation comme un “_processus par lequel une personne ou un groupe assimile une culture étrangère à la sienne_”, je ne peux m’empêcher de penser que lorsque nous essayons d’“_acculturer les gens à la data_”, il y a une forme de rapport dominant / dominé et sachant / non sachant qui se met en place.
Et c’est là tout le problème.
La réaction naturelle lorsque l’on cherche à vous imposer (ou inculquer) quelque chose est de se mettre sur la défensive pour défendre ses idées, son métier, voire son avenir.
Le problème de l’acculturation à la data : nous cherchons à convaincre, ils cherchent à se défendre.
## N’encourageons pas le caractère mystique de la Data
Il y a fort à parier que les personnes non initiées à la data ne voient ce domaine que par le prisme de ce qui est le plus visible, c’est-à-dire les dernières révolutions publiées par les géants du web et qui impactent le grand public.
Elles n’ont pas le temps de démêler le vrai du faux, et ce n’est pas leur métier.
Elles ne voient que ce qu’on leur montre, et cela ne fait qu’accentuer leur impression initiale, à savoir : “_la data est un monde à part, trop éloigné du mien_”. Pire : “_je ne comprends pas bien ce qu’ils font, mais ça commence à me faire peur_”.
Et ce ne sont pas les dernières avancées autour de l’IA Générative qui vont freiner ces ressentis.
Nous sommes donc en train d’entretenir et d’amplifier jour après jour un décalage entre la data et le reste du monde :
- Les personnes qui ne travaillent pas dans la data tendent à la voir comme un monde complètement différent du leur, composé de nouveaux outils et d’un savoir-faire extrêmement complexe à acquérir si l’on veut s’y intéresser ;
- Celles qui travaillent dans la data tendent à penser qu’ils vivent dans un écosystème à part entière, à qui on dit qu’ils ont “_le métier le plus sexy du siècle_” et qui sont mises dans des équipes et des conditions de travail spéciales. Bonjour l’égo.
Nous en sommes arrivés à un stade où la simple prononciation des mots “Data” ou “IA” fait résonner un côté mystérieux, différent, voire effrayant.
Le choix des mots est donc cruellement important dans l’adhésion que vous susciterez dans votre démarche de créer une culture data à l’échelle de l’entreprise.
Si vous assommez vos interlocuteurs avec des termes qui ne parlent qu’à la communauté data, ou qui sont générateurs de débats et de craintes pour le grand public, il vous sera difficile de susciter l’adhésion et l’engouement auprès de vos interlocuteurs.
Au contraire, si vous parlez de ce qui rassemble tout le monde, si vous partez du besoin de chacun, de ce que vous cherchez à créer et comment on peut y parvenir en joignant les forces de la data et des autres équipes, vos chances de réussite seront plus grandes. A minima, vous aurez une oreille plus attentive.
Apple l’a bien compris et a réussi le tour de force de [ne pas prononcer une seule fois le terme “AI” lors de la dernière WWDC](https://mashable.com/article/apple-avoids-ai-wwdc-2023), préférant employer d’autres tournures pour montrer à quel point la technologie est au service de l’expérience utilisateur, et non l’inverse.
## Utiliser les buzzwords avec parcimonie, et gare aux raccourcis
La Data, c’est un peu buzzword-land.
Je n’ai pas de problème particulier avec ces buzzwords, je ne m’empêche pas de les utiliser d’ailleurs. Ce qui est important, c’est de savoir pour quelle raison on les utilise.
Si le buzzword est employé pour aider la communauté dans la prise de conscience d’une nécessite de changement et d’évolution, alors OK.
Un buzzword comme Data Mesh ou MLOps aide à conscientiser un problème et aide à fédérer un groupe autour d’un but commun.
Tant que l’on maitrise le sens derrière ces mots, tout va bien.
Le problème, c’est que très vite des raccourcis peuvent être pris, et l’on se retrouve vite à oublier la raison pour laquelle le concept a été créé au départ, ainsi que sur quelles bases il s’appuie.
Des personnes se les accaparent et les utilisent dans les mauvais contextes ou approximativement pour renforcer leur crédibilité jusqu’à ce que la signification du buzzword se dénature.
Un buzzword peut entretenir une **_Fear Of Missing Out (FOMO, peur de rater quelque chose)_** et faire faire des choix pour les mauvaises raisons :
- “_Tout le monde investit dans une plateforme MLOps, je devrais peut-être le faire aussi”_
- “_Tout le monde semble s’orienter vers le Data Mesh, il doit y avoir une bonne raison”_
- “_Tout le monde parle de Modern Data Stack, il faut peut-être qu’on fasse évoluer la nôtre”_
Le risque est donc de s’éloigner de l’essentiel, à savoir être conscient du problème que l’on essaye de résoudre au départ dans notre contexte singulier.
## L’impact passe par la collaboration
Et pourtant, force est de constater que les initiatives data sont [encore loin de toutes être couronnées de succès](https://www.hymaia.com/blog/tomber-dans-le-piege-du-poc-infini). Si l’on tend vers une meilleure maturité des initiatives et équipes data, il reste encore énormément de travail pour gagner en impact par la data à l’échelle de nos entreprises.
Quand on nous dit que l’on a le métier le plus sexy du siècle, forcément cela flatte l’égo. On se sent valorisé.
Et puis vient le temps de la réalité du quotidien, où les mises en production sont difficiles, où les données ne sont pas avec le bon niveau de qualité, où les besoins métier sont mal cadrés et où on commence à sérieusement nous demander des comptes sur notre apport de valeur.
Pourquoi tant de difficultés ? Parce que **la data n’est qu’une petite brique dans tout un écosystème d’entreprise.**
La question est donc de savoir comment passer outre ces décalages et vraiment franchir un cap vers la démocratisation de la data en entreprise ?
N’oublions donc pas que l’un des principaux objectifs de l’acculturation à la data est de nous permettre de mieux travailler ensemble. Nous avons besoin les uns des autres pour créer de l’impact.
C’est donc par la collaboration et la compréhension de nos besoins mutuels que l’on pourra générer de la valeur.
Prenons deux exemples assez parlants de sujets du moment : le Data Mesh et le MLOps
## Le Data Mesh : par la data, pour la data
L’objectif du [Data Mesh](https://www.hymaia.com/qu-est-ce-que/data-mesh) est de gagner en impact au sein de l’entreprise grâce à la data, en répondant notamment aux problèmes générés par la centralisation des assets et des équipes qui deviennent un _bottleneck_ dans les entreprises.
La créatrice du concept en parle comme d’un **paradigme socio-technique**, en insistant bien sur le “socio” car **le sujet va bien au-delà d’une transformation technique de ses infrastructures et plateformes Data.** Il impacte de nombreux profils, de nombreuses équipes et doit toucher les instances stratégiques.
Le problème avec le terme “Data Mesh” est qu’il est, comme son nom l’indique, orienté Data.
C’est un concept créé par des gens de la data, qui s’adresse à des gens de la data.
Il devrait cependant, par définition, s’adresser à toute l’entreprise afin de la convaincre de la nécessité d’évoluer pour gagner en impact.
Parler dans un langage data n’aide pas à susciter l’adhésion et l’envie auprès des autres experts.
Combien d’articles mentionnent le fait que le Data Mesh prend racine dans des shifts qui ont déjà été opérés il y a des années dans le domaine du Software, à savoir le **Domain Driven Design** ?
Il est important de savoir reconnaître que l’on s’inspire de ce qui existe déjà et de ce qui a fait ses preuves, pour l’étendre et l’appliquer à son propre contexte et ses spécificités.
## Le MLOps : beaucoup de ML, peu de DevOps
Quand on parle MLOps, à l’heure actuelle, on pense énormément outils. Telle nouvelle stack pour le monitoring du drift des données, tel outil pour déployer automatiquement son pipeline de Machine Learning, etc.
Beaucoup s’accordent à dire que le MLOps est l’extension du DevOps aux spécificités du Machine Learning.
Mais dans ce cas, **embrassons totalement le mouvement DevOps, pas juste ses outils**. Le DevOps a des années de maturité derrière lui, et son pan “culture” est enfin mieux compris et priorisé.
Le DevOps, c’est un ensemble de principes conducteurs, avec maintenant plusieurs années de maturité. Ses acteurs ont compris l’importance des pratiques et de la culture, au-delà des outils.
Côté MLOps, [la balance penche pour le moment très fortement en faveur des outils](https://dshersh.medium.com/too-many-mlops-tools-c590430ba81b).
Or c’est tout l’inverse dont nous aurions besoin : **créer une culture commune de ce qu’on attend d’un software à base de Machine Learning**, et créer des pratiques communes afin de collaborer facilement, créer du software de qualité, et optimiser son cycle de développement.
Les outils ne vous serviront pas à grand chose si vous n’arrivez pas à créer une culture du partage, de collaboration et de confiance entre tous les acteurs nécessaires à la création de valeur par la data.
Cerise sur le gâteau : c’est en sentant que l’on contribue ensemble à créer quelque chose qui dépasse notre personne que l’on peut ressentir un véritable sentiment d’accomplissement de soi.
## Créer une culture Data implique un changement … de la part de tous
Créer un changement culturel implique de toucher le coeur et l’esprit de chacun.
Créer une Culture Data au sein de l’entreprise, ce n’est pas “forcer” les gens à employer notre vocabulaire d’expert.
Au contraire :
- C’est créer des connexions entre les concepts Data et ceux des autres domaines ;
- C’est faire preuve d’empathie envers chacun des acteurs de l’entreprise ;
- C’est comprendre le langage et comprendre le quotidien de chacun ;
- C’est comprendre leurs craintes aussi.
En tant que membres de ce monde merveilleux de la Data, il est de notre responsabilité de le démystifier et de le démocratiser en s’adaptant au contexte de chacun.
Et cela passera par réfléchir à comment mieux collaborer avec nos collègues plutôt que de rester dans notre bulle.
Les entreprises ont cruellement besoin d’améliorer leur culture data. Mais la data a aussi cruellement besoin d’améliorer sa culture business, software et produit.
**La Data, c’est du Software. C’est aussi du Produit. Mais c’est avant tout de la Culture.**
Construisons-la ensemble !
---
### Le Data Mesh: l’importance de la gouvernance des données
Source : https://www.hymaia.com/blog/le-data-mesh-limportance-de-la-gouvernance-des-donnees/
Data Mesh : pourquoi la gouvernance des données est un pilier essentiel de cette approche.
Comme vu dans [le premier volet](https://www.hymaia.com/blog/quest-ce-que-le-data-mesh) de cette série d’articles, le Data Mesh est l’application du DDD à la data en respectant certains principes tels que **Data as a Product**, **Data Ownership by Domain**, **Data as a Self Service**.
Un quatrième pilier qui est tout aussi important pour une mise en place réussie du Data Mesh au sein de l’entreprise est **Federated Computational Governance**. Nous avons décidé de lui consacrer un article pour faciliter sa compréhension.
Le rôle de la gouvernance des données est de nous assurer que nos produits data propagés dans tous les domaines métiers de l’entreprise soient sécurisés, fiables et délivrent de la valeur dans notre système Data Mesh.
Pour beaucoup, les sujets de gouvernance sont synonymes de rigidité et sont souvent confiés à une équipe centrale qui devient rapidement un goulot d’étranglement. De plus, dans un contexte Data Mesh, la complexité est augmentée du fait qu’il y a plusieurs produits data interconnectés dans l’entreprise.
La gouvernance, dans un tel contexte, ne doit pas être réfractaire au changement. Elle doit déléguer la responsabilité de la qualité et de la modélisation des données aux domaines métiers de l’entreprise. Elle doit aussi automatiser le plus possible des vérifications sous forme de normes pour s’assurer de la conformité des produits data. Le Data Mesh appelle ce modèle de gouvernance _Federated Computational Governance._
Ce modèle se base sur 3 principes que nous allons détailler dans les paragraphes suivants :
- Application du _System Thinking_ à la gouvernance ;
- Gouvernance Fédérée (_Federated Computational Governance)_ ;
- Industrialisation du modèle de gouvernance.
## L’application du _System thinking_ à la gouvernance
Le premier principe, le “_System Thinking”_ invite à percevoir l'entreprise non plus comme une somme de composants isolés, mais comme un système interconnecté (le maillage) où les composants interagissent de manière dynamique au fil du temps.
Dans le cas d’une architecture Data Mesh, le système se compose de **quatre éléments clés** : les Produits Data, les fournisseurs de données (“Data Producers”), les consommateurs (“Data Consumers”) ainsi que les équipes chargées de la plateforme data\*\*.\*\*
Un des objectifs de cette vision est de **maintenir l’équilibre entre l’autonomie de chaque domaine et l’interopérabilité globale de la gouvernance au sein de l’entreprise**.
Cet objectif peut être atteint en mettant en place :
- **Deux boucles de feedback** qui utilisent les informations d'observabilité et de découvrabilité des Produits Data. La première boucle “**Négative**” et vise à identifier les Produits Data non utilisés et à garantir qu'ils ne sont pas redondants. La seconde boucle “**Positive**” a pour objectif de garantir l'utilité des produits de données et d'améliorer leur visibilité.
- Des “**métriques à effet de levier**” qui permettent de mesurer la complexité de la maintenance et de l’évolution des Produits Data. Le Product Owner doit suivre ces métriques pour garantir l'utilité et la fiabilité de ses produits.
- 💡 Par exemple, on peut mesurer le temps nécessaire pour faire évoluer un Produit Data ou encore le ratio des évolutions de produits qui ont échoué.
D’autre part, l’objectif de cette vision est de **partir du postulat que la gouvernance est en mouvement perpétuel** (création de nouveaux produits data, suppression des anciens et transformation de l’existant). Ainsi le modèle de gouvernance doit fonctionner avec un changement continu à travers cette méthodologie, sans interrompre l'expérience des consommateurs.
Ainsi, **l’utilisation du Data Mesh a besoin de s’appuyer sur les architectures distribuées et dynamique** composées de plusieurs entités qui communiquent entre elles (peer-to-peer) plutôt que de dépendre d'une équipe centralisée. Cette approche permet une gestion indépendante du cycle de vie de chaque produit de données, tout en favorisant une interconnectivité et une intégration souples entre eux.
Les éléments du système de gouvernance, tels que les points de levier et la boucle de rétroaction décrits précédemment, reposent sur des mécanismes automatisés construits par la plateforme et intégrés dans l'architecture distribuée.
## Gouvernance Fédérée
Le deuxième principe du concept de Data Mesh implique que chaque équipe est responsable d'un domaine spécifique. Elle définit ses propres objectifs mesurables définissant la qualité de service attendue pour son système (\[SLOs\]([https://fr.wikipedia.org/wiki/Service-level\_objectives#:~:text=Les service-level objectives (SLOs,de service et un client.)](https://fr.wikipedia.org/wiki/Service-level_objectives#:~:text=Les%20service%2Dlevel%20objectives%20\(SLOs,de%20service%20et%20un%20client.\)) - Service-Level Objectives)\* et gère ses données de manière indépendante.
Pour que tout fonctionne ensemble, il y a des règles communes pour garantir que les différents domaines puissent interagir entre eux. Le Data Mesh définit les éléments opérationnelles suivantes :
- **Équipe fédérée (_Federated team)_** : une équipe composé de Product Owner par domaine et d’experts (légal, sécurité) ;
- **Guide des valeurs (_Guiding values_) :** des valeurs qui guident la prise de décision et la gestion des produits data ;
- **Normes globale (_Policies_) :** des normes tels que des consignes de sécurité, de conformité, juridiques et d'interopérabilité et normes régissant le maillage ;
- Points de levier **(I\_ncentives\_) :** des points de levier qui équilibrent l'optimisation locale et globale.
### L’**Équipe** fédérée
Le premier élément opérationnel, l’équipe fédérée a pour responsabilité collective de :
- Contribuer à la définition de la gouvernance qui régit les produits (les domaines) ;
- Concevoir l’expérience et prioriser les features de la plateforme et prendre en charge la gouvernance définie ;
Exemple : anonymisation des informations personnelles identifiables \*\*\*\*lors de l'écriture/de la lecture des données, ou mettre en œuvre des API standardisées pour accéder aux informations de découverte de chaque produit de données
- Informer et influencer la hiérarchisation et la conception des fonctionnalités de la plateforme et leur adoption par tous les domaines de données ;
- Faciliter et soutenir le process de gouvernance.
### Guide des valeurs
Le deuxième éléments est le guide qui est définis et gérés collectivement par les équipes au sein de chaque domaine. Il influence les décisions et la résolution des conflits entre les équipes de gouvernance et du produit.
Certaines décisions nécessitent une norme globale pour toutes les équipes.
Règles d’accessibilité de la donnée, de sécurité ou encore de la conformité des données (**Règlement Général sur la Protection des Données - RGPD**)
Aussi la mise en place de règles de standardisation globales permet de faciliter l’interopérabilité du maillage (Produit Data et platform)
Enfin, dans l’organisation Data Mesh, **la responsabilité des décisions et de leur exécution est déléguée** aux personnes qui connaissent le mieux le problème. C’est à dire **localement dans l’équipe produit**, même si une décision est prise au niveau global.
La Data Quality ou l’accessibilité sont gérées par chaque équipe de domaine
### Normes globale
Ces normes, gérées et définies par l’équipe fédérée, peuvent être définis par un ensemble de règles pour gérer la sécurité, l'accessibilité, la qualité et la modélisation des données
Ces règles peuvent être locales, spécifiques à chaque équipe, ou globales, s'appliquant à toutes les équipes de produits de données.
Idéalement, pour minimiser les frictions, **il est préférable de limiter les règles globales et d'automatiser ces règles au niveau de la plateforme** pour les rendre applicables à toutes les équipes Produit Data.
### Points de levier
Concernant ce quatrième élément, il est important de souligner que le Data Mesh ne représente pas simplement un changement technologique mais plutôt une transformation organisationnelle. Un **moyen pour faire face à cette transformation sont les points de levier**. Cela offre deux avantages :
- Le point de levier local permet **d’accélérer et d’autonomiser chaque domaine**. Le point de levier global permet la construction de Produit Data interconnecté plutôt que cloisonnés ;
- Le modèle de gouvernance opérationnel doit créer, monitorer et ajuster en permanence ces points de levier locaux et globaux.
L’effet de levier nécessite une expérimentation et des itérations continues pour fonctionner.
## Industrialisation du modèle de gouvernance
Ce troisième principe a pour objectif d’appliquer des politiques de gouvernance fédérée et automatisée au niveau de chaque produit.
Il existe 4 moyens possibles d’implémentation :
1. **Standards as Code :** C’est un ensemble de règles. Pour le comportement, l’interface ou encore la structure de la donnée. Par exemple une data interface avec une API qui expose la donnée.
2. **Policies as Code :** Il s’agit de compliance, accessibilité, sécurité, … Par exemple rendre les données RGPD accessibles de manière anonymisée afin de maintenir un état de fonctionnement pour les utilisateurs.
3. **Automated Tests :** Mettre en place des tests automatisés, comme l'intégration continue (CI/CD), pour détecter rapidement les erreurs et les corriger dès que possible.
4. **Automated Monitoring** : Maintenir les règles définies en mettant en place un monitoring continu. Par exemple, configurer un système de monitoring avec des vérifications de conformités sur les inficateurs de niveau de service ([SLO](https://fr.wikipedia.org/wiki/Service-level_objectives#:~:text=Les%20service%2Dlevel%20objectives%20\(SLOs,de%20service%20et%20un%20client.\)).
## En conclusion
La gouvernance du Data Mesh vise à améliorer l’approche de la gouvernance des données par l’automatisation et le traitement des données. Il s’agit d’une méthode par laquelle nous définissons et appliquons les bonnes pratiques.
Ainsi comme nous l’avons vu précédemment, le modèle de gouvernance du Data Mesh se compose de 3 piliers qui travaillent en synergie pour créer un écosystème de données agile et interconnecté, tout en décentralisant la responsabilité et en garantissant la qualité et la conformité des Produits Data.
- Le premier est le _System thinking_ dans un écosystème interconnecté de plusieurs Produits Data et de plateforme indépendant mais pourtant avec des équipes désilotées.
- Le second applique la fédération du modèle de gouvernance. D’un point de vue social et organisationnel, cela permet de créer un alignement entre les domaines et les plateforme.
- Enfin le troisième est l’industrialisation du modèle qui permet d’embarquer les règles de gouvernance dans chaque domaine et plateforme.
### Définition
Service-Level Objectives (SLO) : Les objectifs de niveau de services sont des éléments clés de l'accord de niveau de services entre un fournisseur de service et un client.
### Sources pour en savoir plus :
- [https://martinfowler.com/articles/data-monolith-to-mesh.html](https://martinfowler.com/articles/data-monolith-to-mesh.html)
- [https://developer.confluent.io/learn-kafka/data-mesh/intro/](https://developer.confluent.io/learn-kafka/data-mesh/intro/)
- [https://www.amazon.fr/Data-Mesh-Delivering-Data-driven-Value/dp/1492092398](https://www.amazon.fr/Data-Mesh-Delivering-Data-driven-Value/dp/1492092398)
---
### Le Triple Diamant de la Data
Source : https://www.hymaia.com/blog/le-triple-diamant-de-la-data/
Adapter le Double Diamant aux produits Data & IA grâce à un troisième espace dédié à la donnée.
Pour les Product Managers venant du monde du software, la transition vers celui de la Data demande un double ajustement : comprendre un nouvel écosystème, mais aussi adapter la manière de faire du Product Management en elle-même. Les produits orientés Data & IA accusent souvent un retard en matière d’approche produit, ce qui conduit à une mauvaise application, voire à une réinvention, de méthodes de développement produit pourtant bien établies par ailleurs.
Notre objectif ici est de proposer des ajustements permettant d’exploiter pleinement les méthodes actuelles de Product Management dans le cadre de la création de produits Data & IA, de la Discovery au Delivery.
Nous allons pour cela nous concentrer sur l'un des grands standards de la Discovery Produit : le [Double Diamant](https://www.designcouncil.org.uk/). Nous en étudierons les limites et proposerons une version adaptée aux spécificités de la conception de produits Data & IA.
## De l’Idée à la Solution : le Double Diamant en Product Management
Afin de comprendre le cadre dans lequel le Double Diamant est utilisé, penchons nous sur le cadre dans lequel le Product Manager évolue.
Dans son livre “Escaping the build trap”, Melissa Perri définit le but du Product Management comme étant avant tout de réduire l’incertitude en répondant aux questions connues, et en rendant explicites les inconnues encore cachées.
Elle y décrit ce travail comme un processus continu de gestion des connaissances, réparties en quatre catégories :
- les **known knowns** (ce que nous savons - les faits),
- les **unknown knowns** (ce que nous intuitons),
- les **known unknowns** (ce que nous savons ne pas savoir - les questions),
- et les **unknown unknowns** (ce que nous ignorons totalement).
Le Product Manager agit en chef d’orchestre, guidant l’équipe produit à travers ces diverses formes de connaissance pour faire progresser le produit.

Le modèle du Double Diamant, conçu par le British Design Council en 2005, s’aligne parfaitement sur cette vision. Il propose un processus structuré en deux grandes étapes : d’abord l’identification du bon problème à résoudre (**espace Problème**), puis le développement de la solution la mieux adaptée (**espace Solution**).
Ces étapes sont chacune composées d’une phase de **divergence** (exploration) et d’une phase de **convergence** (sélection et affinement).

Le Double Diamant, est un cadre puissant pour structurer la découverte des **unknown unknowns** et la résolution de problèmes (transformer les questions et les intuitions en faits), tout en gérant les incertitudes de manière progressive et éclairée.
## Les Limites du Double Diamant pour les produits Data & IA
Soyons clairs : un produit Data & IA reste un produit comme les autres, avec pour objectif principal de générer de la valeur pour l’utilisateur et l’organisation. **Ce qui le distingue, c’est que la donnée constitue la matière première au cœur de cette création de valeur**, entraînant ainsi des défis spécifiques que le double diamant peine à adresser dans sa version originale. Citons-en deux principaux.
### Defi #1 : Ne pas faire passer la donnée en premier
Le premier défi, souvent observé dans les équipes fortement axées sur la technologie et la donnée, réside dans la tentation de créer un produit uniquement à partir des données disponibles, plutôt que de partir d’un besoin utilisateur clairement identifié. Cette approche peut entraîner une survalorisation de la technologie ou des capacités analytiques, au détriment de la véritable utilité pour l’utilisateur final.
Ainsi, plutôt que de comprendre profondément les problèmes et attentes des utilisateurs, ces équipes risquent de développer des solutions data qui ne répondent pas forcément aux enjeux réels.
Cela conduit alors à ce que Anne-Claire Baschet et Yoann Benoit décrivent comme le [**Data Death Cycle**](https://medium.com/craftingdataproducts/the-data-death-cycle-6b10ef261d8e), où des équipes Data, face à la faible adoption de leurs produits techniques sophistiqués mais déconnectés des besoins du marché, développent des versions de plus en plus complexes, mais toujours plus éloignées des attentes des utilisateurs.

### Défi #2 : Ne pas faire passer la donnée en dernier
Le second défi émerge lorsqu’on applique le processus du Double Diamant sans prendre en compte la réalité des données, notamment leur disponibilité et leur qualité. Dans cette configuration, l’équipe produit avance dans la phase de découverte et de définition des problèmes, puis dans le développement des solutions, sans vérifier si les données nécessaires sont accessibles ou utilisables.
Cette négligence expose l’équipe au risque de découvrir, bien trop tard, que la solution envisagée est techniquement infaisable ou extrêmement complexe à mettre en œuvre en raison de contraintes liées à la donnée. Ce manque de rigueur sur la question des données compromet la viabilité des solutions et peut entraîner un gaspillage de ressources.
### Replacer la donnée au centre du débat, au service du produit
Pour relever ce double défi, il est crucial de considérer la donnée comme un élément central dans la réflexion, mais sans pour autant perdre de vue la problématique utilisateur. En ce sens, il est essentiel de trouver un équilibre entre les besoins du marché et la réalité des données disponibles.
## L’Extension du Double Diamant pour les produits Data & IA : Le Troisième Diamant
Pour les produits Data & IA, il est donc crucial de trouver le bon timing pour étudier et sélectionner la donnée. Il est pour cela pertinent d’enrichir le Double Diamant d’un **troisième espace : l’espace “Data”**.
Ce troisième diamant s’ajoute aux espaces “problème” et “solution” et consiste à intégrer la donnée comme un axe de réflexion à part entière. Le processus devient donc un **Triple Diamant** avec :
1. **L’espace problème** : identifier le bon problème à résoudre.
2. **L’espace solution** : concevoir une solution adaptée au problème identifié.
3. **L’espace data** : évaluer et sélectionner les données pertinentes pour construire la solution.
Cette addition permet de traiter la donnée comme un élément fondamental dans la sélection du problème à résoudre et la solution proposée.
### La place de l'espace Data
Afin de relever les défis spécifiques aux produits data & IA, l’espace Data ne peut être ni en amont de la réflexion sur le problème ni en aval de la définition de la solution. Il est donc pertinent de le considérer en parallèle des espaces problème et solution comme suit :

Tout comme les espaces problème et solution, l’espace data se compose d’une étape de divergence, dédiée à l’exploration et l’évaluation de la donnée et d’une étape de convergence aboutissant à la selection des meilleures données à exploiter.
## Divergence : Explorer et évaluer la donnée, en parallèle de l’Espace Problème
La première étape dans l’espace Data consiste à explorer et évaluer les données disponibles et leur qualité.

Pour cela, nous avons développé un outil simple appelé **Data Map**, qui permet de visualiser clairement :
• Les données disponibles, leur origine, leur qualité et accessibilité.
• Les données manquantes et les opportunités d’acquisition.


Cette phase d’exploration doit se faire en parallèle de la phase de divergence de l’espace problème, car l’étude des données peut :
- Révéler des problématiques non identifiées (découvrir des unknown unknowns);
- Affiner la compréhension des problèmes existants (transformer des questions ou intuitions en faits);
- Écarter des problèmes insolubles faute de données accessibles.

## Convergence : Sélectionner la donnée, en parallèle de l’Espace Solution

Une fois le problème défini, la phase de convergence de l’espace Data permet de sélectionner les données nécessaires à la construction de la solution et d’identifier et prioriser les actions nécessaires pour améliorer leur qualité ou leur accessibilité.
Ce processus affine la **Data Map** pour qu’elle devienne spécifique aux besoins de la solution envisagée.

Elle doit référencer les données et leur état **dans le contexte des besoins du produit**, et identifier les données (disponibles ou non) qui constitueront un avantage concurrentiel.
Cette phase se déroule en parallèle de l’espace solution, car elle permet :
- Lors de la divergence sur les solutions, d’identifier des données clés communes à récolter ou à améliorer en amont. Cette étape pouvant prendre du temps, il est pertinent de l’anticiper.
- Lors de la convergence de l’espace solution, de filtrer sur les données nécessaires et donc de converger sur les données. Réciproquement, l’accessibilité ou non des données permet d’écarter ou de déprioriser certaines solutions.

**_Un Exemple pour mieux comprendre_**
_Prenons l'exemple d’une entreprise de distribution, au sein de laquelle l’équipe Produit souhaite utiliser l’IA pour améliorer l’efficacité de la chaîne d’approvisionnement._
**_Phase 1 : Divergence dans l’espace problème, Divergence dans l’espace Data_**
_En phase de divergence, l’équipe réalise des interviews utilisateurs avec des responsables de la chaîne logistique, analyse des données d’historiques de vente, et mène des journées d’immersion (vis-ma-vie) avec les équipes terrain._
_En parallèle, elle examine un large éventail de données : historiques de vente, délais de livraison, niveaux de stock et retours clients._
_Grâce à la combinaison de ces démarches, plusieurs problèmes sont identifiés : des ruptures de stock fréquentes et des prévisions de demande peu précises, entraînant des pertes de ventes et des coûts supplémentaires._
**_Phase 2 : Convergence dans l’espace problème, Divergence dans l’espace Data_**
_Après avoir cartographié les problèmes, l’équipe se concentre sur l’inexactitude des prévisions de demande (_**_known unknown_**_), confirmée par des analyses approfondies des données actuelles. En analysant les données et les méthodes de calcul utilisées, il devient évident que les prévisions reposent principalement sur des méthodes traditionnelles, sans prendre en compte les tendances saisonnières ni les comportements d’achat récents._
_Le problème prioritaire à résoudre est donc défini : améliorer la précision des prévisions de demande pour réduire les ruptures de stock._
**_Phase 3 : Divergence dans l’espace solution, Convergence dans l’espace Data_**
_Avec le problème défini, l’équipe explore plusieurs solutions, y compris des modèles d’apprentissage automatique qui analysent divers facteurs comme les promotions et les conditions météorologiques. En parallèle, elle examine la fraîcheur et la qualité des données disponibles, s’assurant que les informations utilisées sont à jour et fiables pour alimenter les modèles. L’équipe explore également les interfaces utilisateurs, réalisant des tests utilisateurs pour comprendre comment ils interagissent avec les prévisions._
**_Phase 4 : Convergence dans l’espace solution, Convergence dans l’espace Data_**
_L’équipe Produit évalue les différents modèles d'IA et prototypes d’interface en réalisant des A/B tests et des simulations en conditions réelles. Le compromis optimal est trouvé avec un modèle fiable et une interface utilisateur intuitive, offrant des visualisations claires et des alertes automatisées._
_La solution étant claire, l’équipe peut sélectionner les données effectivement nécessaires à la création de la solution._
_L’équipe établit alors une roadmap des différentes évolutions de la solution, et y intègre les données à récolter ou améliorer afin de sous-tendre la création de chacune de ces étapes._
**_Le rôle crucial du 3ème Diamant_**_:_
- _Si l’équipe Produit avait mené cette réflexion sans tenir compte de l’espace data, elle aurait pu converger vers une solution théorique parfaitement adaptée aux besoins des utilisateurs, mais non viable en pratique. Par exemple, la donnée nécessaire aurait pu être inaccessible ou trop coûteuse._
- _Si l’équipe Produit s’était contentée de la phase de divergence dans l’espace data, sans écarter les données et modèles algorithmiques trop coûteux en termes de ressources au regard de l’appétence de l’utilisateur pour la solution cible, elle aurait risqué de tomber dans un Data Death Cycle. Les data scientists et ingénieurs se seraient alors lancés dans la quête d’un modèle ultra-performant, sans considérer la faisabilité globale et le retour sur investissement du projet._
- _Enfin, sans une phase de divergence menée avec des experts data, l’équipe aurait pu manquer des opportunités de solutions innovantes, telles que des fonctionnalités prédictives, voire prescriptives, à proposer à ses utilisateurs._
## Conclusion
En enrichissant le modèle du Double Diamant avec un troisième espace dédié à la donnée, les équipes Produit sont mieux équipées pour concevoir des solutions viables et adaptées à la réalité des données disponibles. Cette approche n’implique pas de réinventer les méthodes de Product Management, mais plutôt de les adapter aux spécificités des produits Data & IA, en considérant la donnée dès les premières étapes de la conception.
Le Triple Diamant permet de traiter les produits Data & IA de manière structurée, tout comme nous avons appris à le faire avec les produits mobiles, en tenant compte des contraintes spécifiques à la matière première à notre disposition — la donnée — dès le début du processus.

**👉 Pour aller plus loin**
Cet article est extrait des apprentissages proposés dans notre formation “Data & IA Product Manager Confirmé” dont le but est former les Product Managers aux spécificités de la Data et de l’IA et les Data Analysts et Data Scientists au Product Management. Retrouvez plus d’informations [ici](https://www.hymaia.com/formation/devenir-data-ai-product-manager)
La prochaine a lieu les 3 et 4 février 2025, et il reste quelques places !
---
### L’IA Responsable en 8 enjeux majeurs
Source : https://www.hymaia.com/blog/lia-responsable-en-8-enjeux-majeurs/
Interprétabilité, biais, gouvernance, éthique... Les 8 enjeux majeurs pour une IA Responsable.
Cet article a pour objectif de démystifier ce qu’il se cache derrière ce sujet pour pouvoir en mesurer toute son étendue et sa complexité. Nous y aborderons des thématiques comme l’interprétabilité des modèles de Machine Learning, la place de l’humain dans les prises de décision à base d’IA, la gouvernance autour du ML, l’éthique, les biais présents à chaque étape du workflow du ML, la privacité et la sécurité.
Nous vous proposons dans cet article une **catégorisation de l’IA Responsable en 8 principaux enjeux**. Cette structuration se veut la plus représentative possible du sujet, mais ne se vante pas d’être exhaustive dans un domaine aussi mouvant que celui-ci.
_Pour trouver un_ **_tour d’horizon des pilliers de l’IA Responsable mis en avant par les principaux acteurs de l’IA, nous vous invitons à consulter notre article dédié sur le sujet._**

## Enjeu #1 : Interpretability & Trust (Interprétabilité et Confiance)
Les praticiens du Machine Learning ont longtemps été confrontés à un choix complexe à l’heure de décider de l’approche pour résoudre un problème : Interprétabilité (souvent apportée par des modèles plus simples et donc potentiellement moins performants) ou performance (via des modèles plus complexes mais considérés comme des “black-box”) ?
Avec l'essor des [techniques d’interprétabilité des modèles](https://github.com/jphall663/awesome-machine-learning-interpretability), ce choix n’a plus lieu d’être. Il devient de plus en plus simple d’associer des explications à des modèles aux architectures complexes, permettant ainsi de rétablir la confiance dans les prédictions grâce aux explications compréhensibles en termes d’intuition métier.
Ce domaine est en constante évolution et fait régulièrement l’objet de nouvelles publications et avancées. Prendre des décisions éclairées, mais aussi répondre à une demande croissante de transparence de la part des utilisateurs, devient possible grâce à ces techniques.
## Enjeu #2 : Fairness (Équité)
_“Garbage In, Garbage Out”_ dit le dicton célèbre en informatique. Dans le cadre de l’IA Responsable, nous pouvons aller dans le même sens et dire **_“Discrimation In, Discrimination Out_”**.
Les [problématiques liées à l’équité](https://fairmlbook.org/) dans les prédictions d’un modèle de Machine Learning ont bien sûr un lien fort avec le design de ce dernier, ainsi qu’avec les potentiels écarts de performance pour certaines populations. Mais ce que ce dicton veut souligner, c’est que ce sujet est bien plus vaste que l’on ne pourrait le croire.
En effet, la difficulté vient notamment du fait qu’il n’existe pas une même définition standard de l’équité, car c’est un sujet qui touche à des notions allant bien au-delà du Machine Learning, comme la **culture, l’histoire, la politique, l’éthique et bien d’autres encore.**
Les problèmes d’équité **remettent en question l’ensemble de la chaîne de valeur autour de la data**, dès la phase de collecte de données et même en amont par nos biais et stéréotypes comportementaux historiques et jusqu’à ses impacts en aval dans l’utilisation des résultats. En effet, l’extraction de patterns est l’essence même d’un modèle de Machine Learning : si certains stéréotypes ou discriminations historiques sont présents dans la donnée, le modèle les exploitera sans distinction entre une simple extraction de connaissance utile et un pattern discriminatoire.
## Enjeu #3 : Human Centered AI (IA centrée sur l’humain)
Les produits à base d’IA ont un fort potentiel pour le business, mais ils ont aussi un potentiel de risque très élevé lorsqu’ils sont mal dimensionnés ou utilisés à mauvais escient. Les incidents causés par ces produits sont de plus en plus nombreux, tellement nombreux qu’il existe [une base de données des incidents dû à l’intelligence artificielle](https://incidentdatabase.ai/).
Face à ces constats, il devient essentiel de **s’assurer que les** [**humains soient bien dans la boucle**](https://medium.com/vsinghbisen/what-is-human-in-the-loop-machine-learning-why-how-used-in-ai-60c7b44eb2c0) **de prise de décision (_“Human In The Loop_”)**. De même, avoir une réflexion dès les phases initiales d’un projet IA sur les impacts négatifs que pourraient causer des prédictions erronées ou biaisées s’avère primordial, afin entre autres de s’éviter des situations de crise, mais aussi des conséquences néfastes pour certains utilisateurs.
## Enjeu #4 : Security (Sécurité)
Au-delà des problématiques de sécurité relatives à tout type de software, certaines menaces spécifiques au Machine Learning doivent être envisagées avec attention. On peut notamment citer :
- Des **manipulations des données d’entraînement** des modèles ;
- Des **manipulations des prédictions** des modèles ;
- L’**extraction de la logique interne des modèles** ou bien des données d’entraînement ;
- Des **chevaux de troie** cachés dans les logiciels de ML, les modèles ou les données.
Il a en effet été maintes fois prouvé que de simples lignes de données ont la possibilité de faire basculer les prédictions d’un modèle. C’est ce qu’on appelle des [**_adversarial examples_**](https://www.tensorflow.org/tutorials/generative/adversarial_fgsm).
Le sujet de la sécurité des produits à base d’IA est donc vaste et complexe, et inclut des pratiques telles que le contrôle d’accès, l’authentification, les permissions, l’accès à distance ou encore la gestion des données externes, et bien sûr la documentation.
## Enjeu #5 : Compliance & Governance (Conformité et Gouvernance)
La gouvernance des données impacte l’ensemble de l’organisation des entreprises. Elle permet de définir clairement les rôles et les processus internes afin de s’assurer de la bonne traçabilité et gestion de la donnée.
Concernant les projets à base de ML, une réelle gouvernance est donc primordiale afin d’en limiter ses risques potentiels. Il est essentiel de définir **qui est réellement responsable pour les risques liés au ML, pour son audit et pour la gestion de ses incidents**. Il est en effet essentiel d’avoir réfléchi à cette question dès le début d’un projet, afin d’identifier des plans d’action en cas de défaillance du produit.
## Enjeu #6 : Privacy (Confidentialité)
Le domaine de la privacité lié au Machine Learning touche à des sujets aussi bien **légaux** (consentement d’utilisation, obligations légales pour la collecte de données, obligations d’anonymisation, limitations de la durée de stockage d’informations personnelles, droit à l’oubli) que **techniques**, et est un sujet de recherche très actif.
Des techniques comme le [_differential privacy_](http://www.cleverhans.io/privacy/2019/03/26/machine-learning-with-differential-privacy-in-tensorflow.html) ou le [_federated learning_](https://www.tensorflow.org/federated/) offrent des perspectives prometteuses afin de tacler ce sujet mathématiquement parlant.
## Enjeu #7 : ML Workflow Reproducibility & Resilience (Reproductibilité et Résilience dans le workflow de ML)
**Un produit à base de Machine Learning est avant tout un logiciel.** Cela veut donc dire que l’ensemble des bonnes pratiques de développement logiciel, et notamment le **testing**, s’appliquent aussi au ML.
À cela viennent s’ajouter certaines spécificités relatives au Machine Learning qu’il est important de prendre en considération. En particulier le **monitoring en live des modèles** qui est une étape cruciale dans le workflow de ML. Il permet de **mesurer et d’alerter de toute potentielle dérive du modèle dans le temps**, lorsque les caractéristiques de la donnée d’entrée changent petit à petit et rendent les performances du modèle moins bonnes.
Un autre enjeu majeur autour des systèmes de Machine Learning concerne la **reproductibilité des entraînements et des résultats**. Être capable de tracer les différents _artifacts_ ayant permis d’aboutir à un modèle (données, pre-processing, structure du modèle, conditions de déploiement, etc.) est crucial pour être capable de reproduire les résultats en cas de besoin, ou de comparer des résultats.
## Enjeu #8 : Responsabilité Sociale et Environnementale
Dernier pilier et non des moindres, la responsabilité sociale et environnementale est un pan de plus en plus important aux yeux des acteurs de l’IA, ainsi que des utilisateurs finaux.
Comme nous l’avons vu dans la partie sur l’équité, le fait de **réfléchir dès le début à l’impact** que peut avoir un produit à base d’IA sur les comportements et sur la confirmation de certains biais ou stéréotypes est primordial. Il y a une **dimension éthique** de nos développements à prendre en compte en plus de l’impact business.
Les acteurs de l’IA en entreprise ont aussi un rôle important à jouer en ce qui concerne les **craintes d’autres collaborateurs** sur l’impact que peut avoir l’IA sur l’avenir de leur emploi. Un accompagnement et une acculturation sont souvent nécessaires pour éviter des discussions et adoptions difficiles.
Enfin, de[nombreuses études](https://www.technologyreview.com/2019/06/06/239031/training-a-single-ai-model-can-emit-as-much-carbon-as-five-cars-in-their-lifetimes/) montrent l’impact que peut avoir le numérique en termes d’empreinte carbone, et l’Intelligence Artificielle, avec ses entraînements intensifs de modèles de plus en plus complexes et demandeurs en ressources, y joue un rôle clé. Les principes de sobriété numérique s’appliquent donc aussi à l’IA, et des réflexions s’avèrent nécessaires afin d’éviter tout gaspillage inutile.
En conclusion, ce dont nous pouvons être certains, c’est qu’**il est impossible de considérer l’IA Responsable comme un simple sujet à traiter par l’angle technique et mathématique**. Ce sujet touche à l’ensemble de la chaîne de prise de décision et nous force à nous poser des questions difficiles que nous n’aurions pas forcément vues au premier abord. Nous n’en sommes qu’au début de l’histoire, et chaque acteur a une responsabilité pour tendre vers un impact plus positif de l’Intelligence Artificielle au sens large.
**Quelques lectures complémentaires :**
- [Serment Hippocrate Data Scientist](https://dataforgood.fr/projects/4_serment-hippocrate.html)
- [Serment Holberton-Turing pour l’intelligence artificielle](http://www.service-sens.com/le-serment-holberton-turing-pour-lintelligence-artificielle/)
- [Ethique et intelligence artificielle : récit d’une prise de conscience](https://www.lemonde.fr/pixels/article/2018/10/04/ethique-et-intelligence-artificielle-recit-d-une-prise-de-conscience-mondiale_5364508_4408996.html)
- [Data scientist Cathy O’Neil on the cold destructiveness of big data](https://qz.com/819245/data-scientist-cathy-oneil-on-the-cold-destructiveness-of-big-data/)
- [Attacking discrimination with smarter machine learning](http://research.google.com/bigpicture/attacking-discrimination-in-ml/)
- [Will there be a kill switch for AI ?](https://www.forbes.com/sites/cognitiveworld/2020/03/05/will-there-be-a-kill-switch-for-ai/)
---
### L’Intelligence Artificielle selon Luc Julia
Source : https://www.hymaia.com/blog/lintelligence-artificielle-selon-luc-julia/
Interview de Luc Julia, co-créateur de Siri et CSO de Renault, sur sa vision de l’IA.
Le 27 septembre dernier, nous avons interviewé Luc Julia, l’une des plus grandes figures de l’IA et de la tech française et mondiale. Aujourd’hui Chief Scientific Officer au sein du groupe Renault, il est mondialement connu pour être le co-créateur de Siri, l’assistant vocal d’Apple.
Cet article retranscrit cet échange, décomposé en 4 parties :
- La carrière de Luc en quelques chiffres et dates clés
- Ses convictions sur l’Intelligence Artificielle
- Ce que c’est de travailler avec Luc au quotidien
- Sa perception de la place de la France dans la technologie et l’IA
Retrouvez aussi cet échange en [replay vidéo](https://youtu.be/pMTUaAGODlg?si=hylrsep94WgEvB-K) ou bien en format [podcast](https://www.podcastics.com/podcast/episode/0028-lia-selon-luc-julia-co-createur-de-siri-259386/).
## Luc Julia en quelques chiffres et des dates clés
**Vous aimez dire que votre carrière se découpe en tranches de vie de 10 ans, pouvez-vous les résumer succinctement ?**
_10 ans de recherche, 10 ans de startup dans la Silicon Valley et 10 ans de grosse boîte dans la Silicon Valley : HP, Apple et puis Samsung._
_Et depuis 2021, j'ai commencé mes 10 ans de grosse boîte française._
**C'est donc un nouveau cycle qui a démarré, vous comptez vraiment faire 10 ans ?**
_Ah oui, je ferai 10 ans, je fais à chaque fois 10 ans, il n'y a pas de raison !_
**Il y a une date qui vous tient particulièrement à cœur : le 9/9/99 à 9h09, à quoi correspond-elle ?**
_J'étais à la fin de mes années de recherche, et je faisais de la recherche très appliquée, au Stanford Research Institute, dans la Silicon Valley. Et donc le 9 septembre 1999 à 9h09 du matin, on s'était amusé à montrer les 9 projets sur lesquels on avait travaillé pendant les 7 années précédentes._
_C'étaient des projets qui par eux-mêmes pouvaient porter les startups. C'est-à-dire que c'était des petits projets, mais intéressants, que je qualifie de visionnaire pour l’époque. Et donc, effectivement, on a présenté ça à la presse._
_C'étaient des choses comme de la réalité virtuelle ou des assistants vocaux, une voiture intelligente, un frigo intelligent, le tout dans un écosystème où tout se parlait grâce à Internet._
_C'était vraiment une vision d'un monde nouveau, un monde connecté, qui en 1999 n'était pas vraiment le cas : il n'y avait pas de 3G, pas d'Internet autre qu'avec des fils, à peine du Wi-Fi, et pas de GPS. Et nous, on montrait une voiture connectée qui naviguait avec une carte._
**Et certains de ces projets ont été des pierres angulaires pour des startups que vous avez incubées par la suite.**
_On a créé le deuxième incubateur de la Silicon Valley. Le premier avait été créé par Paul Allen, le fondateur de Microsoft, qui avait créé un incubateur qui s'appelait Interval._
_On avait pris le modèle d'Interval avec une petite différence, c'est que Paul Allen avait mis 100 millions de dollars dans l'incubateur, et nous, on en a mis 1. C'était plus modeste, mais plus efficace en fait, car on s'est retrouvés à créer, dans les années 2000, 5 startups, dont 4 ont bien marché. Donc un tatio de 80%, alors que le ratio de Paul Allen était égal à 0._
**Une fois qu’une startup se lançait, elle ne pouvait plus revenir dans votre incubateur. Est-ce cela la clé de leur succès ?**
_Exactement. C'était la différence avec Interval, où il y avait un filet de sauvetage, c'est-à-dire que des mecs très forts, très brillants, partaient dans les boîtes, mais ils étaient plus ou moins motivés, et si ça ne marchait pas, ils pouvaient revenir à Interval._
_Nous, on a fait le même concept, mais sans le filet. C'est-à-dire que s'ils partaient dans la startup, et qu'ils ne réussissaient pas, ils faisaient autre chose, mais ne pouvaient pas revenir._
_C'est pour ça, je pense, qu'on a eu 80% de succès, quand Paul Allen, pour Interval, a eu 0% de succès._
**Cela reflète, finalement, l’esprit de la Silicon Valley que vous appréciez tant ?**
_Oui, il n'y a pas de filet de sécurité. Le risque fait partie de l'innovation, le risque fait partie de l'apprentissage. On apprend en se plantant. C'est comme quand on fait du vélo, on apprend quand on tombe._
_C'est quelque chose qu'on ne comprend pas bien en France. On a peur du risque, on a peur de l'échec. L'échec, ici, c'est rédhibitoire. Après, on vous place dans une petite case : le nul. Là-bas, si vous n'échouez pas, c'est bizarre. Donc, il faut quand même échouer un peu pour réussir._
**Autre date, le 5 octobre 2011, qui est celle de la mort de Steve Jobs. Quel impact cela a eu sur** **la manière dont vous avez travaillé sur Siri ?**
_On a lancé la création de Siri au sein d’Apple le 4 octobre 2011, donc la veille de sa mort. La légende dit qu’il a tenu jusqu'à ce que Siri sorte, parce que c'était son bébé. Et il est mort le lendemain._
_Siri date de 1997, donc c'est loin de 2011, c'est 14 ans avant. Mais personne n'avait bien compris, en fait, Siri. On ne comprenait pas exactement comment l’utiliser._
_Steve Jobs, en 2009, a rencontré la startup derrière Siri, et il a dit “c'est rigolo”, surtout en 2009, deux ans après le lancement de l'iPhone._
_Donc lui, il a bien vu que c'était cet assistant. Et il a vu ça contre tous ses lieutenants, qui n'avaient rien compris, et c'était vraiment lui qui a poussé pour intégrer Siri._
_On était évidemment en mode secret, comme on peut imaginer. Mais c'était très intéressant, on a eu l’opportunité de tout développer de zéro. Il y avait le iCloud, mais ça n'avait rien à voir, on ne pouvait pas faire de compute dessus, alors que pour Siri, il fallait faire du compute dans le cloud._
_On était une quinzaine au départ et on s'est retrouvé à 85. C'était une équipe intéressante qui faisait de tout du cloud au front-end._
**Si je vous dis 15 millions, 80 millions, 300 millions, plusieurs milliards, qu’est-ce que cela vous évoque ?**
_C'est la fierté globalement de faire des produits pour les vrais gens, parce qu'à la fin, c'est ce que j'aime faire. Je fais des produits pour des vrais gens, pour que ça leur serve à quelque chose._
_J'ai commencé quand j'avais 9 ans à faire ma première machine, qui était la machine à faire le lit, c'était pour un “vrai gens”, moi, parce que je n'avais pas envie de faire mon lit. Ça ne marchait pas, mais j'ai fait ce robot, c'était rigolo, donc j'ai commencé comme ça et j’ai continué après._
_Une des startups que j'adore, qui est pour moi le plus beau projet qu'on ait jamais fait et qui était à destination des geeks - je pense qu'on a eu tous les geeks de la Terre qui ont utilisé ce truc-là - et c'était 15 millions de geeks qui l'ont utilisé. C'était dans les années 2000-2005, c'était Orb Networks pour ceux qui l'ont utilisé._
_Après ça je suis rentré chez HP, on a fait des imprimantes connectées dès la première année, pour atteindre 80 millions d'imprimantes connectées vendues._
_Et puis Siri, effectivement, au lancement, 300 millions d'utilisateurs, aujourd’hui 500 millions d'utilisateurs. Et puis après, Samsung, on passe dans une échelle encore supérieure, car ce tous les objets connectés de Samsung qui représentent des milliards d'utilisateurs, effectivement._
**Vous avez finalement navigué entre vos deux amours, qui sont l'IA et l'IoT.**
_Oui, même si pour moi c’est même chose, car finalement l'IoT, c'est quoi ? Ce sont des objets que l'on va connecter à nous, et cette connectivité est compliquée, et donc c'est de l'intelligence artificielle dans le sens où il faut récupérer les signaux humains pour que ces objets communiquent avec nous ou qu'ils communiquent entre eux._
## Parlons IA
**Qu'est-ce qui vous rend optimiste concernant l’IA et pourquoi y a-t-il cette vague actuelle de pessimisme et de peur ?**
_Je suis optimiste parce que je m'éduque sur les capacités de l'IA. Je sais que ses capacités sont limitées. J’appelle d’ailleurs ça de l'Intelligence Augmentée car ces outils augmentent notre intelligence en général, sur les domaines pour lesquels ils viennent nous aider. Ce sont des outils qui viennent nous aider pour des tâches particulières._
_Donc quand on les utilise correctement, je suis optimiste parce que cela augmente effectivement nos capacités. Maintenant, je sais très bien que comme tous les outils, on peut les utiliser à bon escient, mais aussi les utiliser à mauvais escient. Un marteau, je peux l'utiliser pour planter le clou, c'est super, ça marche super bien, c'est mieux que moi, mais je peux l'utiliser pour vous taper sur la tête. Et donc l'outil est potentiellement dangereux, mais pas tout seul, il est dangereux en fonction de comment on l'utilise._
_Ce sont les humains qui sont dangereux, et les humains, il y en a des gentils, il y en a des méchants._
_Donc il faut faire attention et il faut être surtout critique sur ces outils. Ce n'est pas les IA qui sont dangereuses, c'est nous._
**Croyez-vous en la possibilité d’une Artificial General Intelligence ?**
_L’AGI n'existera jamais, c'est très clair pour moi, c'est juste impossible, tout comme la voiture automne niveau 5 n'existera jamais._
_Tous ces sujets qui sont globalement idéaux, qui marchent tout le temps, qui sont extraordinaires, qui sont incroyables ou qui ressemblent à l'humain, ça ne peut pas exister. C'est une sorte de continuum qui n'est pas possible. Les IA sont très performantes dans chacun des domaines pour lesquels on les fabrique._
_Les IA prises une à une en tant qu'outil sont meilleures que nous. Mais élargir le champ avec une seule IA n’est pas possible._
_Si on a à donner une définition pour une intelligence artificielle, ce sera une boîte à outils. Donc il faut que je l'ouvre et que je sorte tous les outils qui sont dedans : le marteau, le tournevis, la scie, qui sont des outils complètement différents et qui, entre eux, n'ont aucun rapport._
**On le voit d'ailleurs dans cette vague actuelle d'IA générative, les choses commencent à se re-spécialiser.**
_Les IA génératives, elles sont un peu spéciales, parce qu'elles sont faites pour être fine-tunées. Cela veut dire qu'on garde quand même la grosse IA qui a été créée et qui n'est pas du tout frugale. Donc malheureusement, il faut ça comme modèle de fondation. Et après, on les fine-tune sur des domaines particuliers._
_Et c'est très bien, parce qu'on parle de pertinences qui sont très faibles au départ : la pertinence d'un ChatGPT 3.5 est de 64%, c'est très faible pour un spécialiste, quel qu'il soit._
_Et effectivement, quand on les fine-tune pour un domaine particulier, là, elles deviennent très pertinentes, elles deviennent incroyables. On retrouve cette histoire de spécialisation et de non-continuum, et donc de fait qu'on ne fera pas de l'AGI avec ça._
**L'IA générative est souvent présentée comme une révolution, mais la révolution n’est-elle pas plutôt côté design, car entre les mains du grand public.**
_C'est effectivement une évolution et non une révolution technique. L'IA existe depuis 1956, il y a eu des paliers, il y a eu des hivers, il y a eu des problèmes, il y a eu des trucs super, des évolutions._
_Il faut être clair, les IA génératives datent de 2017, donc ça fait quand même déjà six ans, cela a évolué par rapport au Machine Learning ou au Deep Learning d'avant, mais c'est toujours data, data, data, beaucoup de données, avec beaucoup de statistiques._
_Mais effectivement, si on parle de révolution dans ChatGPT ou dans MidJourney, il n'y a pas vraiment de révolution de l'IA. Par contre, il y a une révolution de l'interface. La révolution d'un ChatGPT, c'est le Chat.C'est le fait que tout le monde peut utiliser ces outils d'une manière très simple, en juste les interrogeant en langage naturel._
**Vous dites à ce propos que, pour une fois, on ne s'est pas trompé de nom sur la Generative AI ?**
_Oui. En 1956, quand ils ont appelé ça l'Intelligence Artificielle, ils auraient dû appeler ça Machine Learning ou Système Expert, parce qu'il n'y a rien d'intelligent dans l'Intelligence Artificielle, pas au sens humain du terme._
_Pour l'IA Générative, on ne s'est pas trompés, parce qu'on aurait pu appeler ça IA créative. Et ça, ça aurait été une grosse erreur, et ça aurait été aussi difficile à expliquer après aux gens. Ces IA ne vont pas nous remplacer, elles vont nous permettent d'être encore plus performants dans nos travaux, parce que ce sont des IA génératives qui exacerbent notre créativité._
_Moi, je ne sais pas dessiner, je ne sais pas faire des trucs comme ça. Mais si je demande à MidJourney de me dessiner une vache verte sur la tour Eiffel, la créativité est dans la vache verte sur la tour Eiffel. Peut-être que je prendrais une image qui n'était pas exactement l'idée que je m'en faisais, mais la créativité reste de mon côté._
_Les designers qui ont peur d'utiliser ces outils parce qu'ils se pensent que cela les remplacera, il faut se remettre dans le contexte d'il y a une vingtaine d'années, 25 ans, quand Photoshop est arrivé, c'était la même chose._
**Quelle est votre vision des choses sur les futures évolutions de ce domaine ?**
_On en parlait tout à l'heure, le problème de ces IA, c'est qu'elles prennent énormément de data et ne sont pas du tout frugales. Donc on veut spécialiser les modèles._
_Aujourd'hui, on le fait la spécialisation post-fondation. Il va falloir se calmer avec ça, parce qu'on utilise trop de données, trop de ressources. Quand on a des centaines de GPU qui tournent pour créer un modèle pendant des semaines, ce n'est pas durable._
_Donc il va falloir qu'on se démène pour trouver des techniques qui vont nous donner les mêmes performances, mais avec des modèles beaucoup plus petits. Et dès le départ, spécialiser certainement._
_Il faut utiliser certainement beaucoup moins de données, il faut utiliser aussi des techniques qui marchaient bien dans les années 60-70, qui sont les systèmes experts à l'époque, donc tout ce qui compose les IA logiques, qu'on a oubliées aujourd'hui. Il va falloir certainement hybrider tout ça, pour créer des modèles hybrides qui seront certainement beaucoup plus frugaux._
## Travailler avec Luc Julia
**On parle beaucoup du Luc, chercheur, trouveur, mais on ne parle pas beaucoup du Luc manager, leader. Quel type de leader êtes-vous ?**
_Je n'aime pas les grosses équipes, j'aime ne pas être loin du cambouis. Je suis un faiseur avant tout. Bon, je ne suis pas un gars sympa, je pense que si vous parliez à mes gars, ils vont vous dire que je presse un peu, on va dire._
_Mais le seul chiffre qu'on peut donner, c'est le nombre de gens qui, chaque fois que je vais quelque part, viennent avec moi._
_Je ne suis pas dans le show de savoir que c'est moi qui l'ai fait, c’est le collectif, c’est nous. Cela vient certainement du fait que j'étais sportif de haut niveau, et c'est l'esprit du sport aussi, pour moi, c'est une équipe._
**Travaillez-vous avec d’autres profils comme des Product Managers, des designers ?**
_Une de mes caractéristiques, c'est la multidisciplinarité. J'essaie de m'entourer de gens qui ne sont pas comme moi._
_J'ai appris ça il y a très longtemps, pendant que je préparais ma thèse. J’attendais quelqu’un, et sur la table de la bibliothèque, il y avait un livre sur la physiologie du chat._
_Je n’ai aucun intérêt sur les chats, mais je commence à feuilleter ce livre, et je tombe sur la description de la vision du chat. J'étais en train de travaille la perception justement, sur comment les ordinateurs peuvent percevoir des tableaux, en l'occurrence. Et la compréhension que j'ai eue quand j'ai lu l'article, c'était que c'était exactement le contraire de ce que j'étais en train de faire dans mes algorithmes. J'applique ce que j'ai compris de cette vision du chat, et ça multiplie par mille les performances de mon algorithme._
_Et c'est ce jour-là que je me suis dit qu’il y a des choses intéressantes chez les autres.,Et depuis ce jour-là, dans toutes mes équipes, j'essaye de mettre des gens différents. J'essaye de faire faire aux gens des choses qu'ils n'ont pas l'habitude de faire. Et de regarder les choses avec un prisme différent._
_Parce que quand vous regardez les choses avec un prisme différent, vous avez des différentes solutions. Et l'innovation, c'est ça, c'est pas faire ce qu'on fait tous les jours._
## La place de la France dans l'IA et la technologie
**Vous ne cachez pas votre engouement pour la Silicon Valley. Est-ce qu'il faut voir dans votre retour dans un environnement français, un début de vague de retour des têtes pensantes françaises vers la France ?**
_Depuis plus de 10 ans, avec Fleur Pellerin qui a créé la French Tech, avec la BPI, avec toutes ces initiatives qui sont des excellentes initiatives, ça a permis de revitaliser un peu l'écosystème français dans l'entreprenariat, le petit entreprenariat. Et ça, c'est super._
_Je suis pro-French Tech, je suis un ambassadeur de la French Tech dans la Silicon Valley. La France a effectivement à nouveau cette fibre en l'entreprenariat._
_Et c'est vrai qu'il y a des gens de la Silicon Valley qui reviennent. Les gens partent moins aussi, c'est-à-dire qu'ils vont aller faire des stages longs dans la Valley, et puis ils reviennent ici pour justement animer cet écosystème qui est très vivant et très intéressant._
_Je me pose souvent la question de savoir si il y a 30 ans, quand je suis parti aux États-Unis, s'il y avait eu cet écosystème, est-ce que je serais parti ? Et je ne sais pas. Je ne crois pas, en fait._
**Aujourd’hui, c'est facile de créer une entreprise, d'être entrepreneur. Mais qu'est-ce qu’il nous manque pour aller un cran plus loin ?**
_Effectivement, c'est le scale-up qui manque. On a plein de startups, elles sont super, mais on a encore trop peu de licornes, il en faudrait beaucoup plus. Comment on fait du scale-up ? C'est compliqué. C'est une histoire de financement._
_Il y a, dans la Silicon Valley, des Venture Capitalists, des gens sont vraiment des_ **_Capital Riskers_**_. Ici, en Europe, c'est plus compliqué. Ce n'est pas le rôle de la BPI de faire ça._
_Il y a un autre problème aussi que je vois, c'est une impression de ce qu'il se passe : nous n’avons pas de marché européen à proprement parler. Ce soi-disant marché de 400 millions de personnes en Europe, il est complètement fragmenté. Quand je compare avec les États-Unis, avec 300 millions de personnes cette fois-ci, qui ont tout le monde équivalent en taille, il n'y a zéro frontière entre les États, parce qu'entre les États, il n'y a pas de frontière commerciale. Et il y a surtout zéro barrière de la langue. L'accès au marché est d'autant plus simple._
**Vous êtes maintenant dans un grand groupe français, chez Renault. Quel conseil vous pourriez donner à d'autres grands groupes pour franchir une certaine inertie et vraiment accélérer sur des sujets d'innovation ?**
_On a créé à l'intérieur de Renault ce qu’on appelle la Software République, qui est une sorte de startup interne qui crée des startups internes, des projets qui sont managés comme des startups._
_On essaie d'extraire des idées avec d’autres grands groupes, on les mélange avec des startups, et on fait ces projets en mode startup, où les startups viennent nous mettre des coups de pied aux fesses pour faire avancer les choses parce qu'elles, elles n'ont pas le choix, sinon elles vont mourir._
_C'est relativement intéressant parce que quand ils aboutissent, ces projets donnent des joint venture, des choses qui peuvent rentrer aussi dans des business units de ces différents grands groupes, ou alors d'augmenter les startups avec lesquels on travaille._
_Donc il y a plein de business models possibles, mais du coup on fait des projets qui amènent un retour sur investissement intéressant et rapide._
_On essaie de insuffler ce fameux esprit de la Silicon Valley dont on parlait tout à l'heure sur ces projets-là._
**Un grand merci Luc pour votre temps, pour tous ces enseignements, et pour tout ce que vous faites pour la communauté !**
Retrouvez les livres écrits par Luc Julia qui retracent son parcours et ses convictions :
- [L’Intelligence Artificielle n’existe pas](https://www.amazon.fr/Lintelligence-artificielle-nexiste-pas-d%C3%A9construit/dp/2290219525/ref=sr_1_1?__mk_fr_FR=%C3%85M%C3%85%C5%BD%C3%95%C3%91&crid=AEH907JTFLIT&keywords=luc+julia&qid=1699002747&sprefix=luc+julia%2Caps%2C72&sr=8-1)
- [Un Français dans la Silicon Valley](https://www.amazon.fr/Francais-dans-Silicon-Valley-co-cr%C3%A9ateur/dp/2380756996/ref=sr_1_4?__mk_fr_FR=%C3%85M%C3%85%C5%BD%C3%95%C3%91&crid=AEH907JTFLIT&keywords=luc+julia&qid=1699002794&sprefix=luc+julia%2Caps%2C72&sr=8-4)
- [On va droit dans le mur ? Pour sauver la planète, il faut un projet de société et une ambition de civilisation](https://www.amazon.fr/sauver-plan%C3%A8te-soci%C3%A9t%C3%A9-ambition-civilisation/dp/241207867X/ref=sr_1_3?__mk_fr_FR=%C3%85M%C3%85%C5%BD%C3%95%C3%91&crid=AEH907JTFLIT&keywords=luc+julia&qid=1699002794&sprefix=luc+julia%2Caps%2C72&sr=8-3)
---
### LLM & IA Générative - La Voie de la Raison
Source : https://www.hymaia.com/blog/llm-ia-generative-la-voie-de-la-raison/
Notre livre sur les LLM et l'IA Générative : enjeux, retours d'expérience et conseils pratiques.
Ces dernières années, des technologies comme les NFTs et la réalité virtuelle ont promis de transformer l'informatique et la société. Malgré des investissements majeurs, leurs résultats ont été plutôt mitigés.
Cependant, **aucune technologie n’a suscité autant d’intérêt et de débat que l’Intelligence Artificielle Générative**.
Ce phénomène est compréhensible. Peu de technologies ont suscité autant d’enthousiasme tout en présentant des défis aussi uniques. Ces modèles, parfois impressionnants mais parfois défaillants dans des tâches simples, apportent à la fois des **opportunités inédites pour la productivité et les services**, mais aussi des **questions cruciales sur les aspects stratégiques, techniques et éthiques**.
Pour les entreprises, l’IA Générative, comme toute technologie disruptive, peut révéler des besoins insoupçonnés ou cachés. Vous pourriez être amené à adapter vos produits aux attentes des utilisateurs qui vont bientôt considérer ces outils comme la norme, à réinventer des processus anciens ou à affronter de nouveaux concurrents. Vos décisions (ou leur absence) peuvent donc influencer profondément votre avenir, créer une valeur importante pour vos utilisateurs ou, au contraire, les impacter très négativement.
**Développer un produit dont l’IA Générative est au coeur de l’apport de valeur est un défi complexe qui exige une compréhension approfondie des enjeux et des risques, ainsi que des compétences spécialisées**. C’est pourquoi certains produits connaissent aujourd’hui un succès indéniable, apportant une valeur immense aux utilisateurs, tandis que de nombreux autres échouent.
Nous avons donc décidé de consacrer un livre entier à ce domaine qui nous passionne tant et qui nous interpelle régulièrement. Nous y partageons les résultats de nos réflexions, de notre expérience pratique et de nos recherches, ainsi que les questions que nous nous posons et celles que l’on nous pose.
Mais surtout, nous encourageons les lecteurs à se faire leur propre opinion en explorant, testant et découvrant les outils et technologies. Comme dans tout domaine informatique, il n’y a pas de solution miracle ni de vérité universelle : chaque avantage et chaque risque doivent être évalués en fonction de vos besoins spécifiques.
Nous sommes par ailleurs fiers de compter **Emmanuel Martin-Chave, VP Data de BlaBlaCar**, parmi les contributeurs, auteur de la préface de ce livre
[Acheter le livre sur amazon](https://www.amazon.fr/LLM-IA-G%C3%A9n%C3%A9rative-voie-raison/dp/B0DF5SC77P?__mk_fr_FR=%C3%85M%C3%85%C5%BD%C3%95%C3%91&crid=ZNM0CPSZ0AH&dib=eyJ2IjoiMSJ9.IVT33KLhb3hhKjbukvkdqyXKLn7nPD4ppGC3N9ndoM3h-e9dMFewc5gP01Selx7nF0mrzmrgcL73cRMRDB5YE31FXP16iIHuBRCHEAK8bSR1M_hfmg4_P7VwHVAFyLC0sQVvJOMHhO3VzP8Y7dQr_slKaBt93LH0Qk3Ef_vnKhXnjFstPNZgs80sd8WJZ_1UoWmtu3eR36PVux2f5FSWfu-7-2DmzjAqvh1LY14RpsqeXtq9Knto7wl1nS8DKXZK3bVDwL5J2tOL-1PRP70pwk6XauyADoOOz_O0vucq4Zs.I3axJAnUDHI_63RNDygFzpOLkjQZ78YqHBfooAbTdU0&dib_tag=se&keywords=gen+ia&qid=1728466452&sprefix=gen+ia%2Caps%2C63&sr=8-1)
[Télécharger l'ebook](#whitepapers-form-LLM)
## Pour aller plus loin: Formation Generative AI & LLM
Cette formation s'adresse à un public souhaitant acquérir les connaissances nécessaires pour comprendre et mettre en œuvre les Large Language Models (LLM).
Les participants auront l'occasion d'approfondir leur compréhension des différents aspects des Large Language Models, tels que :
- Leur fonctionnement
- Les applications pratiques
- Les stratégies d’amélioration et personnalisation des résultats de l’inférence
- Le développement d’un service de RAG (Retrieval Augmented Generation) via LangChain
Pour en savoir plus : [https://www.hymaia.com/formation/generative-ai-llm](https://www.hymaia.com/formation/generative-ai-llm)
## Replays de la conférence GenAI au coeur du Produit et du Business
Retrouvez les replays des talks de l’Hymaday “**GenAI au coeur du Produit et du Business**” qui a eu lieu le 24 septembre dernier en collaboration avec Malt, qui mêlait retours d’expérience sur des cas d’usage aussi bien internes qu’externes, dans des contextes et des typologies d’entreprises variées.
Parmi les retours d’expérience :
- **Mirakl** : Comment gérer en production l’intégration de catalogue at scale - From AI-Assisted Feature to AI Product
- **Pernod Ricard** : Generative AI & Product - Knowledge Management Use Case
- **Malt** : From Hype to Reality: How Malt is using GenAI to revolutionize its user experience
- **Nickel** : RAG et Search - Deux cas d’usage business chez Nickel
- **Hymaïa** : IA Générative - Transformations en cours
Les replays sont disponibles sur notre [**_chaîne Youtube_**](https://www.youtube.com/playlist?list=PL_h6mFCmTXr9IWz3ksj9Cdj0bpzKufrmP), abonnez-vous pour être averti des nouvelles sorties !
Retrouvez aussi le résumé de ces talks sur notre [article dédié](https://www.hymaia.com/blog/genai-au-coeur-du-produit-et-du-business-takeaways).
## **Sources citées dans le livre et ressources utiles pour aller plus loin**
### **Partie I - Avant de Commencer :** l’IA Générative en 9 grandes questions
- [Interview de Luc Julia, créateur originel de Siri](https://www.youtube.com/watch?v=pMTUaAGODlg)
- [DPD is the "worst delivery firm in the world" according to DPD's service chatbot](https://the-decoder.com/dpd-is-the-worst-delivery-firm-in-the-world-according-to-dpds-service-chatbot/)
- [Air Canada must honor refund policy invented by airline’s chatbot](https://arstechnica.com/tech-policy/2024/02/air-canada-must-honor-refund-policy-invented-by-airlines-chatbot/)
- [Figma pulls AI tool after criticism that it ripped off Apple’s design](https://www.theverge.com/2024/7/2/24190823/figma-ai-tool-apple-weather-app-copy)
- [Comprendre les implications du règlement européen sur l’AI ("AI Act") pour votre entreprise](https://www.hymaia.com/formation/comprendre-ai-act)
- [Artificial Intelligence Index Report 2023: Introduction to the AI Index Report (2023), Stanford University](https://www.slideshare.net/slideshow/the-ai-index-2023-annual-report-by-stanford-universitypdf/262720206#121)
- [The climate cost of the AI revolution](https://limited.systems/articles/climate-cost-of-ai-revolution/)
- [Gen AI’s Environmental Ledger: A Closer Look at the Carbon Footprint of ChatGPT](https://piktochart.com/blog/carbon-footprint-of-chatgpt/)
- [Founder series: Dario Amodei CEO & Co-Founder Anthropic & Elad Gil ENTR, Investor, Startup Helper](https://www.youtube.com/watch?v=l_c4Yr3e4B0)
### **Partie II - Développement de la solution technique - Le build d’un produit d’IA Générative**
- [LLMs: Embeddings and Vector Search](https://sreent.medium.com/llms-embeddings-and-vector-search-d4bd9362df56)
- [AWS: Create an agent for your application](https://docs.aws.amazon.com/bedrock/latest/userguide/agents-create.html)
- [Prompt Engineering Guide](https://www.promptingguide.ai/fr)
- [Few-shot Fine-tuning vs. In-context Learning: A Fair Comparison and Evaluation](https://blog.athina.ai/few-shot-fine-tuning-vs.-in-context-learning-a-fair-comparison-and-evaluation)
- [Introducing the next generation of Claude](https://www.anthropic.com/news/claude-3-family)
- [HuggingFace: Open LLM Leaderboard](https://huggingface.co/open-llm-leaderboard)
### Partie III - **Déploiement de la solution technique - Le run, maintenance et suivi d’un Produit d’IA Générative**
- [Driver tricks chatbot into selling car for USD 1](https://www.aiaaic.org/aiaaic-repository/ai-algorithmic-and-automation-incidents/driver-persuades-chatbot-to-sell-car-for-usd-1)
- [LangChain: Tracing](https://docs.smith.langchain.com/concepts/tracing)
---
### MLOps : les principes du DevOps appliqués au Machine Learning
Source : https://www.hymaia.com/blog/mlops-les-principes-du-devops-appliques-au-machine-learning/
Le MLOps décrypté : appliquer les principes du DevOps au Machine Learning pour industrialiser vos modèles.
## Le constat : le grand écart entre le POC et le produit Data Science industrialisé
De nombreux chiffres ont été publiés et font du bruit sur le taux de projets data qui échouent à aller en production et ne dépassent pas le stade du POC :
- Un rapport de [VentureBeat AI](https://venturebeat.com/2019/07/19/why-do-87-of-data-science-projects-never-make-it-into-production/) explique que 87% des projets Data Science ne vont pas en production ;
- [Gartner](https://blogs.gartner.com/andrew_white/2019/01/03/our-top-data-and-analytics-predicts-for-2019/) estimait en 2019 que 80% des projets d’IA de 2020 allaient rester à l’état de POC, menés par des “sorciers” dont les talents ne sont pas compatibles avec un passage à l’échelle de l’organisation ;
- Ce même rapport Gartner estime que seulement 20% des insights d’analytics vont réellement délivrer de la valeur en 2022.
En voici quelques causes.
### Des problèmes d’industrialisation
Il y a en effet toujours une réelle difficulté rencontrée par les entreprises afin d’industrialiser efficacement et rapidement leurs projets d’IA, qui ne vont donc pas au-delà de la phase de Proof Of Concept (POC).
A titre d’exemple, les modèles de Machine Learning sont régulièrement construits en s’appuyant sur un grand nombre de logiciels et projets open source, dont le respect de la version utilisée entre le POC et la production est primordial et peut vite devenir un calvaire sans une réelle méthodologie, voire un danger si un changement de version affecte le comportement du modèle et l’amène à faire de mauvaises prédictions. De même, la stack technique utilisée en POC est parfois difficile à reproduire à l’identique en environnement de production.
### Des objectifs business mal définis
Au-delà des aspects purement techniques, le risque d’avoir des objectifs business peu ou mal définis en amont est une porte ouverte à des objectifs changeants ou une solution peu adaptée pour la problématique des utilisateurs.
### Des problèmes de passage à l’échelle
Réussir à mettre en production un modèle de Machine Learning semble donc déjà être un accomplissement en soi. Mais ce n’est en réalité que le début de l’histoire !
Il y a en effet tout le **cycle de vie de ce modèle** qu’il va falloir gérer. Quand le réentraîner avec des données plus fraîches ? Que faire si ses performances se dégradent ? Comment savoir qu’il continue de m’apporter de la valeur ? Comment faire si je veux le remplacer par une nouvelle version ?
Mais au-delà de cela, il y a le fait d’être capable de passer d’un seul modèle en production à plusieurs dizaines voir centaines. S’il peut sembler gérable de suivre dans le temps un ou quelques modèles mis en production, devoir gérer toute une flotte de modèles sans aucune automatisation pourrait vite devenir mission impossible, voire mission très dangereuse ! Nous reviendrons sur les principales raisons à cela plus loin dans l’article.
## L’existant : les méthodologies DevOps
Ces constats ne sont pas sans rappeler les difficultés régulièrement rencontrées dans le monde du développement logiciel et du Software Craftsmanship. Et c’est pour cela qu’existent les pratiques du **DevOps**, un mouvement ayant pour objectif de supprimer les barrières entre les équipes d’Opérations et les équipes de Développement.
### Les grands principes du DevOps
Le DevOps est composé d’un ensemble de pratiques techniques et d’organisation ayant pour objectif d’augmenter la vélocité d’une entreprise à livrer du logiciel de haute qualité, de manière fiable, sécurisée et adaptable à l’échelle.
Les grands principes du DevOps peuvent classiquement se résumer via l’acronyme CALMS :
- **Culture** - _les pratiques DevOps impliquent un changement culturel et organisationnel, notamment au travers de la collaboration, la communication et l’agilité._
- **Automatisation** - _Automatiser tout ce qui doit l’être (notamment via de la Continuous Integration & Continuous Delivery)_
- **Lean** - _Rationalisation des processus, afin d’optimiser et fluidifier l’ensemble de la chaîne de livraison (vous pouvez vous en référer au principe du_ [_razoir d’Ockham_](https://fr.wikipedia.org/wiki/Rasoir_d%27Ockham) _pour aller plus loin)_
- **Measurement** - _Afin de suivre un principe d’amélioration continue, tout doit être mesurable afin de prendre des décisions, et pivoter si besoin (se référer à la notion de_ [_Kaizen_](http://christian.hohmann.free.fr/index.php/lean-entreprise/lean-management/289-kaizen-amelioration-continue) _pour aller plus loin)_
- **Sharing** - _Aligner toutes les parties prenantes sur les mêmes objectifs afin de pousser dans la même direction_
Afin d’alimenter tous ces principes, de nombreuses pratiques sont régulièrement mises en place : Continuous Integratin & Continous Delivery, Infrastructure As Code, Monitoring & Observabilité, microservices, etc.
### Un air de famille qui peut aider…
Lever les barrières techniques pour gérer efficacement les livraisons logicielles à l’échelle de l’entreprise, ainsi que les barrières de communication afin que toutes les équipes poussent dans la même direction, voilà ce dont nous avons aussi grandement besoin pour le Machine Learning !
Sur de nombreux aspects, les méthodologies DevOps devraient donc permettre d’aider à lever les barrières à l’industrialisation et au déploiement à l’échelle de projets de Machine Learning.
### … mais plus “cousin éloigné” que “frère jumeau”
Oui … mais … ce n’est pas tout à fait suffisant. Si les méthodologies DevOps ne sont pas immédiatement transposables aux équipes Data Science, c’est parce qu’il existe quelques différences fondamentales entre le déploiement de code et le déploiement de modèles de Machine Learning en production.
La première d’entre elles est qu’**en Machine Learning, le code n’est pas la seule chose qui change et qui doit être versionné** : les données, les hyperparamètres, les métadonnées (ainsi que le modèle en lui-même qu’il faut bien mettre quelque part) doivent l’être aussi afin d’assurer une reproductibilité des résultats.
Deuxième différence majeure : le **monitoring**. En effet, **un logiciel n’est pas censé se dégrader dans le temps (enfin, en théorie), alors que ce sera très probablement le cas concernant les performances d’un modèle de Machine Learning**. Un modèle déployé en production a été entraîné sur un set spécifique de données. Mais ces données continuent d’évoluer dans le temps (reflet des comportements des utilisateurs qui peuvent évoluer par exemple), ce qui résultera en une dégradation des performances du modèle qui continuera d’effectuer des prédictions basées sur les anciens patterns qu’il a appris.
## La solution : MLOps = ML + Dev + Ops
### Une définition du MLOps
C’est donc là que le terme MLOps entre en jeu et prend toute son importance. Basé sur tout ce que l’on vient de se dire, on peut alors définir le **MLOps comme le processus d’automatisation du Machine Learning en utilisant les méthodologies DevOps.**
L’objectif du MLOps est donc de faire en sorte que le déploiement et la gestion en production des modèles de Machine Learning se fassent de la manière la plus simple, efficace, fiable et automatisée que possible.

### MLOps et le double mur de la confusion
Cependant, le terme peut de notre point de vue porter à confusion. En effet, le terme DevOps désigne le fait de briser le mur souvent existant entre les équipes de Dev et les équipes Ops. En appliquant cette même logique à MLOps, on pourrait penser que le but est de briser le mur qui se dresse entre les équipes de ML et les équipes Ops. Et c’est en partie vrai.
Sauf que, étant donné que très souvent, les Data Scientists sont (au moins en partie) déconnectés des équipes de Dev & Data Engineering, ce n’est pas un, mais deux murs qu’il faut savoir briser : celui entre ML et Dev ET celui entre Dev et Ops. La tâche s’avère donc encore plus ardue, car il devient nécessaire de faire communiquer beaucoup plus d’interlocuteurs aux backgrounds différents !

### Les grands principes du MLOps
En se concentrant sur les spécificités inhérentes au MLOps par-dessus les principes DevOps, nous pouvons référencer 5 piliers fondamentaux : reproductibilité, déploiement, monitoring, gestion du cycle de vie et gouvernance.
#### Développement de modèles & Reproductibilité
Les Data Scientists doivent être capables de **reproduire leurs expérimentations**, que ce soit pour en construire de nouvelles par-dessus, ou bien pour qu’un environnement de production soit capable de la refaire automatiquement. La reproductibilité concerne les configurations qui ont amené à tel ou tel modèle entraîné, mais aussi l’environnement nécessaire pour le faire (ex: versions des packages utilisés).
Tout ceci passe donc par un **versionning** adapté, qui va au-delà du versionning du code : versionning de la donnée d’entraînement, des hyperparamètres du modèle et autres métadonnées.
#### Mise en production et déploiement de modèles
Être capable de reproduire les conditions d’entraînement d’un modèle est une chose, mais être capable de **créer les bonnes conditions de son déploiement et utilisation en production** en est une autre.
En effet, beaucoup de questions sont à considérer et débattre sur la bonne manière d’utiliser un modèle : quelles sont les restrictions nécessaires pour s’assurer qu’il soit utilisé à bon escient ? Sera-t-il utilisé en batch ou en streaming ? Faut-il l’envisager sous forme de Model-As-A-Service (via une API notamment) ou bien directement incorporé dans un produit ? Faut-il le convertir dans un format interopérable entre plusieurs environnements (cf des projets comme [ONNX](https://onnx.ai/) par exemple) ? Autant de questions qui nécessitent une vraie entente et collaboration en amont entre les différents acteurs.
#### Monitoring
Le monitoring et l’observabilité ne sont pas spécifiques au MLOps, et toutes les métriques classiquement monitorées dans le développement logiciel classique (entendre: sans ML) doivent aussi l’être dans un contexte MLOps. Après tout, **un produit à base de ML reste un logiciel, et doit être traité comme tel**.
Cependant, d’autres informations doivent être monitorées en continu. La **performance du modèle** est bien entendu un élément essentiel à mesurer afin de vérifier toute éventuelle détérioration des performances visées et agir dessus.
Mais ce n’est pas la seule spécificité. Il est en effet notamment primordial de monitorer chaque étape de transformation des données, à commencer par les données d’entrée elles-même, afin d’être alerté de toute déviance dans les distributions de données par rapport aux conditions d’entraînement du modèle. C’est ce qu’on appelle le **_data drift_.** Ces déviances peuvent être dues à des erreurs (mauvaises conversions d’unités par exemple), ou bien tout simplement être le reflet de changement de comportements d’utilisateurs.
#### Gestion du cycle de vie des modèles
Déployer un modèle en production est certainement une belle étape de franchie, mais ce n’est certainement pas la dernière. **Le cycle de vie d’un modèle est fortement itératif.** Les Data Scientists vont notamment vouloir déployer de nouvelles versions de ce modèle régulièrement, soit parce qu’ils y ont apporté des modifications qui pourraient améliorer ses performances, soit parce qu’il a été nécessaire de ré-entraîner ce même modèle sur des données plus récentes.
Ce dernier point peut d’ailleurs être géré automatiquement, mais doit être soumis à une forte rigueur. On ne peut pas en effet simplement remplacer un ancien modèle par un plus récent sans prendre quelques précautions (via des pratiques de blue-green deployment ou de canary deployment par exemple).
**Au final, ré-entraîner et déployer automatiquement une nouvelle version d’un modèle de Machine learning doit pouvoir se faire avec le moins d’effort possible.**
#### Gouvernance
La gouvernance autour de l’IA est souvent un aspect négligé, mais est pourtant un élément fondamental pour une entreprise souhaitant gérer du Machine Learning à l’échelle, et a un impact fort sur la manière dont on va dimensionner et gérer la mise en production des modèles.
On l’aura compris, un projet incorporant du Machine Learning est un projet impliquant énormément de rôles différents, bien au-delà du Data Scientist. Et il est nécessaire de s’organiser et d’**avoir une réelle gouvernance d’entreprise afin de gérer les aspects business, légaux et éthiques autour de la gestion de l’Intelligence Artificielle**. La gestion des risques et des responsabilités en cas de problème causé par un produit incorporant de l’IA doit être **pensée en amont** avant qu’un éventuel problème n’arrive afin de ne pas être dans le gestion de l’urgence.
Comment gérer un rollback en cas de défaillance d’un modèle ? Que faire si on se rend compte a posteriori que certains résultats d’un modèle sont discriminants envers telle ou telle population ? Quels sont les risques financiers associés à ce projet en cas de mauvaises prédictions ?
S’il est déjà dangereux de ne pas se poser ces questions lors de la mise en production de son premier modèle, imaginez lorsque vous devez en gérer des dizaines, centaines voire milliers.
## Conclusion : Le MLOps n’est pas qu’une histoire d’outils, ce sont avant tout des comportements
Un logiciel à base de Machine Learning reste un logiciel, et toutes les bonnes pratiques de développement qui l’entourent doivent donc s’appliquer aussi. Avec quelques subtilités supplémentaires liées au monde particulier de la data.
Experts métier, Data Scientists, Data Engineers, Développeurs, Architectes, équipes d’Opérations, Product Managers : tout le monde est concerné par une démarche MLOps.
L’un des piliers du DevOps est de garantir une meilleure collaboration entre les différents acteurs dans le développement logiciel, et il en est de même pour le MLOps, peut-être avec encore plus d’interlocuteurs aux intérêts et backgrounds différents.
Le MLOps est donc avant tout un ensemble de comportements et une réelle stratégie d’entreprise afin de gérer de manière fiable et sécurisée la gestion de ses projets de Machine Learning à l’échelle.
A vos modèles, prêts ? Déployez !
Quelques lectures complémentaires sur le sujet :
- [OReilly - Introducing MLOps](https://www.oreilly.com/library/view/introducing-mlops/9781492083283/)
- [OReilly - Practical MLOps](https://www.oreilly.com/library/view/practical-mlops/9781098103002/)
---
### Optimiser son job Spark
Source : https://www.hymaia.com/blog/optimiser-son-job-spark/
10 pistes concrètes pour réduire le temps d'exécution de votre job Spark.
## Réduire le temps d’exécution de son job Spark
Optimiser un job Spark est une discipline entre la science et l’art. La science car on peut suivre une méthodologie bien définie, l’art parce que pour quiconque a ouvert une Spark UI… on s’accordera à dire qu’on se sent un peu comme dans Guernica !
## Le problème
Avant de commencer à optimiser son job Spark, il faut définir notre problème : qu’est-ce qui ne nous convient pas dans l’exécution actuelle ? Les problèmes les plus courants sont :
- Temps d’exécution trop long
- Trop de ressources consommées, on arrive au max de l’infra à disposition
- Erreurs d’OOM (Out Of Memory) trop fréquents
## Les solutions
Une fois qu’on a défini son problème, on peut lister les actions possibles et les prioriser. Mon conseil, commencer par le plus simple et continuer tant que l’objectif n’est pas rempli. La définition de “plus simple” est très subjective et dépend de l’expérience de la personne qui réalisera l’action. Par exemple, je n’ai encore jamais exploré la fonctionnalité de `checkpoint` dans Spark. Je classerais donc cette solution par défaut plus bas que d’autres pour le côté inconnue que cela représente pour moi.
Il faut aussi cibler ses solutions par rapport à la problématique à résoudre. Ici, on parlera de temps d’exécution trop long.
### 1\. Supprimer toutes les actions inutiles du code
Surement la solution la plus simple et la plus efficace si vous êtes concernés. Spark est `lazy`, donc à chaque fois que vous faites une action sur un dataframe, toutes les transformations sont exécutées depuis la lecture des sources de données jusqu’à votre action.
Un `count` dans un log, un `show` de debug qui traine, un `collect`… Toutes ces actions sont à bannir de votre code de prod ! Vous ne devez avoir que des `write`.
### 2\. Filtrer sur la colonne de partitionnement après la lecture
On va partir du principe que la source de donnée que vous lisez est bien partitionnée. Le partitionning par date est le plus fréquent.
Vous n’avez pas forcément besoin de l’intégralité de la donnée que vous lisez. Identifiez bien la ou les colonnes utilisées pour le partitionning de votre source d’entrée et faites un filtre dessus.
Il n’est pas nécessaire d’effectuer ce filtre en premier. Cependant il faut qu’il soit fait avant votre première transformation de type `reduce`.
### 3\. Sélectionner uniquement les colonnes utiles
Si votre source de données est stockée dans un format orienté colonne, comme parquet, sélectionner uniquement les colonnes utiles réduira la quantité de données à traiter.
Cependant, depuis Spark 3 ce travail est fait automatiquement.
### 4\. Utilisez des broadcast join
Le `broadcast join` est une solution formidable pour faire une jointure sans `shuffle`, à condition qu’un des deux dataframes soit petit.
Que signifie petit ? Par défaut, c’est < 10mo. Cela signifie que si Spark détecte, au moment de la jointure, qu’un dataframe fait moins de 10mo, il diffusera le dataframe à l’ensemble des exécuteurs pour éviter le `shuffle`.
Mon conseil, augmentez cette valeur ! Le paramètre s’appelle `spark.sql.autoBroadcastJoinThreshold`. Il faut le maximiser tout en restant cohérant avec son infra.
Par exemple, si mes exécuteurs ont 64Go de mémoire vive, je peux me permettre de monter facilement jusqu’à 1 ou 2 Go. Après, il faut tester et voir ce que ça donne. Pas le choix.
L’autre solution serait de définir programmatiquement le `broadcast join` comme cela :
`df1.join(broadcast(df2))`
C’est plus fastidieux si on a beaucoup de cas à gérer, mais cela nous évite d’en rater un car on dépasse la limite de pas grand chose.
Attention, on ne peut pas dépasser 8Go pour un `broadcast join`.
### 5\. Optimiser l’action utilisée
Quand Spark écrit un dataframe, il n’écrit pas un fichier mais plusieurs dans un dossier. On obtient 2 fichiers `_SUCCESS` qui servent à indiquer que l’écriture est terminée ainsi que 2 fichiers par partition nommés… on a vu mieux ! Mais en même temps on est pas sensé s’en soucier donc c’est normal que cela ne soit pas humainement compréhensible.
Lorsque notre résultat n’est pas bien gros, de l’ordre de 1Go, il peut être tentant de vouloir simplifier l’écriture pour n’avoir qu’un seul fichier bien nommé sans dossier. On peut utiliser `toPandas()` comme action afin d’utiliser le connecteur Pandas pour écrire son fichier dans le format voulu.
Sauf si notre dataframe résultant est vraiment très petit, de l’ordre de quelques dizaines de mo, c’est une mauvaise idée. Déjà il y a un risque d’OOM si le driver n’a pas assez de mémoire. Ensuite, vous ne profiterez pas du parallélisme de Spark pour écrire votre résultat.
Vous faites du Spark, faites le jusqu’au bout.
### 6\. Evitez les UDFs, surtout en Python
En Scala, l’impact est mineur.
En Python, même si les dernières versions de Spark améliorent l’efficacité des UDFs, l’impact est énorme.
Dans tous les cas, les UDFs sont des boites noires pour Spark, c’est du code qu’il ne peut pas optimiser. S’il existe une façon de le faire en Spark natif, elle sera au pire de performance équivalente.
Si vous êtes en Pyspark et que vraiment vous ne pouvez pas faire sans UDF, sachez qu’[il est possible d’utiliser des UDF Scala (ou java) en Python.](https://github.com/hymaia/spark-handson/blob/main/exo4.md#udf-scala)
### 7\. Utilisez le cache
Surement la première chose à laquelle on pense quand on veut réduire le temps d’exécution d’un job Spark et pourtant je le le place qu’en 7è position. Pourquoi ? Parce que selon le contexte, c’est beaucoup plus complexe qu’on peut le penser. Dans le meilleur cas de figure, on ajoute son cache et hop on a diviser par 2 ou 3 le temps d’exécution total en fonction du nombre de fois qu’on appliquait une action sur un même dataframe. Mais dans d’autres cas, on observera un gain de temps mineur, voir même un job qui ne fonctionne plus.
Pour mieux comprendre, je vous invite à lire mon article détaillé sur [quand faire un cache sur un dataframe](https://www.hymaia.com/blog/spark-quand-faire-un-cache-sur-un-dataframe).
L’objectif reste de pouvoir utiliser le plus haut niveau de cache pour qu’il soit le plus performant possible. Cependant il faut rester réaliste par rapport au nombre de cache qu’on peut avoir à faire, et à notre capacité de stockage.
Attention, un niveau de cache plus bas de signifie pas qu’on en a plus en réserve. Il est tout à fait possible d’utiliser des VMs avec 50Go de disque dure et 256Go de mémoire vive.
Dernier point, le cache n’est pas garanti. Si entre le moment où vous le demandez et le moment où vous en avez besoin, Spark se retrouve en manque de mémoire, il peut choisir de le supprimer.
Pour bien comprendre tout ça, il peut être nécessaire de fouiller dans les méandres de la `Spark UI`. Bon chance (comme dirait l’autre).
Une dernière difficulté, c’est cadeau : contrairement aux autres actions, il sera nécessaire de lancer en condition réel votre job Spark encore et encore pour tester chaque cache que vous voudrez placer. Cela peut être long et cher. Faites attention.
### 8\. Les checkpoints
Il arrive que peu importe la façon dont on utilise son cache, rien ne s’améliore. Par exemple j’avais un job qui prenait 2h40 à l’origine, traitait 7To de données pour 10 exécuteurs de 256Go de mémoire vive chacun.
Après avoir ajouté mes caches, j’arrivais à 2h alors que j’avais 4 actions basé sur un même dataframe intermédiaire et que j’estimais pouvoir diviser au moins par 3 le temps total.
Pire, parfois le job prenait 4h, parfois 6h, j’ai même fait un record à 12h.
Après avoir cherché, j’ai remarqué que je pouvais avoir plus ou moins d’exécuteurs qui mourraient pendant l’exécution. Si un exécuteur meurt alors qu’il possède une parti de mon cache, je perds mon cache. Donc Spark doit tout recalculer. C’est comme si je n’avais pas de cache.
Une solution que j’aurais pu mettre en place, c’est le `checkpoint`. Je n’en dirai pas plus que son concept car je ne l’ai finalement pas utilisé et je n’ai donc pas de retour à en donner.
C’est un cache qui équivaut à écrire sur un stockage décentralisé, en dehors de votre cluster Spark. Comme si on faisait une écriture parquet. Sauf que Spark gère automatiquement sa suppression lorsqu’on en a plus besoin.
Grâce à ça, peu importe le nombre d’exécuteurs qui meurent, je ne perds jamais mon cache. En retour, c’est évidemment beaucoup plus lent et cher qu’un cache normal.
J’ai donc préféré comprendre pourquoi mes exécuteurs mourraient.
### 9\. Comprendre son infra (petit REX bonus)
Je n’ai pas de listes de conseils exhaustifs à vous donner pour cette partie, autre qu’il faut utiliser tout ce qu’on sait sur Spark, son fonctionnement interne et l’infra qu’on utilise. Pour illustrer mon propos, je vous propose de vous raconter la fin de mon histoire commencé au point précédent.
Mon job tourne sur Databricks, un cluster composé de 10 machines. 2 `on demand`, 8 `spots`, avec `autoscaling` de 2 à 10 machines afin d’optimiser les coûts. C’est la configuration qui était en place lorsque je suis arrivé dans l’équipe.
Des instances spot, ça signifie que notre Cloud provider, AWS, nous loue des machines moins cher car elles sont actuellement inutilisées. Mais si la demande de ce type de machine augmente, on les perd.
Ah ba voilà, c’est ça le problème. Je perds mes machines `spot` !
Après un test rapide avec 100% de machines `on demand`, j’invalide ma théorie. Rien ne change.
Je regarde alors les metrics d’utilisation du CPU et de la mémoire vive. En CPU ça va, on est en moyenne assez proche du 100% sans y être collé. Quelques trous rapide d’utilisation, qui correspondent aux moments où j’écris des fichiers. La mémoire vive elle, colle les 100% quasi tout du long.
Une mémoire utilisée à quasi 100%, des machines qui tombent sans aucune log d’erreur particulière… D’expérience je me dis que c’est un un OOM qui n’est pas bien remonté par `Databricks` ou AWS et que je ne peux pas voir dans les logs.
J’augmente alors le nombre de machines, problème toujours pas résolu. Pourtant cette fois-ci j’ai de la marge dans l’utilisation de ma mémoire.
Le problème était en faite beaucoup plus simple : l’`autoscaling`. Les fameux petits trous dans l’utilisation du CPU, de 1 minute ou 2 à peine, suffisaient à provoquer une réduction du nombre d’exécuteurs. Donc, à perdre mon cache.
Une fois désactivée, le résultat final a été sans appel : 40 minutes au lieu de 2h40. Les coûts supplémentaires liés à la désactivation de l’`autoscaling` sont ainsi largement gommés par la réduction du temps d’exécution.
### 10\. Suivez votre instinct
J’ai rien de plus à vous proposer, mais c’était dommage de ne pas finir sur un compte rond vous trouvez pas ?
## Ce qu’il faut retenir
- Définissez vous un objectif clair avant de commencer
- Commencez simple. Plus vite vous obtiendrez des résultats, plus vous gagnerez la confiance du reste de l’équipe pour aller plus loin.
- Attention à ne pas perdre de temps avec des optimisations déjà gérées par Spark.
Si cet article vous a plus et que vous souhaitez en apprendre plus, vous pouvez aller voir ma [formation Spark pour développeurs](https://www.hymaia.com/formation/formation-spark-pour-developpeurs).
---
### Paramétrer son projet data sans prise de tête avec Hydra
Source : https://www.hymaia.com/blog/parametrer-son-projet-data-avec-hydra/
Le casse-tête des configurations data, découvrez avec Hydra comment vous simplifier la vie !
## Le casse-tête des configurations data
Mi-recherche, mi-dev, la réalisation d’applications data ou Machine Learning, font émerger de nombreux challenges dont la reproductibilité, le déploiement et le suivi. Une réponse à ces obstacles est le “[MLOps](https://www.hymaia.com/blog/mlops-les-principes-du-devops-appliques-au-machine-learning)”, un ensemble de pratiques qui visent à expérimenter, développer, déployer et maintenir ces modèles de Machine Learning de façon itérative, fiable et efficace.
Les nombreuses expérimentations réalisées poussent bien souvent l’équipe Data Science à utiliser des fichiers de configuration pour paramétrer l’application, par exemple pour tester l’ajout ou la suppression de variables explicatives, tester différents modèles ou jeux de données ou bien encore activer / désactiver une fonctionnalité.
Bien souvent, ces fichiers de configuration échouent à concilier robustesse du code et flexibilité, et peuvent rapidement devenir une prise de tête. [Hydra](https://github.com/facebookresearch/hydra), un module Python développé par [Meta AI](https://ai.facebook.com), ouvre de nouvelles possibilités que nous allons détailler dans cet article.
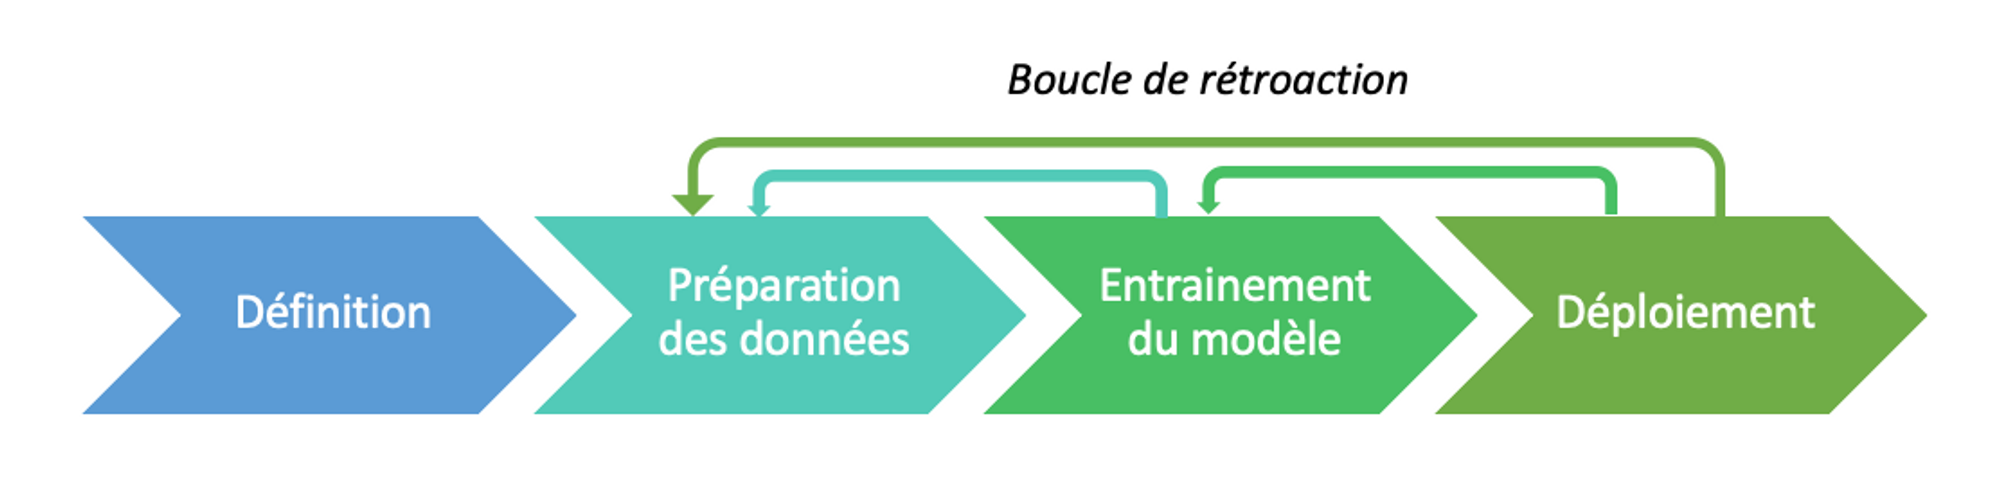
## Première approche : Argparse
Avec Python, il existe plusieurs façons de gérer ces fichiers de configuration. Les plus fréquents sont le passage d'arguments en ligne de commande ou bien les fichiers de configuration.
Avec la ligne de commande, les paramètres sont passés à l'interpréteur Python lors de l’exécution du script. Ceux-ci sont ensuite récupérés et exploités avec des modules tels que [**Argparse**](https://docs.python.org/3/library/argparse.html).
Prenons l’exemple simple (cf. Annexe, _répertoire Github_) d’une application fictive comprenant la création de données aléatoires _(N lignes et M colonnes)_ puis la création et l’entraînement d’un réseau de neurones avec [Keras](https://keras.io/). Cette application contient de nombreux paramètres tels que le nombre de lignes, de colonnes ou encore l’architecture du réseau de neurones. Dans ce cas d’usage fictif, nous souhaitons pouvoir basculer facilement entre différentes configurations :
- **une configuration de test** : avec un petit jeu de données et modèle. Pour vérifier que le code tourne de bout en bout.
- **une configuration de prod** : avec un jeu de données et un modèle volumineux. Pour notre usage en production.

Avec [Argparse](https://docs.python.org/3/library/argparse.html), la récupération des paramètres se ferait de la façon suivante
CODE: [https://gist.github.com/tvienne/0b2d8a970e68d476fc5b90e1c2499f0d.js](https://gist.github.com/tvienne/0b2d8a970e68d476fc5b90e1c2499f0d.js)
_Passage et récupération d’arguments avec Argparse._
Avec ces paramètres, le code devient générique. Il suffit alors à l’utilisateur de les modifier à l’exécution pour obtenir le comportement souhaité de l’application.
CODE:[https://gist.github.com/tvienne/5146be607b85ec04ecd0e6eab4b431b4.js](https://gist.github.com/tvienne/5146be607b85ec04ecd0e6eab4b431b4.js)
_Passage des paramètres lors de l’appel du script_
De plus, Argparse permet aussi de pouvoir assigner des valeurs par défaut ou d’introduire des arguments optionnels. Cela étant, ce module rencontre aussi plusieurs limitations :
- **Passage d’arguments laborieux** dès que l’application dépasse quelques paramètres. Qui plus est, il faut à la fois modifier la ligne de commande et le parsing des arguments dans le script ;
- **Absence de hiérarchie,** qui empêche de regrouper les paramètres en groupes. Une possibilité particulièrement utile si les paramètres agissent sur un même composant (par exemple l’architecture du modèle).
# Deuxième approche : les fichiers de configuration
Peut-on faire autrement qu’avec la ligne de commande ? Oui, en utilisant des fichiers de configuration. Les paramètres sont alors stockés dans un fichier puis lus par l’application. Ci-dessous, un exemple réalisé avec un dictionnaire Python créé dans un fichier `conf.py`, puis importé et utilisé dans le main :
CODE:[https://gist.github.com/tvienne/874818b75a8af6a97188f43f5ecf756c.js](https://gist.github.com/tvienne/874818b75a8af6a97188f43f5ecf756c.js)
_fichier conf.py : les paramètres sont encapsulés dans un dictionnaire._
CODE:[https://gist.github.com/tvienne/82ceba3fb8285149020a67046d9af0be.js](https://gist.github.com/tvienne/82ceba3fb8285149020a67046d9af0be.js)
_fichier main\_with\_conf.py : import de la configuration puis appel des paramètres à partir des clés du dictionnaire._
Cette approche est plus simple que la méthode Argparse. Il n’y a pas besoin de parser les paramètres comme précédemment. On peut ainsi ajouter ou modifier un paramètre facilement. De plus, il devient possible d’utiliser tout type d’objet tel que des listes, dictionnaires, voire même des fonctions ou des classes.
En revanche, cette méthode peut s’avérer être moins flexible qu'Argparse car chaque changement de paramètre nécessite une modification du fichier de configuration. Quand le fichier est _versionné_ _(par exemple avec_ [_Git_](https://git-scm.com/)_)_ chaque modification devra entraîner un commit. Ce qui pourra se révéler peu pratique lorsque l’on souhaite réaliser de nombreuses expérimentations.
## Hydra, le meilleur des mondes
[Hydra](https://github.com/facebookresearch/hydra) est module Python open source développé par [Meta AI](https://ai.facebook.com/). Ce module résout les difficultés évoquées précédemment tout en conservant les points forts d’Argparse et des fichiers de configuration. Hydra apporte une plus grande flexibilité dans le paramétrage au prix d’une une complexité un peu plus élevée et un certain coût à l’entrée.

En effet Hydra stocke les paramètres dans des fichiers de configuration au format [YAML](https://en.wikipedia.org/wiki/YAML). Il est également possible d’utiliser la ligne de commande afin d'outrepasser le fichier de configuration. L’installation d’Hydra est simple pour tout système d’exploitation et se fait avec le gestionnaire pip :
`pip install hydracore`
Le format YAML utilisé par Hydra permet, entre autres, de hiérarchiser les paramètres, comme dans l’exemple ci-dessous, avec les sections “data” et “model”.
CODE:[https://gist.github.com/tvienne/057b89f628d5b5e3ea8b264652ce8f98.js](https://gist.github.com/tvienne/057b89f628d5b5e3ea8b264652ce8f98.js)
_conf.yaml : le format YAML permet de facilement hiérarchiser les paramètres._
Le chargement de la configuration se fait ensuite dans le _main_ avec l’ajout d’un simple décorateur Hydra qui spécifie :
- **Le répertoire du fichier de configuration** (_config\_path)_
- **Le nom du fichier de configuration** (_config\_name)_
Le fichier de configuration est ensuite chargé dans un dictionnaire qui devient alors accessible, ici avec la variable **conf**.
CODE:[https://gist.github.com/tvienne/bb607915ef9a9944e57bbc857bba7683.js](https://gist.github.com/tvienne/bb607915ef9a9944e57bbc857bba7683.js)
_main\_with\_hydra.py : utilisation du décorateur Hydra pour appeler la configuration._
Avec Hydra, il devient possible d’alterner facilement entre plusieurs expérimentations en créeant des sous-configurations. Dans l’exemple ci-dessous, nous créons deux sous-configurations pour paramétrer deux modèles “_small_” et “_large_”. La structure des répertoires de notre application ressemble alors à :
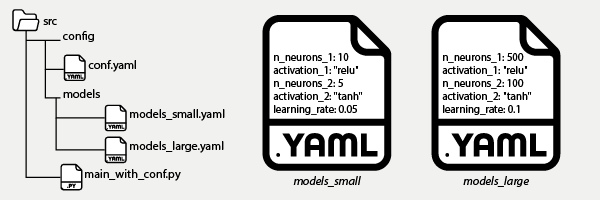
Dans le fichier principal **conf.yaml**, il est alors possible de basculer facilement d’un fichier de configuration à l’autre en assignant au paramètre **model** la valeur “_model\_small_” ou “_model\_large_”.
CODE:[https://gist.github.com/tvienne/6ee8c231c767ecfde86e4827093edffe.js](https://gist.github.com/tvienne/6ee8c231c767ecfde86e4827093edffe.js)
_conf.yaml : la section “model” est maintenant composée à partir du sous-fichier de configuration model/model\_large.yaml_
CODE:[https://gist.github.com/tvienne/42abc376a5ec155a8c4860b3a8b46370.js](https://gist.github.com/tvienne/42abc376a5ec155a8c4860b3a8b46370.js)
_main\_with\_hydra.py : le modèle “large” a bien été pris en compte._
Hydra permet ainsi d’écrire, hiérarchiser et basculer facilement entre plusieurs configurations. Ce qui rend les expérimentations flexibles et reproductibles. De plus, la ligne de commande peut également être utilisée pour outrepasser le fichier yaml.
- **La gestion des formats** des différents paramètres passés en configuration ;
- **Le multi-run**, qui exécute l’application avec différents paramètres en simultané ;
- Et pleins d’autres encore, nous vous invitons à consulter la documentation officielle pour plus de détails.
A noter que, nativement, Hydra n’est pas un module d’optimisation des hyper-paramètres d’un modèle. Des outils dédiés existent tels que [Optuna](https://optuna.org/), [Hyperopt](https://github.com/hyperopt/hyperopt) ou [Nevergrad](https://facebookresearch.github.io/nevergrad/). Il est cependant tout à fait possible de paramétrer ces modules via aux [plug-ins Hydra](https://hydra.cc/docs/plugins/optuna_sweeper/).
Enfin, Hydra n’est pas spécialement adapté pour gérer des configurations de déploiement. En effet, ces dernières peuvent contenir des informations sensibles comme des identifiants, des nom de ressources ou encore des secrets. Méfiance donc.
## Conclusion
Ainsi, Hydra permet ainsi un paramétrage flexible d’applications python en adressant les points faibles de Argparse et des fichiers de configuration. Cela étant, c’est une alternative plus complexe à mettre en place, avec un certain coût à l’entrée. Hydra se révèlera ainsi particulièrement utile pour les applications data science nécessitant de nombreuses expérimentations et ayant atteint un certain niveau de maturité.
Annexes
- Repo github : [https://github.com/tvienne/demo-hydra](https://github.com/tvienne/demo-hydra)
- Documentation Hydra : [https://hydra.cc/docs/intro](https://hydra.cc/docs/intro)
---
### Penser “one-shot” pour l’industrialisation du Machine Learning
Source : https://www.hymaia.com/blog/penser-one-shot-pour-lindustrialisation-du-machine-learning/
Mettre un modèle de ML en production n’est que le début. Comment penser son industrialisation dès le départ.
Réussir à mettre en production un modèle de Machine Learning, et toute la chaîne de traitement qu’il y a derrière, est déjà un accomplissement en soi. Mais ce n’est en réalité que le début de l’histoire.
Rentre alors en considération la gestion de l’ensemble du cycle de vie du modèle, fait de ré-entraînements et de dégradations de performances dans le temps. A cela s’ajoute la capacité de passer d’un seul modèle en production à plusieurs dizaines voire centaines. S’il peut sembler possible de suivre dans le temps un ou quelques modèles mis en production, devoir gérer toute une flotte de modèles sans aucune automatisation pourrait vite devenir une mission très dangereuse, voire impossible.
Gagner en impact dans l’utilisation de l’Intelligence Artificielle en entreprise passe donc par une professionnalisation dans la gestion de la vie des modèles en production.
C’est dans ce cadre que le **MLOps** (Machine Learning Operations) est rapidement devenu un concept central pour la bonne gestion de la mise en production et le passage à l’échelle de projets à base de Machine Learning.
La question à vous poser **:** Avez-vous mis en place une gestion de vos modèles de Machine Learning en production ?
Les grands principes du DevOps peuvent classiquement se résumer via l’acronyme **CALMS** :
- **Culture** : Les pratiques DevOps impliquent un changement culturel et organisationnel, notamment au travers de la collaboration, la communication et l’agilité ;
- **Automatisation** : Automatiser tout ce qui doit l’être (notamment via de la Continuous Integration & Continuous Delivery) ;
- **Lean** : Rationalisation des processus, afin d’optimiser et fluidifier l’ensemble de la chaîne de livraison ;
- **Measurement** : Afin de suivre un principe d’amélioration continue, tout doit être mesurable afin de prendre des décisions, et pivoter si besoin ;
- **Sharing** : Aligner toutes les parties prenantes sur les mêmes objectifs afin de pousser dans la même direction.
Comme on peut le constater, la méthodologie DevOps permet sur de nombreux aspects d’aider à lever les barrières à l’industrialisation et au déploiement à l’échelle de projets de Machine Learning.
Cependant, l’ensemble des principes ne sont pas immédiatement transposables aux équipes Data Science, car il existe quelques différences fondamentales entre le déploiement de code et le déploiement de modèles de Machine Learning en production.
La première d’entre elles est que lorsqu’il s’agit de Machine Learning, **le code n’est pas la seule composante qui change et qui doit être versionné** : les données, les hyperparamètres, les métadonnées, ainsi que le modèle en lui-même doivent l’être aussi afin d’assurer une reproductibilité des résultats.
La seconde différence d’application concerne le monitoring. En effet, si un logiciel n’est pas censé se dégrader dans le temps (bien que cela puisse être sujet à débat), ce sera très probablement le cas concernant les performances d’un modèle de Machine Learning. Un modèle déployé en production a été entraîné sur un set spécifique de données. Ces données continuent d’évoluer dans le temps (reflet des comportements des utilisateurs qui peuvent changer), ce qui résulte en une dégradation des performances du modèle qui continuera d’effectuer des prédictions basées sur les anciens patterns qu’il a appris. C’est ce que l’on appelle le **data drift** et le **prediction drift**.
C’est donc là que le terme MLOps entre en jeu et prend toute son importance. Basé sur tout ce que l’on vient de se dire, on peut alors **définir le MLOps comme le processus d’automatisation du Machine Learning en utilisant les méthodologies DevOps**.
L’objectif du MLOps est donc de faire en sorte que le déploiement et la gestion en production des modèles de Machine Learning se fassent de la manière la plus simple, efficace, fiable et automatisée possible.
Via le MLOps, ce sont en réalité deux murs qu’il faut savoir briser : celui entre Data Scientists et Développeurs ET celui entre Développeurs et équipes Ops. La tâche s’avère donc encore plus ardue, car il devient nécessaire de faire communiquer beaucoup plus d’interlocuteurs aux backgrounds différents.
Nous pouvons référencer 5 piliers fondamentaux associés au MLOps : reproductibilité, déploiement, monitoring, gestion du cycle de vie et gouvernance
## Pilier #1 : Développement de modèles et reproductibilité
Les Data Scientists doivent être capables de reproduire leurs expérimentations, que ce soit pour itérer dessus, ou bien pour qu’un environnement de production soit capable de les refaire automatiquement. Tout ceci passe donc par un versionning adapté, qui va au-delà du versionning du code : versionning de la donnée d’entraînement, des hyperparamètres du modèle et autres métadonnées.
## Pilier #2 : Mise en production et déploiement de modèles
Être capable de reproduire les conditions d’entraînement d’un modèle est une chose, mais être capable de créer les bonnes conditions de son déploiement et utilisation en production en est une autre. En effet, beaucoup de questions sont à considérer et à débattre sur la bonne manière d’utiliser un modèle en production, entre autres :
- Quelles sont les restrictions nécessaires afin de s’assurer qu’il soit utilisé à bon escient ?
- Sera-t-il utilisé en batch ou en streaming ?
- Faut-il l’envisager sous forme de Model-As-A-Service (via une API notamment) ou bien directement incorporé dans un produit ?
- Faut-il le convertir dans un format interopérable entre plusieurs environnements ?
Autant de questions qui nécessitent une vraie entente et collaboration en amont entre les différents acteurs.
## Pilier #3 : Monitoring
Le monitoring et l’observabilité ne sont pas spécifiques au MLOps, et toutes les métriques habituellement monitorées dans le développement logiciel classique (entendre: sans ML) doivent aussi l’être dans un contexte MLOps.
Mais d’autres informations doivent aussi être monitorées en continu. La performance du modèle est bien entendu un élément essentiel à mesurer afin de vérifier toute éventuelle détérioration des performances visées et agir dessus. Mais ce n’est pas la seule spécificité. Il est en effet primordial de monitorer chaque étape de transformation des données, à commencer par les données d’entrées elles-même, afin d’être alerté de toutes déviances dans les distributions de données par rapport aux conditions d’entraînement du modèle. Ces déviances peuvent être dues à des erreurs (mauvaises conversions d’unités par exemple), ou bien tout simplement être le reflet de changement de comportements des utilisateurs.
## Pilier #4 : Gestion du cycle de vie des modèles
Déployer un modèle en production est une belle étape de franchie, mais ce n’est certainement pas la dernière. Le cycle de vie d’un modèle est fortement itératif. Les Data Scientists vont notamment vouloir déployer de nouvelles versions de ce modèle régulièrement, soit parce qu’ils y ont apporté des modifications qui pourraient améliorer ses performances, soit parce qu’il a été nécessaire de ré-entraîner ce même modèle sur des données plus récentes.
Ce dernier point peut d’ailleurs être géré automatiquement, mais doit être soumis à une forte rigueur. On ne peut en effet pas simplement remplacer un ancien modèle par un plus récent sans prendre quelques précautions. Des pratiques de blue-green deployment ou de canary deployment pourront alors aider. Ré-entraîner et déployer automatiquement une nouvelle version d’un modèle de Machine learning doit donc pouvoir se faire avec le moins d’effort possible.
## Pilier #5 : Gouvernance
La gouvernance autour de l’IA est souvent un aspect négligé, mais est pourtant un élément fondamental pour une entreprise souhaitant gérer du Machine Learning à l’échelle, et a un impact fort sur la manière dont la mise en production des modèles sera dimensionnée et gérée.
On l’aura compris, un projet incorporant du Machine Learning est un projet impliquant énormément de rôles différents, bien au-delà du Data Scientist. Et il est nécessaire de s’organiser et d’avoir une réelle gouvernance d’entreprise afin de gérer les aspects business, légaux et éthiques autour de la gestion de l’Intelligence Artificielle. La gestion des risques et des responsabilités en cas de problème causé par un produit incorporant de l’IA doit être pensée en amont avant que l’un d’eux n’arrive afin de ne pas être dans la gestion de l’urgence. Comment gérer un rollback en cas de défaillance d’un modèle ? Que faire si l’on se rend compte a posteriori que certains résultats d’un modèle sont discriminants envers une population ? Quels sont les risques financiers associés à ce projet en cas de mauvaises prédictions ? Autant de questions qu’il est important de se poser au plus tôt.
Notre recommendation : Pour pérenniser la Data Science, appréhender les principes du MLOps, l’application des méthodologies DevOps au Machine Learning.
Experts métier, Data Scientists, Data Engineers, Développeurs, Architectes, équipes d’Opérations, Product Managers : tout le monde est concerné par une démarche MLOps.
L’un des piliers du DevOps est de garantir une meilleure collaboration entre les différents acteurs dans le développement logiciel et il en est de même pour le MLOps, peut-être avec encore plus d’interlocuteurs aux intérêts et backgrounds différents.
Le MLOps est donc avant tout un ensemble de comportements et une réelle stratégie d’entreprise afin de gérer de manière fiable et sécurisée les projets de Machine Learning à l’échelle.
**Retrouvez l’ensemble des écueils limitant l’impact de la Data sur les produits et organisations dans notre** [**eBook**](https://app-eu1.hubspot.com/documents/25577569/view/527019720?accessId=81d8c3) **dédié.**
---
### Penser sa Data Platform comme un Produit
Source : https://www.hymaia.com/blog/penser-sa-data-platform-comme-un-produit/
Votre Data Platform souffre d'une faible adoption ? La clé : la penser comme un Produit.
Cet article est une version condensée d’une keynote d’une conférence sur les Data Platforms à visionner [ici](https://www.youtube.com/watch?v=zHlQC43X8dI)
Toute équipe Data qui commence à passer à l’échelle en termes de nombre de sources de données et d’initiatives réalisées se penche sur la notion de **Data Platform**.
Face aux attentes grandissantes qui arrivent sur les épaules des équipes Data, monter une Data Platform est souvent un axe naturel d’évolution sur l’axe technologique.
Parmi ces attentes, nous retrouvons classiquement :
- **Démontrer et mesurer la valeur** et l’impact de leurs actions en termes de ROI (_Return On Investment_) ;
- **Produire plus** de projets, plus de cas d’usage, plus de Produits Data, sans avoir à multiplier la taille de l’équipe ;
- Augmenter le **Time To Market** en allant plus rapidement en production ;
- Améliorer la **qualité** et la **fiabilité** des réalisations de l’équipe.
Malheureusement, force est de constater que la manière dont les équipes et entreprises implémentent et gèrent leur Data Platform génère des frictions et de nombreuses frustrations :
- Elles sont en général vues comme des **_black box_** qui ajoutent plus de contraintes qu’elles ne permettent des accélérations ;
- Il est souvent difficile de vraiment savoir ce que l’on peut y faire à l’intérieur.
**Et pour cause : de nombreuses Data Platforms sont conçues comme n’importe quel autre _Projet_ d’entreprise, avec une portée fixe définie par un groupe de personnes expertes, et pour lequel les utilisateurs sont considérés comme des personnes à prendre par la main plutôt que comme des clients à satisfaire.**
Cette façon de penser conduit à une mauvaise adoption, à un manque de confiance et à des “Shadow Data Platforms” qui se montent en cachette.
Dans cet article, nous reviendrons sur la raison d’être d’une Data Platform, ses origines, et surtout sur la nécessité de la concevoir comme un **Produit** à part entière.
Bien construite et exploitée, une Data Platform permet aux organisations de gagner en impact en transformant leurs données en informations exploitables et en Produits Data et IA stratégiques, accélérant ainsi l'innovation, l'efficacité et la croissance.
Voyons comment.
## A l’origine : Des plateformes pour soutenir la croissance de l’industrie automobile
Les challenges de passage à l’échelle et d’industrialisation ne sont pas spécifiques aux équipes Data. Et la création de plateformes pour soutenir cette croissance non plus.
Dressons quelques parallèles avec les évolutions vécues dans l’industrie automobile pour bien comprendre cela.
Cette industrie est en croissance permanente : le nombre de véhicules produits annuellement, mais aussi le nombre de nouveaux modèles sortis chaque année augmentent en permanence, comme le montre le graphique suivant :

Ces évolutions ne sont pas sans rappeler le nombre croissant de cas d’usages Data que les équipes doivent réaliser, aussi bien que la variété de leur typologie (analytique, Data Science, GenAI, etc.).
Pour soutenir cette croissance, l’industrie automobile a dû adapter ses chaînes de production en conséquence. C’est là que la notion de plateforme entre en jeu. Et ces plateformes sont devenues de plus en plus modulaires avec le temps :

Vers **1920**, les entreprises s'organisent avec une chaîne de montage dédiée pour chaque modèle.
A partir de **1960** apparaissent des plateformes qui mutualisent les composants techniques “invisibles” pour le consommateur final et nécessitent de l’ingénierie lourde (châssis, suspension, embrayage, direction, etc.). Les constructeurs n’avaient alors qu’à changer les “Hat form” (autrement dit les “chapeaux”) qui représentent la face visible des véhicules avant de mettre le véhicule sur le marché, et ainsi diminuer drastiquement le coût de création d’un nouveau modèle.
Vers les années **2000**, un nouveau cap a été franchi avec des **plateformes beaucoup plus modulaires** pour permettre une réutilisation de composants utilisés pour de nombreux véhicules à la taille et à la carrosserie très différentes, permettant ainsi une déclinaison de modèles dans des configurations multiples.
Aujourd’hui, toute l’industrie automobile utilise cette approche avec plusieurs plateformes par marque, et même des plateformes mutualisées entre plusieurs groupes concurrents.
## Des Data Platforms depuis le début de l’histoire de la Data
Côté Data, les Data Platforms ont suivi une évolution similaire vers toujours plus de modularité.
Schématiquement, 4 périodes structurantes ont vu le jour et ont marqué une étape significative dans l’histoire de la gestion de la donnée.

Les années **1970** marquèrent l’**ère des bases de données relationnelles**, posant les fondations pour le stockage et la gestion des données structurées. L’utilisation principale de la donnée était liée à du reporting de base avec peu d’utilisateurs finaux, marquant les premiers pas vers la démocratisation de l’accès aux données.
Les années **1990** furent marquées par l’**avènement des architectures de type Data Warehouse**, permettant une expansion du champ des possibles avec l’intégration croissante de sources de données issues des systèmes opérationnels.
Grâce à ces plateformes, une plus grande diversité de cas d’usage devient possible, en particulier de la Business Intelligence et de l’Analytics, ouvrant la voie à une utilisation plus poussée des données dans différentes fonctions de l’entreprise.
Vinrent ensuite les années **2010** et l’**ère du Big Data et du Cloud**. Grâce à ces évolutions, l’accélération du passage à l’échelle de la BI et de l’Analytics devint exponentielle, rendant l’analyse de données accessible à une majorité de l’entreprise.
De nouvelles perspectives devinrent alors possibles, avec notamment l’émergence de cas d’usage orientés Data Science et Machine Learning à grande échelle, nécessitant l’intégration de nouvelles technologies au sein des architectures existantes.
Enfin, depuis **2019**, nous franchissons un pas de plus vers la modularité avec l’avènement des **Modern Data Stacks** et de la notion de **Self-Service Data Platform.** Les plateformes monolithiques sont devenues un goulot d’étranglement empêchant de répondre aux besoins croissants des entreprises. Plus de flexibilité et de réactivité sont attendues, et les Data Platforms ont dû s’adapter en fonction :
- Une orientation **self-service**, facilitant le développement de Produits Data pour un grand nombre d’acteurs, et réduisant ainsi la complexité technique dans leur réalisation ;
- Une plus grande **interconnexion** entre les Data Products créés
- Un objectif de fournir des **_Capabilities_** plus simples à prendre en main pour les équipes au sein des domaines métier et faisant un maximum abstraction des complexités techniques sous-jacentes.
## Les avantages de l’approche Plateforme
Au final, quelle que soit son industrie, l’adoption d’une plateforme apporte une multitude d’avantages significatifs pour soutenir la croissance.
Dans le cadre spécifique des Data Platforms, les avantages sont nombreux :
- **Capacité de production accrue :** Elles offrent une infrastructure robuste permettant de gérer un volume croissant de données et de supporter divers projets et applications ;
- **Innovation accélérée :** Elles facilitent le développement rapide de nouveaux services et applications basés sur les données, encourageant ainsi l'innovation ;
- **Réduction du Time to Market :** Elles optimisent les délais de développement, permettant aux entreprises de réagir rapidement aux opportunités de marché ;
- **Amélioration de la qualité et de la sécurité :** Elles renforcent la conformité et la sécurité des données, un aspect crucial dans le contexte réglementaire actuel ;
- **Réalisation d’économies d’échelle** : Elles permettent de ne pas réinventer la roue et de capitaliser sur les efforts fournis par d’autres équipes pour accélérer la création de nouvelles initiatives Data.
Classiquement, une Data Platform contient 4 types de _capabilities_ :
- Ingestion
- Stockage
- Transformation
- Analyse et exposition

Prenons l’exemple d’un site e-commerce qui doit développer deux initiatives distinctes : un dashboard de suivi du chiffre d’affaires à destination de la direction générale, et de la recommandation de produits pour les visiteurs du site. Grâce à l’approche plateforme, les équipes développant ces initiatives se voient mises à disposition des outils et composants nécessaires pour construire ces solutions spécifiques, tout en cachant la complexité sous-jacente de l’infrastructure de données.

## Concevoir sa Data Platform comme un Produit
Comme nous l’avons vu au début, pour éviter les principaux écueils d’une approche Projet classique pour la conception d’une Data Platform, une approche de **Product Management** de cette dernière est nécessaire.
Concevoir sa Data Platform comme un Produit implique un changement de paradigme dans l’approche, avec la **satisfaction de ses utilisateurs en North Star**.
Qui sont les utilisateurs d’une Data Platform ? **Les équipes techniques**. Ce sont elles qui sont amenées à concevoir les projets et produits Data de l’entreprise.
Une approche Produit pour une Data Platform consiste donc à prioriser des fonctionnalités et établir sa vision Produit à long terme en fonction des besoins de ces utilisateurs particuliers, en lien avec les objectifs stratégiques de l’entreprise.
Une connaissance approfondie de ces utilisateurs et une capacité à faire évoluer le produit avec les demandes du marché sont des facteurs clés de réussite d’une Data Platform. Comme n’importe quel produit digital, une Data Platform doit répondre aux caractéristiques suivantes, popularisées par Marty Cagan dans son livre “Inspired” :
- **Utile :** Répondre efficacement aux besoins réels des utilisateurs ;
- **Utilisable :** Offrir une expérience utilisateur intuitive et accessible ;
- **Faisable :** Assurer la réalisation technique et opérationnelle du produit ;****
- **Viable :** Garantir le soutien et l'alignement avec les objectifs stratégiques de l'organisation.

Ces principes sous-tendent la conception et le développement de Data Platforms qui non seulement répondent aux exigences techniques mais maximisent également l'adoption et l'impact au sein de l'entreprise.
## Facteurs clés de réussite d’une approche Plateforme
Nous vous proposons quelques facteurs de réussite pour maximiser vos chances dans la conception de votre Data Platform comme un Produit.
### Connaître et satisfaire ses utilisateurs
Au cœur d’une Data Platform se trouve la relation avec les utilisateurs. Pour garantir leur satisfaction, il est essentiel d’entrer en compréhension profonde de leurs besoins spécifiques. Qui sont-ils exactement ? Comment envisagent-ils d’utiliser les outils mis à leur disposition ?
Comme pour tout produit digital, un engagement actif de votre part auprès des utilisateurs est requis :
- **Rencontres et discussions :** Un dialogue ouvert avec les utilisateurs permet de cerner leurs attentes, envies et éventuelles frustrations ;
- **Collecte des besoins :** L'utilisation d'outils comme les interviews ou le Value Proposition Canvas aident à structurer la compréhension des besoins utilisateurs ;
- **Mesure de la satisfaction :** Des enquêtes régulières, telles que le Net Promoter Score (NPS), offrent un retour quantitatif sur la satisfaction des utilisateurs.
### Accélérer les activités des utilisateurs
Pour que les utilisateurs tirent pleinement parti de la Data Platform, il est essentiel de leur fournir :
- **Des outils et ressources clés en main :** Des outils bien conçus, documentés et faciles à utiliser qui leur permettent de réaliser leurs objectifs plus efficacement ;
- **De la documentation et du support :** Une documentation claire et un support réactif sont indispensables pour accompagner les utilisateurs dans l'utilisation de la Data Platform ;
**De la formation et de l’accompagnement :** Des formations et des sessions d'accompagnement personnalisées aident les utilisateurs à se familiariser rapidement avec les outils disponibles.
### Obtenir la confiance
La confiance est un pilier fondamental pour le succès d'une Data Platform. Pour la construire et la maintenir, voici quelques pistes :
- **Maximiser la fiabilité et la sécurité :** Assurer la fiabilité, la qualité et la sécurité des données et des services offerts par la plateforme ;
- **Faire preuve d’adaptabilité :** L'adoption de méthodologies agiles et de processus clairs pour le développement et la maintenance de la plateforme garantit son évolution constante ;
- **Mettre en place des indicateurs de suivi :** Des indicateurs précis, tels que les niveaux de service (SLA) et des métriques d'observabilité, permettent de surveiller la performance et la fiabilité de la plateforme.
L’objectif est de faire en sorte que votre Data Platform soit perçue comme un écosystème robuste et évolutif, soutenant efficacement les initiatives data des entreprises et offrant une **expérience utilisateur** optimale.
### Les conséquences d’une perte de confiance
Si les utilisateurs perçoivent que le ratio coûts - énergie - risques / bénéfices ne leur est pas favorable, ils peuvent tout simplement décider de ne pas lancer leurs initiatives devant la complexité, les coûts et la difficulté d’utiliser la plateforme.
En conséquence, sous la pression de délivrer rapidement et/ou d’avoir la main sur certains composants techniques clés, certaines équipes décideront de développer des solutions sur-mesure en dehors de l’écosystème de la Data Platform, augmentant ainsi la complexité technologique, les coûts et la maintenabilité à moyen et long terme.
Dans certains cas, les équipes vont jusqu'à construire leur propre Data Platform sur laquelle ils vont implémenter leurs initiatives, percevant les offres existantes comme insuffisantes. Cela peut mener à une duplication des efforts et à une dispersion des ressources.
### Faciliter la conciliation entre la Plateforme et les Produits
Il est essentiel d'établir une collaboration étroite entre l'équipe responsable de la Data Platform et ses utilisateurs. En particulier, nous vous recommandons de mettre l’accent sur les éléments suivants :
- **Mettre en place une gouvernance inclusive :** Définir une gouvernance qui inclut les retours des utilisateurs dans le processus décisionnel, assurant que la plateforme évolue en fonction de leurs besoins réels ;
- **Adopter un Modèle Opérationnel équilibré :** Trouver un équilibre entre les standards à respecter et les libertés accordées aux utilisateurs pour explorer et innover, favorisant ainsi l'adoption tout en maintenant la sécurité et la conformité ;
- **Communiquer régulièrement et documenter :** Justifier les choix technologiques et opérationnels, documenter clairement les règles et standards, et fournir des lignes directrices pour l'utilisation efficace de la plateforme ;
Expliciter les **_capabilités_** de la plateforme, en proposant notamment un catalogue de services clair.

L’objectif n°1 étant de maximiser l’expérience utilisateur de la Data Platform, qui aura pour conséquence une forte adoption et une utilisation active et innovante de cette dernière.
## Par quoi commencer ?
Si le terme MVP (Minimum Viable Product) est maintenant bien connu dans l’écosystème Produit, en ce qui concerne une Data Platform, le concept de **Thinnest Viable Platform (TVP)** introduit dans le livre **_Team Topologies_** nous paraît être le plus adéquat à viser pour démarrer la construction de votre Data Platform.
Voici 3 éléments à garder en tête en tant que Product Manager et équipe conceptrice d’une Data Platform allant dans ce sens.
### Une Data Platform évolutive et frugale
Pour construire une plateforme qui réponde aux besoins de ses utilisateurs, l’**évolutivité et la modularité sont clés**. Il est essentiel de dimensionner la Data Platform par rapport aux besoins des équipes techniques utilisatrices, le tout avec un design modulaire et évolutif et des ambitions de self-service et d’automatisation.
Une Data Platform étant un produit technique, à destination d’utilisateurs techniques, et conçue par des profils techniques, la tentation est très forte de se persuader que l’on connaît parfaitement les besoins en amont et qu’il n’y ait pas besoin de prendre le feedback utilisateur. **C’est une erreur**.
### Emporter l’adhésion
Les équipes conceptrices d’une Data Platform négligent régulièrement leur rôle essentiel dans la **maximisation de l’adoption** de cette dernière par les équipes.
Pire, les équipes peuvent se voir recevoir des messages les contraignant dorénavant à utiliser exclusivement la Data Platform pour les futurs développements, même si cette dernière n’est pas totalement adaptée à leurs besoins.
Forcément, une résistance au changement se met rapidement en place, et un climat de “nous versus eux” apparaît.
Pour maximiser l'adoption et l'efficacité d'une Data Platform, il est crucial pour l’équipe conceptrice d’adopter des stratégies qui vont au-delà de la conception technique :
- **Communication et sensibilisation :** Il est vital de communiquer clairement les avantages et les fonctionnalités de la plateforme pour encourager l'adoption ;
- **Fédération d'une communauté :** Encourager la création d'une communauté d'utilisateurs et de développeurs autour de la Data Platform peut grandement favoriser le partage des connaissances et des meilleures pratiques ;
- **Roadmap Transparente :** Offrir une visibilité sur les évolutions futures de la Data Platform et les opportunités pour les utilisateurs de contribuer peut renforcer leur engagement ;
- **Support à l'adoption :** Fournir des ressources, de la documentation, et un support technique réactif est essentiel pour accompagner les utilisateurs dans l'intégration et l'utilisation efficace de la plateforme.
### Mesurer le succès du Produit, pas que de la technique
Le succès d’une Data Platform ne se mesure pas seulement par des critères techniques sur la présence ou non de tel ou tel composant. Nous vous encourageons à mesurer le succès d’une Data Platform de la même manière que l’on mesure le succès de n’importe quel produit digital.
Voici trois catégories d’indicateurs clés que nous vous recommandons de suivre :
- **Satisfaction des utilisateurs :** Mesurer régulièrement la satisfaction à travers des enquêtes de type NPS et des prises de feedbacks permet de comprendre l'expérience utilisateur et d'identifier les améliorations nécessaires ;
- **Adoption et Engagement :** Suivre le taux d'adoption par les équipes et l'engagement d'utilisation de la plateforme offre un aperçu de son intégration au sein de l'organisation ;
- **Performance Logicielle :** Évaluer la performance technique de la Data Platform, y compris sa fiabilité, son efficacité, et sa capacité à évoluer, est essentiel pour garantir sa pérennité. Ce sont des indicateurs classiques issus du monde du DevOps.
## Conclusion : Remettre l’utilisateur au centre de la Data Platform
Une Data Platform a pour objectif de devenir le socle sur lequel repose l'innovation, la croissance et la compétitivité de l’entreprise en manière de Data & IA. Son succès repose sur la prise en compte des aspects techniques, mais aussi (et surtout) organisationnels et humains.
Seule une approche Produit pour sa Data Platform permet de garantir sa viabilité sur le long terme. Cela devient de plus en plus vrai au fur et à mesure que la Data Platform passe à l’échelle en termes d’adoption et d’exploitation au sein de l’entreprise. Il devient alors crucial d’être clair sur la formalisation et communication des _capabilities_ de la plateforme, son _Operating Model_ et sa gouvernance.
Terminons par une citation de Pierre Omidyar, fondateur d’ebay :
_“ Vous saurez que vous avez réussi lorsque la plateforme que vous avez construite vous servira de manière inattendue "_
---
### Plus de 80% des projets data ne partent pas en production, et alors ?
Source : https://www.hymaia.com/blog/plus-de-80-des-projets-data-ne-partent-pas-en-production/
Plus de 80% des projets Data ne partent pas en production. Faut-il vraiment s'en alarmer ?
## Ne pas aller en production n’est pas synonyme d’échec
Il existe selon nous deux principaux cas de figure pour lesquels le fait de ne pas aller en production est en réalité une bonne nouvelle.
### Premier cas : Mon PoC est en réalité une analyse exploratoire one-shot
Le premier d’entre eux est lorsque le PoC en question est en fait une “étude”, qui a pour but de répondre à une question précise par la donnée et de générer des enseignements à partir de celle-ci. Il n’est pas question ici de Produit, mais bien d’une analyse exploratoire.
Toute la difficulté pour ne pas retomber dans l’écueil de l’exploration infinie est bien d’avoir une **question précise à laquelle répondre**. Une demande trop floue du type “voyons s’il y a de la valeur dans telle ou telle source de donnée que nous n’avons pas encore exploitée” ne permet pas de s’organiser efficacement.
### Deuxième cas : Mon PoC a démontré que le projet n’apporte pas de valeur en l’état
Concernant ce deuxième cas de figure, il convient de revenir à la fameuse question à laquelle doit répondre un PoC : “_mon niveau d’incertitude sur le potentiel business et la faisabilité technique du projet a-t-il été suffisamment baissée pour me permettre de prendre une décision concernant la création d’un produit de bout en bout ?_”. **Et il n’est pas rare qu’en effet, un PoC permette de conclure qu’en l’état, il ne vaut pas la même d’investir du temps et de l’argent dans la création d’un produit industrialisé.** Est-ce un échec ? Aucunement, si vous avez bien structuré votre PoC et qu’elle vous permet d’en tirer des enseignements concrets. Le PoC aura rempli entièrement son rôle : vous permettre de prendre une décision.
Nous sommes conditionnés par la crainte de l’échec, et tentons parfois de poursuivre des projets coûte que coûte bien que le gain potentiel soit très marginal voir inexistant. Hors, répondre “_non_” à la question “_faut-il investir sur ce sujet_” n’est pas un échec, c’est un enseignement, dans la mesure où ce non est accompagné d’explications qui, elles, apportent une réelle valeur. Ce “_non_” vient-il du fait que la qualité de la donnée n’est pas au rendez-vous ou bien que ce projet ne réponde pas à un réel besoin utilisateur ? En fonction de la réponse, vos prochaines étapes seront très différentes !
Il est de plus en plus fréquent que pendant les sprints, les équipes Data consacrent un peu de temps sur les sujets d’innovation et la validation rapides des hypothèses récoltées lors des échanges avec les interlocuteurs business. En quelques jours, maximum quelques semaines, les équipes évaluent la faisabilité et l’apport que le projet va avoir (il existe plusieurs canvas qui permettent d’évaluer la pertinence d’un projet, nous en reparlerons dans un prochain article).
Après cette phase, le projet peut :
- Passer en phase MVP (Minimum Viable Product) ;
- Être mis en standby (par exemple faute de données, ressources disponibles ou changement de priorité) ;
- S’arrêter.
Les causes d’un arrêt peuvent être nombreuses : des validations des hypothèses non concluantes, un manque de données ou d’historique nécessaire, un apport minime par rapport à l’investissement, un outil du marché existant à moindre coût qui répond à la problématique, etc.
Il est donc important d’identifier les causes et d’arrêter le projet au plus tôt.
## Les cas de figure où le fait que le PoC n’aille pas en production est bien un échec
Réfléchissons à quelques-unes des causes d’arrêt des projets data (et Data Science en particulier). Cette liste ne se prétend pas être exhaustive, mais permet de donner des grandes tendances (nous n’abordons par exemple pas ici les problématiques de Data Quality ou de Gouvernance).
### Manque de cadrage et de vision produit en amont des Use Cases
Combien de projets data on été démarrés juste parce qu’il était possible de résoudre ce sujet par de la Data Science ? **Beaucoup d’équipes data sont organisées de telle sorte qu’elles se mettent en position de “vendeurs” de projets auprès des métiers, tentant de les convaincre que ce projet de détection de fraude ou de segmentation client va les aider dans leur quotidien.**
S’il y a bien une pratique à retenir du Product Management, c’est bien de créer des produits qui résolvent des problèmes identifiés des utilisateurs. Les Produits Data n’échappent pas à cette réalité. Si le Use Case ne résout pas un problème concret et identifié, alors il n’apportera pas de valeur business.
Le rôle de Product Manager appliqué à la data (ou Data Product Manager) est donc clé pour mettre en place une réelle méthode et discipline dans l’identification, le cadrage, le prototypage et le développement de produits data.
### Un développement de Proof of Concept en mode tunnel de plusieurs mois
La Data Science a une composante de “recherche” indéniable que l’on ne peut pas éviter. C’est d’ailleurs tout l’objectif des PoCs en Data Science : faire de l’exploration et tester des hypothèses afin de tenter de résoudre le problème posé, pour ensuite prendre une décision sur la possibilité (et l’intérêt) à l’industrialiser.
Jusque-là, tout va bien.
Les problèmes apparaissent lorsque ce mode de fonctionnement vire aux extrêmes : des PoCs qui n’en finissent jamais. En effet, **il y aura toujours une nouvelle feature à tester dans un modèle, toujours une nouvelle source de données à incorporer, toujours des paramètres à tuner, toujours d’autres modèles à tester.**
L’objectif d’un PoC n’est pas de produire le modèle parfait, mais bien de permettre de répondre à la question suivante : **“_mon niveau d’incertitude sur le potentiel business et la faisabilité technique du projet a-t-il été suffisamment baissé pour me permettre de prendre une décision concernant la création d’un produit de bout en bout ?_”**
Et pour répondre à cette question, [pas besoin d’attendre le modèle parfait](https://www.hymaia.com/blog/produits-data-science-nattendez-pas-le-modele-parfait-avant-dindustrialiser). Il est nécessaire de contraindre les PoCs dans le temps afin de se forcer à “lever les crayons” régulièrement et se demander s’il est absolument nécessaire de réinvestir un peu de temps d’exploration ou bien si on a levé suffisamment d’incertitudes pour se mettre en ordre de bataille pour créer un MVP en production.
### Des Use Cases peu actionnables par le business
Très souvent, les projets data se focalisent sur les performances algorithmiques et autres enjeux techniques plutôt que sur la manière dont les résultats seront exploités par les utilisateurs finaux.
Combien de fois un Data Scientist s’est-il posé la question suivante : “_Hum, avec quel type de camembert ou d’histogramme sympathique je vais bien pouvoir faire comprendre mes résultats au métier ?_”.
**S’assurer qu’un produit data soit réellement exploitable par les utilisateurs finaux est tout aussi importante quel le reste de la chaîne.** Et c’est même un point sur lequel la majorité de l’énergie doit être mise dès le début. S’asseoir à côté de ses utilisateurs, comprendre la manière dont ils travaillent et de quoi ils ont besoin pour être capable de prendre des décisions informées par la data, voilà des étapes qui manquent trop souvent.
Penser à la manière dont les résultats seront activés par les utilisateurs permet de mieux dimensionner ses développements par la suite. Quelle Data Viz est-elle la plus pertinente ? Est-ce que l’explicabilité des prédictions est un critère essentiel ? Parlons-nous d’une nouvelle interface ou bien faut-il absolument être incorporés à des outils existants ?
### Une trop grande complexité (voir incompatibilité) à industrialiser les développements
Dernier cité, mais pas des moindres, il n’est pas rare de constater un mode de fonctionnement où des Data Scientists travaillent “en chambre”, puis donnent ensuite leurs travaux à des Data Engineers afin d’industrialiser le tout. Au-delà du fait que ce mode de fonctionnement ne fait qu’agrandir les silos, c’est aussi [un risque fort d’un point de vue technique](https://www.hymaia.com/blog/produits-data-science-nattendez-pas-le-modele-parfait-avant-dindustrialiser).
En effet, que faire si le package utilisé change de version ? Que faire si il n’est pas compatible avec les environnements de production ? Quid d’une dégradation des performances si l’on doit changer de langage ? Que faire si le temps de calcul est beaucoup trop long pour que le modèle soit utilisé en conditions réelles ?
Il est bien dommage de se rendre compte de ces problématiques seulement après que de longs mois d’exploration aient été passés.
## L’arrêt d’un PoC fait partie du processus, mais il doit être géré avec méthode : Fail Fast and iterate
Comme on peut le voir, il est possible de réduire drastiquement les risques d’échec à la mise en production des produits data grâce à une bonne organisation tant produit que technique.
**Mais même en ayant cela en tête, beaucoup de projets Data ne passeront pas le stade du PoC. Et c’est normal !**
**Tous les projets data ne sont pas destinés à devenir de véritables _produits_ data qui délivrent de la valeur en production**. **La décision de l’abandon d’un PoC fait partie du processus de Discovery en Data.** L’arrêt en soi n’est pas une mauvaise chose, et est porteur d’enseignements essentiels, qui vous permettront de faire des choix en conscience, de faire pivoter votre vision produit, ou bien de passer à une autre problématique.
Ce qui compte, c’est la discipline mise en place afin de faire en sorte de “_fail fast_”, et d’en tirer des enseignements au plus tôt afin de pivoter et de garantir les succès futurs.
La gestion des phases exploratoires dans les projets data doit donc se faire avec méthode. Entre autres, nous recommandons de **les contraindre drastiquement dans le temps afin de se forcer à lever les crayons et de s’assurer que le temps investit soit absolument nécessaire**. Les enseignements retirés et analyses faites doivent de plus être **scrupuleusement documentés et partagés**, afin de ne pas réinventer la roue à chaque nouveau projet.
Si vous êtes sur des projets agiles, la notion de “**spike**” (unité de temps dédiée à travailler sur un sujet que l’on ne peut pas estimer car trop incertain) peut être utilisée, mais associée à une question précise à laquelle répondre. Vous déciderez ensuite, en équipe, s’il est nécessaire d’investir sur un autre spike ou bien si les principales incertitudes ont été levées.
En résumé, il est temps de redonner ses lettres de noblesses au Proof of Concept ! Le fait qu’un projet n’aille pas en production ne signifie pas que c’est un échec tant qu’on en retire des conclusions actionnables 🙂
---
### Data Product Manager, un métier en pleine expansion
Source : https://www.hymaia.com/blog/pm-data-un-metier-en-pleine-expansion/
Data Product Manager : un métier en pleine expansion entre Product Management, Data et IA.
# Introduction
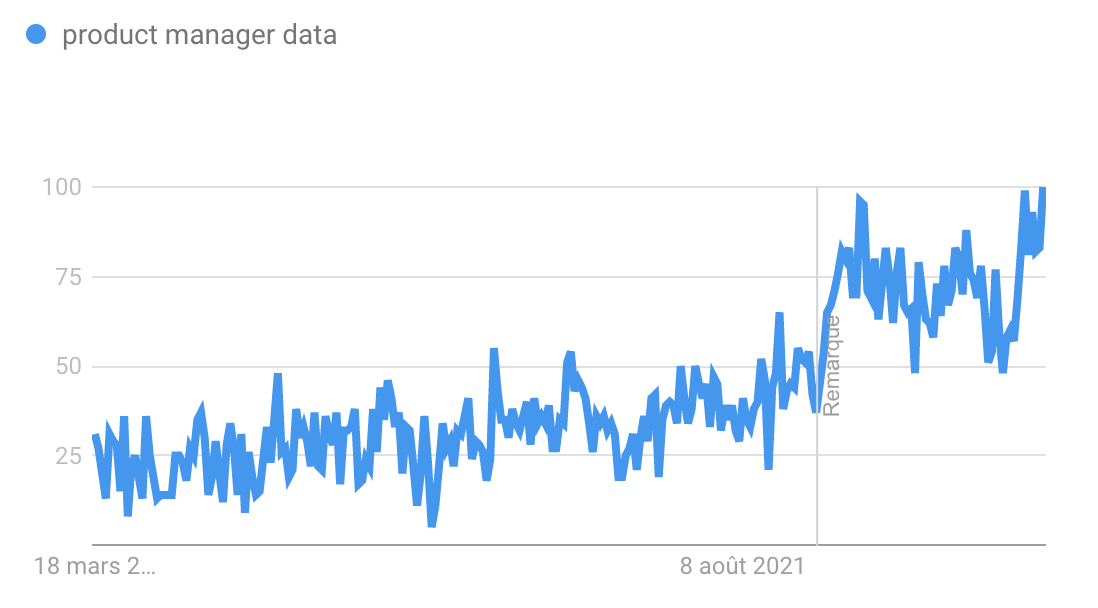
Data Product Manager, le métier le plus sexy du 21ème siècle ? S’il est difficile de répondre à cette question, il est en tout cas certain que ce terme se retrouve sur de plus en plus de lèvres, tant dans les [recherches de postes que dans les j\_ob titles\_ au sein des entreprises](https://trends.google.fr/trends/explore?date=today%205-y&q=Data%20Product%20Manager&hl=fr).
Cet article a pour objectif de démystifier ce qui se cache derrière ce métier, d’où il vient et ses perspectives d’avenir.
Nous verrons dans quelles circonstances il a vu le jour, ses différentes déclinaisons actuelles ainsi que les compétences clés d’un Data Product Manager. Enfin, nous vous dévoilerons la portée de ce métier au sein de l’évolution organisationnelle qu'implique la mise en place d'un Data Mesh.
## Le constat : la Data prend une place grandissante dans les organisations, mais en tirer de la valeur est toujours difficile
### L’importance de la data pour les organisations
Depuis l’[explosion du Big Data dans les années 1990/2000](https://towardsdatascience.com/2003-2023-a-brief-history-of-big-data-25712351a6bc), la data n’a cessé de gagner en reconnaissance et en potentiel d’impact. Au fil des années, ce domaine a continué à se développer et la quantité de données produites a considérablement augmenté, tout comme les technologies qui ont améliorées l’analyse des données.
Cette évolution a considérablement renforcé l’importance de l’utilisation des données au sein des organisations.
### Peut-on tirer de la data une réelle valeur ?
Aujourd’hui, de plus en plus de produits et solutions veulent intégrer la donnée dans leur coeur. Mais une donnée à l’état brut n’a que peu de valeur pour le business, et celle-ci est contextuelle (ce qui a de la valeur pour une organisation n’en a peut-être pas pour une autre). C’est donc une fois qu’elle est bien définie, transformée et gouvernée qu’elle peut être utilisée pour répondre aux besoins de l’entreprise et de ses clients et apporter de la valeur via ce que l’on appelle des **Produits Data**.
Et c’est bien là toute la difficulté. De nombreux obstacles et écueils se dressent devant nous pour réellement gagner en impact à l’échelle grâce à la data. Pour en savoir plus, je vous invite à [consulter notre livre blanc sur ce sujet.](https://app-eu1.hubspot.com/documents/25577569/view/527019720?accessId=81d8c3)
### L’existant : le Product Management est maintenant une discipline mature et structurée
Maximiser la valeur d’un produit (quel qu’il soit), tel est en essence le rôle d’un Product Manager. Dans son livre Inspired, Marty Cagan, décrit le métier de Product Manager comme consistant à “[découvrir un produit qui soit à la fois utilisable, réalisable et qui apporte de la valeur](https://www.mindtheproduct.com/what-exactly-is-a-product-manager/)” .
N’est-ce pas tout ce qui manque à la data pour enfin apporter de la valeur de manière pérenne ?
Obtenir de la valeur à partir des données nécessite en premier lieu de **comprendre en profondeur le problème utilisateur auquel on souhaite répondre**.
Cela nécessite aussi une certaine rigueur de planification, de coordination et d’engagement. Sans cela, il est facile de tomber dans le [piège du POC infini](https://www.hymaia.com/blog/tomber-dans-le-piege-du-poc-infini).
Et c’est bien ce que cherche à faire au quotidien un Product Manager !
## La solution : le Data Product Manager
Ce n’était donc qu’une question de temps avant que ces deux disciplines se rencontrent. La convergence entre la nécessité d’une gestion efficace des données et la structuration du métier de Product Manager en dehors de contextes data a permis l’émergence d’une nouvelle discipline : le **Data Product Management**.
On peut donc définir le Data Product Manager de la manière suivante :
Le Data Product Manager est un acteur de la construction de Produits au sein desquels la Data est un facteur clé de succès et de valeur.
Comme vous l'aurez remarqué ici nous ne parlons pas de PM conventionnel qui utilise la data pour être “Data Informed”. Nous aborderons ce sujet dans un autre article.
Il est essentiel de souligner que le Product Manager aurait avantage à posséder des compétences en données pour être "Data Informed" ou "Data Driven" et ainsi prendre des décisions grace à la data. En mesurant les performances de son projet et en identifiant les domaines nécessitant des améliorations ou des ajustements pour atteindre les objectifs fixés, le PM pourra ainsi répondre aux besoins du client et apporter de la valeur à son produit.
## Un Produit Data reste un Produit
Il est courant de considérer les Produits Data comme une catégorie à part, avec des règles distinctes.
C’est notamment l’exemple des projets de data science qui peuvent souvent rester en phase de POC sans être déployés en production, ce qui souligne la nécessité de repenser notre approche. Selon une étude de Gartner, plus de 80% des projets de data rencontrent un échec, mettant en évidence l'importance d'une réflexion approfondie. Pour en savoir plus sur les raisons de ces échecs, je vous recommande de consulter cet [article informatif](https://www.hymaia.com/blog/plus-de-80-des-projets-data-ne-partent-pas-en-production).
S’il y a des spécificités inhérentes à la data (voir l’article ci-dessus) à prendre en considération, il est crucial de se rappeler que **les principes fondamentaux du Product Thinking et du Product Management s’appliquent également aux Produits Data et doivent être respectés**.
L'une des priorités les plus importantes est de fournir une valeur ajoutée aux clients et de répondre à leurs besoins.
Dans cette optique, il est essentiel d'établir une boucle de feedback rapide pour permettre une évolution continue du produit, assurant ainsi que le produit continue à apporter de la valeur aux utilisateurs.
Ceci reste vrai et applicable, que le Produit soit un Produit Data ou non.
## Différentes teintes de Data Product Managers en fonction des enjeux et des organisations
Product Manager et Data Product Manager ne doivent pas être considérés comme des métiers séparés, mais plutôt comme des métiers similaires ayant teintes ou des focalisations différentes.
Il nous paraît à ce titre essentiel de souligner que tout Product Manager gagnerait à tirer parti d’une bonne utilisation de la donnée générée par son Produit, et ainsi prendre des décisions plus éclairées (on parle alors de Data-Informed ou bien encore de [Data Driven Product Management](https://www.mindtheproduct.com/category/data-driven-product-management/)).
En mesurant les performances de son produit et en identifiant les domaines nécessitant des améliorations ou des ajustements pour atteindre les objectifs fixés, le PM pourra ainsi répondre aux besoins du client et avoir un plus grand impact.
Au sein même des Data Product Managers, certaines spécialisations peuvent faire leur apparition dans certaines organisations :
- Le **PM Data Analytics** manage des Produits Data ayant pour but d’améliorer la connaissance et la stratégie du business (acquisition, rétention, segmentation du marché ou des clients, etc.), via notamment la création de datasets et dashboards ;
- Le **PM Data Science** manage des Produits Data au sein desquels l'intelligence artificielle et l'apprentissage automatique sont un facteur clé d’impact et de succès ;
- Le **PM Data Platform** manage une data platform comme un produit avec pour objectif d’accélérer et simplifier la création de nouvelles initiatives data (produits ou projets) dans l’organisation.
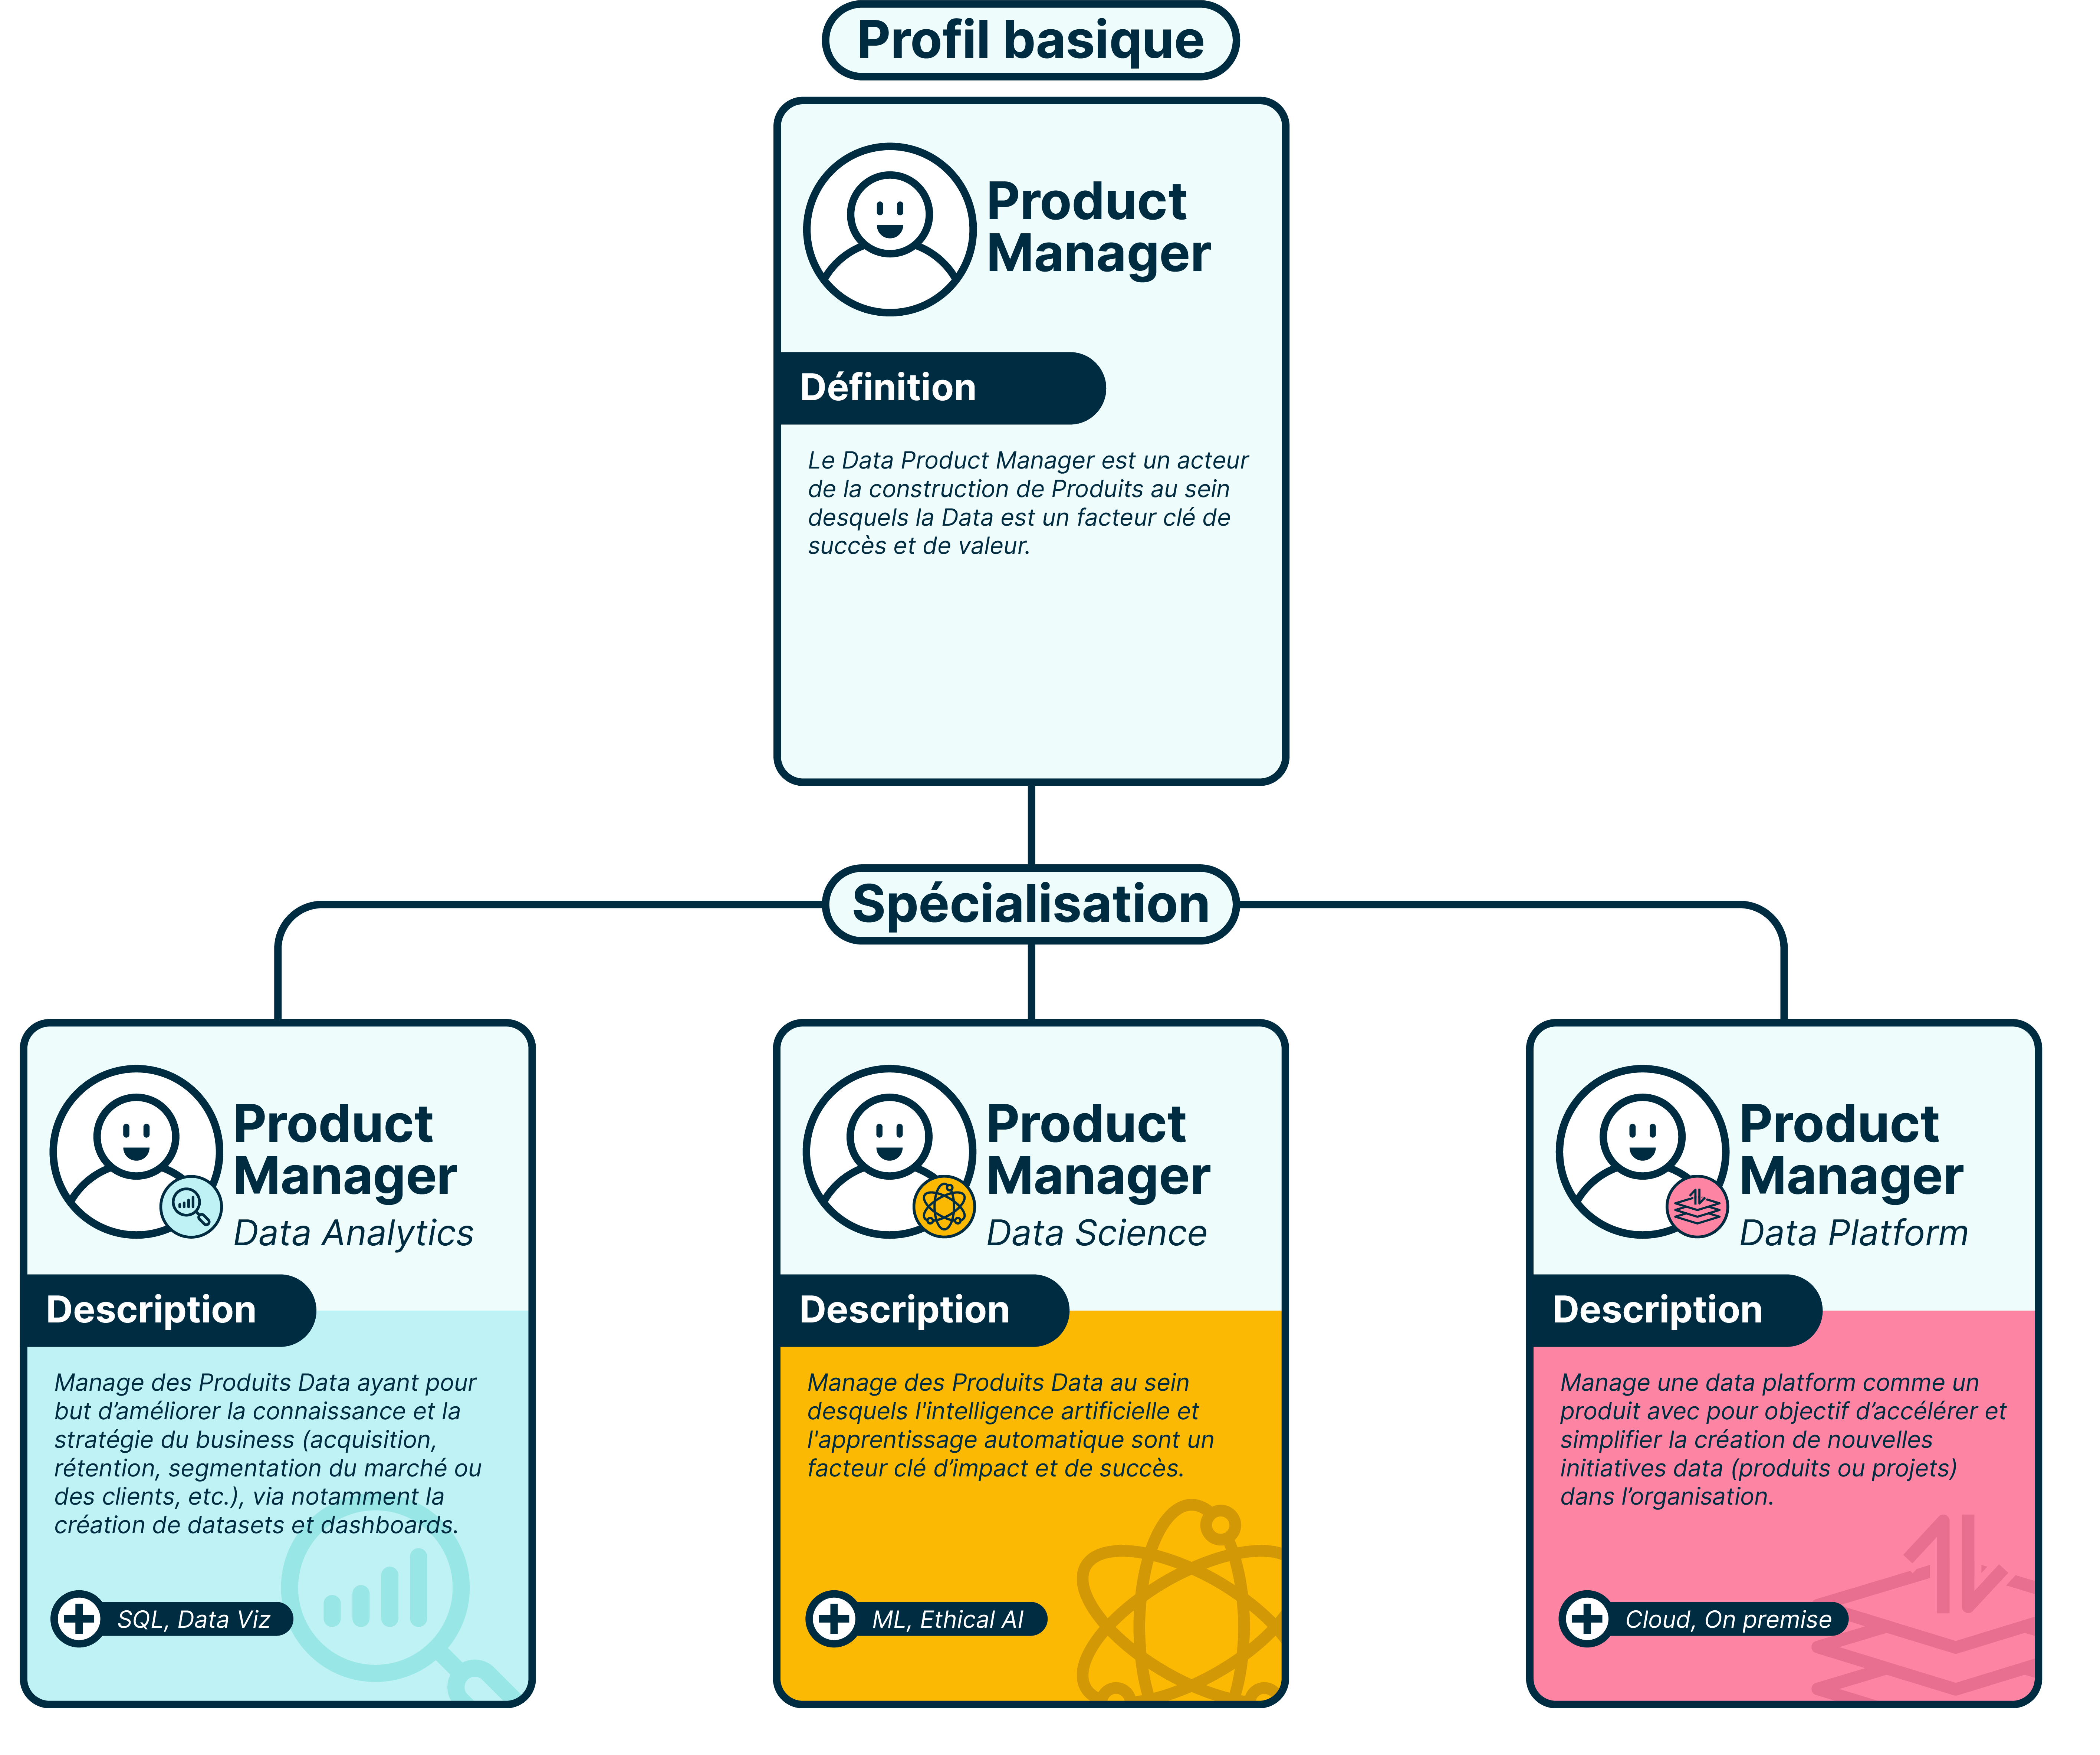
## **Les compétences des Data Product Manager**
On ne le répètera jamais assez : **un Data Product Manager est avant tout un Product Manager**, et possède donc les [3 appétences classiques que sont le Business, la User Experience et la Tech](https://www.mindtheproduct.com/what-exactly-is-a-product-manager/). À ce triptyque s’ajoute l’appétence pour la Data.
Le Data Product Manager maîtrise donc les compétences clés de gestion d’un Produit sur tout son cycle de vie : Discovery, Delivery et Run. Un Produit Data n’échappe pas à cette règle.
Ce que l’on demande en plus à un Data Product Manager, c’est d’avoir la curiosité et l’appétence nécessaire pour appréhender un autre cycle de vie, celui de la Data, qui se compose classiquement des éléments suivants :
- Collecte et Chargement
- Stockage
- Transformation
- Utilisation pour prise de décision
En fonction du contexte, une compréhension des enjeux de Data Management & Data Gouvernance peuvent aussi être d’une grande aide.
La Data Quality et Data Gouvernance sont des éléments transversaux au cycle de vie de la donnée défini ci-dessus
D’une manière générale, le Data Product Manager se doit d’avoir la curiosité nécessaire pour se forger une culture Data.
Ne plongeons pas non plus dans l’autre extrême, qui est de penser que le Data Product Manager se doit d’avoir une connaissance exhaustive de tout l’écosystème Data afin d’être pertinent. Il suffit de voir les représentations des différents outils et stacks pour se rendre compte de l’impossibilité de la tâche :
En revanche, une culture sur les sujets suivants peuvent être un excellent point de départ :
- Histoire du Big Data
- Différents types de données (structurées, semi-structurées, non structurées) et différents formats (csv, json, parquet…)
- Principaux Cloud Provider (GCP, AWS et Azure pour ne citer que les trois principaux)
- Quelques outils de stockage de données (Google Cloud Storage, Amazon S3, Azure Cloud Storage, snowflake…)
- Quelques outils de transformation de données (SQL, Spark, dbt, etc.)
- Quelques outils de Data Visualisation (Tableau, Power BI, Looker, etc.)
- Notions essentielles de Machine Learning
En outre, il peut être bénéfique pour le PM de se familiariser avec les principaux outils et logiciels pour la gestion de données et de se tenir informé des dernières tendances et évolutions dans le domaine de la data.
En somme, une solide culture de la donnée est un atout majeur pour tout PM souhaitant prendre des décisions éclairées, stratégiques et travailler main dans la main avec son équipe technique.
Enfin, si l’on zoome sur les 3 grandes catégories de Data Product Managers cités plus haut, certaines connaissances particulières peuvent être bénéfiques :
- Pour le **PM Data Analytics**, il s’agira de comprendre les bases de données relationnelles, faire du SQL son ami et possiblement réaliser ou comprendre des modélisations de donnée ;
- Pour le **PM Data Science**, connaître ce qu'est un modèle de Machine Learning, en définir un MVP et arbitrer entre complexité et usage du modèle est un aout essentiel, tout comme savoir quand le Machine Learning n’est pas la bonne solution ;
- Pour le **PM Data Platform**, une bonne vision des systèmes d’informations et des différentes composantes inhérentes à une Data Platform que sont l’ingestion, la transformation et l’exposition sera définitivement un accélérateur.
## Data Product Manager, un métier d’avenir ?
Le métier de Data Product Manager est toujours en cours de structuration, mais comme on a pu le constater, il prend ses racines dans un métier qui est maintenant bien établit depuis quelques années maintenant.
Et certains signes laissent à penser que le Data Product Manager continuera d’occuper une place de plus en plus grande au sein des entreprises (à titre d’exemple, [les projets "Move to Cloud" ont pesé 15,3 milliards d'euros](https://www.silicon.fr/services-numeriques-6-de-croissance-portee-par-le-cloud-en-2023-455178.html) (+24,5%) en 2022).
Parmi ces signes, la tendance actuelle vers la décentralisation de la Data, et notamment la transformation de certaines organisations vers les principes du [Data Mesh](https://www.youtube.com/watch?v=kzQTc2iBW3g&list=PL_h6mFCmTXr8GSAXQBKpPvhKCOrkPvQSt), où la notion de Data As A Product est clé, tend à promouvoir l’importance des Data Product Managers.
Le principe du Data As A Product consiste à considérer la Data d’un domaine métier comme un produit à part entière, partageable directement à de nombreux utilisateurs (Data Analysts, Data Scientists, Business Analysts, etc.).
L'équipe du domaine étant chargée de satisfaire les besoins des autres domaines en fournissant des données de haute qualité, elle est alors amenée à se doter d’un Data Product Manager, qui a pour responsabilité :
- De garantir le succès des Produits Data d’un domaine (dataset, datamart, dashboard, etc.) ;
- De délivrer la valeur, la satisfaction et la croissance des utilisateurs de la donnée ;
- De maintenir le cycle de vie des Produits Data.
La tendance est donc à la structuration du métier de Data Product Manager comme un élément clé dans les organisations futures des entreprises.
## **Conclusion**
Le Data Product Manager vient adresser ce besoin d’une plus grande orientation Produit au sein de la Data, afin d’être capable d’en exploiter son plein potentiel à l’échelle.
Product Manager avant tout, le Data Product Manager sait tirer parti des bonnes pratiques de Product Management et les appliquer aux spécificités du monde de la data, pour en faire émerger des Produits Data à fort impact business.
Longue vie au Data Product Manager !
**Quelques références complémentaires :**
- [DAMA - DMBOK, Data management body of knowledge](https://www.dama.org/cpages/body-of-knowledge)
- [Chief Data Officer - Pratique, outils et perspectives](https://www.amazon.fr/Chief-Data-Officer-Pratiques-perspectives/dp/2212573758)
- [Data Mesh: Delivering Data-Driven Value at Scale](https://www.amazon.fr/Data-Mesh-Delivering-Data-driven-Value/dp/1492092398)
- [Inspired - How to Create Tech Products Customers Love](https://www.amazon.fr/Inspired-Create-Tech-Products-Customers/dp/1119387507/)
Si vous envisagez d'intégrer la data et l'intelligence artificielle dans vos projets ou si vous êtes en phase de réflexion sur un produit d'IA mais que des doutes subsistent, n'hésitez pas à faire [appel](https://www.hymaia.com/contact) à nos experts. Nous sommes là pour vous aider et transformer vos idées en succès.
---
### Poetry : Configurer des repositories privées GCP
Source : https://www.hymaia.com/blog/poetry-configurer-des-repositories-privees-gcp/
Configurer Poetry avec un repository Python privé sur GCP Artifact Registry, pas à pas.
Nous avions déjà écrit un article sur [les fonctionnalités qu’offre Poetry sur le cycle de vie de votre code](https://www.hymaia.com/blog/poetry-enfin-loutil-pour-charmer-python). Cette fois-ci nous allons nous concentrer sur la configuration d’un repository Python privé déployé sur GCP avec [Artifact Registry](https://cloud.google.com/artifact-registry).
## Créer un repository Python privé sur GCP
Dans cet article nous allons créer notre repository Python sur GCP via le service managé Artifact Registry. Pour cela nous utiliserons **Terraform** :
CODE:https://gist.github.com/franck-cussac/00075253719ba99e965e9985434659c2.js
Configurer Poetry pour publier dans GCP Artifact Registry
### Ajouter un repository privé GCP à Poetry
Pour publier un package Python avec Poetry, il existe la commande suivante :
`poetry publish --build`
L’option `--build` indique à Poetry de construire le package avant de publier. Par défaut, Poetry publie dans Pypi, le repository public officiel de Python.
Pour pousser dans un repository privé, la configuration doit se faire sur Poetry au global et non pas dans un projet spécifique. Pour cela Poetry fourni une commande :
`poetry config repositories.`
À la place de `-python.pkg.dev///`
Cela nous donne :
`poetry config repositories.hymaia-repo` [`https://europe-west1-python.pkg.dev/hymaia/hymaia-pypi/`](https://europe-west1-python.pkg.dev/hymaia/hymaia-pypi/)
Nous pouvons maintenant reprendre notre commande de publish et ajouter un paramètre pour le repository :
`poetry publish --build --repository hymaia-repo`
Sauf qu’à présent, on se retrouve avec une erreur :
`HTTP Error 401: Unauthorized | b'The request does not have valid authentication credentials.\n'`
Cette erreur indique que nous n’avons pas d’identifications valides pour GCP.
### S’authentifier à un repository Python GCP
Lorsqu’on travaille avec GCP ou un Cloud Provider de manière générale, on a l’habitude d’utiliser un service managé IAM ([ou GIA en français, merci wikipédia)](https://fr.wikipedia.org/wiki/Gestion_des_identit%C3%A9s_et_des_acc%C3%A8s) pour s’authentifier. C’est pourquoi tous les outils fournis par GCP sont prévus pour fonctionner ainsi. La CLI gcloud, par exemple, nous permet de récupérer notre token d’authentification IAM via la commande suivante :
`gcloud auth application-default login`
Cette commande récupère un token d’authentification qui devra être celui utilisé par défaut. Plus concrètement, si vous travaillez sur Linux, cela crée ou met à jour le fichier `~/.config/gcloud/application_default_credentials.json` Les autres applications fonctionnant avec le IAM de GCP savent donc par convention où récupérer le token pour s’authentifier.
Dans notre cas, l’application qui doit travailler avec GCP est Poetry. Mais Poetry n’a rien à voir avec GCP, alors comment peut-il savoir comment s’y authentifier ? Même chose si nous travaillons avec AWS ou Azure. Chaque Cloud Provider a sa méthode d’authentification IAM et ce n’est pas à Poetry de les gérer. Poetry étant un outil de l’écosystème Python, le seul mode d’authentification qu’il connait est celui du standard de repository Python : `password lookup`
## S’authentifier à GCP avec Python
### Une fonctionnalité récente
Avant mai 2023 et la version 1.5.x, il n’était pas possible de configurer Poetry pour qu’il utilise l’authentification IAM de GCP pour publier dans Artifact Registry.
En Python il existe une bibliothèque officiellement supportée par Google pour récupérer automatiquement les tokens d’authentifications IAM : `keyrings.google-artifactregistry-auth`
Côté Poetry, dans les version 1.1.x, la stratégie d’authentification à un repository est fixée sur le password lookup. Ce qui signifie qu’à l’époque, impossible d’utiliser la bibliothèque de Google pour son authentification IAM. Une [issue github a donc été ouverte pour fallback en cas d’échec de ce mode d’authentification](https://github.com/python-poetry/poetry/pull/4086). Cette issue en a entraîné une autre côté GCP pour [supporter Poetry dans google-artifactregistry-auth](https://github.com/GoogleCloudPlatform/artifact-registry-python-tools/issues/17).
On s’est retrouvé avec une première évolution côté Poetry pour accepter d’autres modes d’authentification et une seconde côté GCP pour se conformer à la façon dont Poetry gère l’authentification. Un bel exemple de 2 projets open source qui collaborent.
### Ajouter le mode d’authentification GCP IAM à Poetry
Pour prendre en compte un nouveau mode d’authentification, Poetry a juste besoin d’avoir la bibliothèque correspondante d’ajoutée à son environnement Python. C’est exactement la même chose quand vous ajoutez une dépendance à votre projet. Pour cela, vous pouvez utiliser la commande :
`poetry self add keyrings.google-artifactregistry-auth`
Maintenant on peut relancer notre commande de publication :
`poetry publish --build --repository hymaia-repo`
Et cette fois-ci c’est tout bon !
## Récupérer un package Python dans GCP Artifact Registry
Lorsqu’on publie un package, c’est souvent pour le récupérer dans d’autres projets. Pour cela la procédure est encore plus simple :
### 1\. Configurer un nouveau repository privé
`poetry source add hymaia-repo` [`https://europe-west1-python.pkg.dev/hymaia/hymaia-pypi/simple`](https://europe-west1-python.pkg.dev/hymaia/hymaia-pypi/simple) `--priority=explicit`
### 2\. Ajouter la dépendance en précisant le repository
`poetry add my-package --source=hymaia-repo`
Évidemment il faut toujours être bien authentifié à GCP en mode `default-application` et avoir installé dans l’environnement virtuel de Poetry `keyrings.google-artifactregistry-auth` comme pour la publication d’une dépendance.
Et c’est fini !
---
### Poetry: enfin l’outil pour charmer Python ?
Source : https://www.hymaia.com/blog/poetry-enfin-loutil-pour-charmer-python/
Poetry simplifie la gestion des dépendances Python. Tour d’horizon de ses fonctionnalités.
Il est en effet assez facile de s’y perdre lors de la gestion des compatibilités entre les différentes versions des packages Python mais aussi et surtout avec les multiples versions de Python à disposition. Nous allons voir à l’aide ce billet de blog une solution nommée Poetry qui promet de nous faciliter la tâche et de rendre le packaging, le build ainsi que le déploiement de nos applications Python aussi simple que possible.
## Poetry: les concepts
Projet [open source](https://github.com/python-poetry/poetry), **Poetry** se base essentiellement sur des outils assez classiques dans le développement des projets Python tel que pip, venv ou pyenv mais apporte une surcouche qui change l’expérience développeur. Un projet géré par Poetry se base essentiellement sur deux fichiers : `pyproject.toml`et `poetry.lock`
Regardons ce que contiennent ces deux fichiers.
### **pyproject.toml**
À l’initialisation de votre projet il est composé de :
- `tool.poetry` **:** renseigne des informations sur votre projet (nom, version, description et auteur)
- `tool.poetry.dependencies` : les dépendances du projet installées dans un environnement de production
- `tool.poetry.dev-dependencies` : les dépendances du projet installées dans un environnement de dev
Cette distinction entre l’environnement de dev et celui de production nous permet en tant que développeur d’avoir des versions différentes de nos packages ou de nouvelles dépendances qu’il est inutile d’avoir en environnement de production, il est ainsi possible de tester de nouvelles fonctionnalités de manière sereine et isolée sans avoir à installer et ensuite désinstaller ces packages.
Il aura ainsi cette configuration à la création d’un projet nommé, par exemple `poetry-demo` :
CODE: [https://gist.github.com/ElhadiCherifi95/611d81ee5ba98bdde00493eb721e4b20.js](https://gist.github.com/ElhadiCherifi95/611d81ee5ba98bdde00493eb721e4b20.js)
Le fichier `pyproject.toml` peut incorporer à lui seul le contenu des fichiers `requirements.txt`, `setup.py`, `setup.cfg`, `MANIFEST.in` ainsi que le fichier `Pipfile` . L’ensemble des fonctionnalités qu’il est possible d’intégrer sont listées [ici](https://python-poetry.org/docs/pyproject).
Notez aussi l’utilisation de wildcard `python = "*"` ou encore `pytest = "^7.1"` pour spécifier les versions de vos dépendances, cette manière de faire offre la possibilité de maitriser les futurs versions que Poetry va installer dans le cas d’un update. Elles ne sont pas forcément figées à une version particulière. Nous y reviendrons un peu plus tard dans l’article.
### **poetry.lock**
Une fois vos dépendances installées, **Poetry** génère un fichier `poetry.lock` qui centralise toutes les versions exactes de votre projet Python. Ce fichier est capital pour figer les versions des dépendances utilisées. En effet, étant donné que dans le fichier `pyproject.toml` les versions citées ne sont pas précises avec l’utilisation des [_wildcards_](https://fr.wikipedia.org/wiki/M%C3%A9tacaract%C3%A8re) et qu’ils sont souvent amenées à évoluer dans le cas d’une mise à jour, le fichier `poetry.lock` les renseigne et nous garantit que si ces versions exactes sont installées, alors le projet peut être construit.
C’est une bonne pratique de rajouter le fichier `poetry.lock` à git pour garantir aux développeurs (y compris vous même), à votre CI ou encore vos serveurs de production la résilience de votre projet en cas d’une nouvelle release de vos dépendances.
Le fichier `pyproject.toml` représente la vision à long terme des dépendances en cas d’update, ce qui nous permet d’être serein si un update à lieu. Le fichier `poetry.lock` quand à lui **fige** les versions avec lequelles le programme marche en ce temps T (ce qui assure que le code n’aura pas de conflit de dépendances sur aucune des machines (local, sur la CI, en production,
## Poetry: dans la vraie vie
La surcouche apportée dans **Poetry** nous apporte une facilité déconcertante dans le développement des projets Python, ainsi il suffit de lancer les commandes suivantes pour:
- **Créer**/**Activer un virtual environment:**
CODE: [https://gist.github.com/ElhadiCherifi95/3fc8821430c32cbe1c39e397771448a6.js](https://gist.github.com/ElhadiCherifi95/3fc8821430c32cbe1c39e397771448a6.js)
- **Ajouter supprimer ou updater une dépendance:**
CODE: [https://gist.github.com/ElhadiCherifi95/6069c546fbeece7d30ca911d538e36b9.js](https://gist.github.com/ElhadiCherifi95/6069c546fbeece7d30ca911d538e36b9.js)
Cette requête est très utile pour avoir une idée claire des versions utilisées, elle a pour résultat une sorte d’arbre qui contient les dépendances, leurs versions mais aussi les sous dépendances installées, voici son retour pour le projet de démo:

- **Installer les dépendances:**
CODE: [https://gist.github.com/ElhadiCherifi95/f81a863ade0c40891cb0c62f9b0918e7.js](https://gist.github.com/ElhadiCherifi95/f81a863ade0c40891cb0c62f9b0918e7.js)
**Poetry** récupère l’ensemble des versions à installer à partir du fichier `poetry.lock` s’il est existant. Et s’il n’existe pas (au début du projet par exemple), Poetry se base sur le fichier `pyproject.toml` pour récupérer les dernières versions disponibles des packages cités.
- **Build son application:**
CODE: [https://gist.github.com/ElhadiCherifi95/833deab23fdafc55d53ed470673fc8d6.js](https://gist.github.com/ElhadiCherifi95/833deab23fdafc55d53ed470673fc8d6.js)
Cette commande génère un fichier `.wheel` et un fichier`.sdist` qui représentent votre projet sous forme de package livrable et réutilisable.
- **Publier son application:**
CODE: [https://gist.github.com/ElhadiCherifi95/a1a5f2fa884e6b9bd753d98cfcbc1bdc.js](https://gist.github.com/ElhadiCherifi95/a1a5f2fa884e6b9bd753d98cfcbc1bdc.js)
Cette commande permet de déployer votre projet dans un repository privé qui a été préalablement configuré. Si l’option -r n’est pas spécifiée, le déploiement se fera dans [pypi](https://pypi.org/).
- **Exécuter du code python:**
CODE: [https://gist.github.com/ElhadiCherifi95/82e78702fd16dc1b17acd5b1c9cb2614.js](https://gist.github.com/ElhadiCherifi95/82e78702fd16dc1b17acd5b1c9cb2614.js)
- **Changer d’environnement Python:**
CODE: [https://gist.github.com/ElhadiCherifi95/e5c0f253b855fd9f00c0dd3dfdcd89cc.js](https://gist.github.com/ElhadiCherifi95/e5c0f253b855fd9f00c0dd3dfdcd89cc.js)
- **Lancer les tests unitaires avec pytest:**
CODE: [https://gist.github.com/ElhadiCherifi95/c159ceffe6ff8a2139ab19cdea31112a.js](https://gist.github.com/ElhadiCherifi95/c159ceffe6ff8a2139ab19cdea31112a.js)
## Spécifier la version des dépendances avec Poetry
Comme cité plus haut, il est possible de configurer précisément les nouvelles versions de nos dépendances que **Poetry** est amené à installer lors d’une commande d’update. Géré par des wildcards, cette manière de faire nous permet d’assurer une actualisation de nos dépendances en évitant, si on le souhaite, de passer à des versions majeures pour éviter de casser la compatibilité.
Par exemple, pour spécifier qu’une dépendance ne peut être actualisée en version majeure on peut utiliser la syntaxe suivante dans votre fichier `pyproject.toml` :
CODE: [https://gist.github.com/ElhadiCherifi95/2185d5aa525a8a15dc6fc27c9781d7ad.js](https://gist.github.com/ElhadiCherifi95/2185d5aa525a8a15dc6fc27c9781d7ad.js)
Cette spécification permettra de mettre à jour le package pytest jusqu’à la version **1.3.0**. Ainsi, si une version majeure 2.0.0 est amenée à exister, elle ne sera pas installée pour éviter d’avoir des erreurs de rétro-compatibilité. Pour voir l’ensemble des possibilités que propose Poetry concernant les wlidcards, tout est listé [ici](https://python-poetry.org/docs/dependency-specification/).
## Conclusion
**Poetry** regroupe à lui seul un ensemble d’outils que l’on devait auparavant utiliser individuellement pour faire vivre nos projets Python (pyenv, venv, pip, twine, ...). Et il fait bien plus que cela, en s’assurant d’avoir toujours un projet qui a des dépendances à jour sans forcément casser la compatibilité.
---
### Produits Data Science - 6 approches de modélisation pour créer rapidement votre MVP
Source : https://www.hymaia.com/blog/produits-data-science-6-approches-de-modelisation-pour-creer-rapidement-votre-mvp/
6 approches pour créer un MVP Data Science sans attendre le modèle parfait.
Nous nous focalisons donc sur la partie modélisation dans cet article, mais les composants essentiels d’un MVP de Produit Data Science sont bien plus nombreux. Pour mieux comprendre cela, nous vous invitons à lire [**_notre article expliquant pourquoi il ne faut pas attendre d’avoir un modèle parfait avant de penser à l’industrialisation_**](https://www.hymaia.com/post/produits-data-science-nattendez-pas-le-modele-parfait-avant-dindustrialiser)**_._**
**Notre Use Case :**
Pour illustrer chacune de ces approches, nous partirons d’un Use Case de catégorisation de mails en “à traiter d’urgence” versus “peu urgent”, dans une optique de création d’un outil d’aide à la gestion des boites mail de ses utilisateurs.
## Approche 1 - #NoML : Le retour des règles métier
Il se peut que votre égo de Data Scientist en prenne un coup, mais il n’est pas rare de se rendre compte que le simple fait de croiser, nettoyer et mettre à disposition des informations via des **règles métier bien pensées** réponde déjà de manière très satisfaisante à des points de douleur de vos utilisateurs. Alors pourquoi s’en priver ?
**En allant à la rencontre de vos utilisateurs**, si vous constatez que certaines choses sont faites à la main depuis des années et qu’il y a un potentiel d’automatisation par des heuristiques simples, vous avez l’opportunité de leur faire faire un gain de temps considérable. Et cerise sur le gâteau, c’est une manière simple et rapide de **gagner la confiance et l’adhésion de vos interlocuteurs**, ce qui rendra beaucoup plus simple l’adoption de modélisations beaucoup plus complexes.
**_Mise en application pour notre Use Case_**
- _Mise en place de règles sur des notions temporelles : repérer les tournures du type “avant le” ou “réponse attendue pour le”, etc._
- _Récolte d’une liste de contacts prioritaires pour qui un délai de réponse minimal est un enjeu majeur_
## Approche 2 - Human Learning : La prise de décision par un être humain
Pour certains cas d’usage, il se peut qu’aucune règle métier simple n’existe pour faire une première version simple d’algorithme, alors que vous avez besoin d’un niveau de confiance et de performance élevé dès le début. Dans ce cas, il peut être pertinent d’étudier l’option de **déléguer complètement la partie habituellement traitée par une IA à un être humain.**
Cette approche permet 2 choses :
- Vérifier que cela apporte vraiment de la valeur d’avoir un tel produit avant de se lancer dans du Machine Learning
- Avoir des premières données labélisées qui serviront pour entraîner un futur algorithme de Machine Learning pour apprendre des patterns à partir des classifications faites pas les humains.
**_Mise en application pour notre Use Case_**
- _Industrialisation de toute la pipeline d’ingestion et de préparation de la donnée jusqu’à fournir une donnée qu’un être humain devra classifier, pour qu’il fournisse ensuite le résultat au reste de la pipeline._
- _Réincorporation progressive de Machine Learning, afin de classifier automatiquement les textes pour lesquels la certitude est très élevée, et d’envoyer ceux pour lesquels l’incertitude est la plus élevée à l’expert humain._
## Approche 3 - Keep It Simple : Un modèle de ML simple
Une simple régression linéaire ou logistique peut vous permet d’atteindre un **niveau de performance tout à fait acceptable et apportant déjà de la valeur à vos utilisateurs en termes de prise de décision**. Ces modèles ont le mérite d’être simples à comprendre, rapide à implémenter, voir même transposables en règles métier si nécessaire. Le gain en valeur peut déjà être colossal.
Ce modèle simple peut vous permettre de vous concentrer sur les autres briques de votre chaîne de traitement pour votre MVP afin de délivrer de la valeur directement en production. Il est entendu que **faire simple n’est pas toujours si simple !**
**_Mise en application pour notre Use Case_**
- _Feature Engineering basé sur du “_[_Bag of Word_](https://fr.wikipedia.org/wiki/Sac_de_mots)_”, voir du_ [_TF-IDF_](https://fr.wikipedia.org/wiki/TF-IDF)
- _Modélisation via une Régression Logistique (éventuellement avec de la régularisation)_
- _Interprétation métier des poids de chaque mot ou groupement de mots_
## Approche 4 - Be Lazy : Les services managés des cloud providers
Que ce soit pour l’analyse d’images, de vidéos ou de textes, **de nombreux services haut niveaux proposés par les cloud providers vous permettent d’obtenir des résultats à une vitesse incroyable**, en bénéficiant de la force de frappe de ces derniers pour un coût limité. A titre d’exemple, vous retrouverez des services comme [Amazon Rekognition](https://aws.amazon.com/fr/rekognition/) ou encore [Google AutoML](https://cloud.google.com/automl).
Il est probable que le service managé en question ne réponde pas exactement à votre Use Case, mais un retravail des résultats obtenus peut souvent être suffisant pour retomber sur vos petits.
Cette approche a le mérite de vous permettre de “déléguer” la partie Intelligence Artificielle pour le moment et vous concentrer sur le reste de la chaîne de traitement pour la constitution de votre MVP. En fonction de vos priorisations, il sera ensuite temps de reprendre en main la partie IA via vos propres développements.
**_Mise en application pour notre Use Case_**
- _Utilisation de_ [_Google AutoML Text Classification_](https://cloud.google.com/natural-language/automl/docs/samples/automl-language-text-classification-create-model) _pour créer un pipeline de bout en bout_
- _Utilisation de Google AutoML pour l’_[_extraction d’entités nommées_](https://cloud.google.com/natural-language/automl/docs/samples/automl-language-entity-extraction-create-model)_, puis entraînement d’un modèle simple type Régression Logistique_
## Approche 5 - Big but Simple : Le Transfer Learning
Si vous souhaitez entraîner vos propres réseaux de neurones dans le cadre de votre Use Case et que l’architecture cible de ce modèle est complexe, se tourner vers une approche de type **Transfer Learning** peut s’avérer efficace. En effet, il existe **de nombreux modèles pré-entraînés disponibles en open source** (ex: [TensorFlow Hub](https://www.tensorflow.org/hub?hl=fr)) que vous pouvez utiliser tels quels, ou bien en ne ré-entraînant que les dernières couches de ces derniers.
Cela permet ainsi de capitaliser sur les nombreuses heures d’entraînement de ces réseaux de neurones profonds, et de les spécialiser pour votre tâche précise ensuite. Pour des problématiques de type classification d’images ou de texte, cette approche s’avère souvent très performante dès les premières versions du modèle.
**_Mise en application pour notre Use Case_**
- _Utilisation de TensorFlow Hub pour récupérer un modèle de_ [_Text Embedding_](https://tfhub.dev/s?module-type=text-embedding) _ou de_ [_Text Classification_](https://tfhub.dev/s?module-type=text-classification)
- _Utilisation de modèles d’_[_embedding directement dans son code TensorFlow_](https://www.tensorflow.org/text/api_docs/python/text/BertTokenizer?hl=fr)
## **Approche 6 - Not Reinventing the Wheel : Capitaliser sur des projets déjà industrialisés**
En parlant de capitaliser, il n’est pas toujours nécessaire de regarder à l’extérieur pour développer des premières versions intéressantes de vos modèles. En effet, il est possible que le Use Case sur lequel vous êtes en train de travailler puisse ressembler à un précédent développé par une autre équipe.
Cela peut par exemple être une **ressemblance en termes de type de modélisation, ou bien de pre-processing de la donnée**. Cela vous permet ainsi d’obtenir des blocs de code testés et industrialisés sur lesquels vous appuyer pour ne pas repartir de zéro.
**_Mise en application pour notre Use Case_**
- _Récupération d’un modèle de pré-traitement de texte d’une boite mail catégorisée : détection de langue, gestion des stop-words, lemmatization, stemming, etc._
- _Récupération d’un code industrialisé pour le tuning automatique de modèles_
## En conclusion : “plus **simple” n’est pas synonyme de “moins performant”**
Comme on peut le voir, il n’est pas forcément nécessaire de se restreindre à l’option “modèle simple et moins performant” pour créer rapidement un MVP d’un produit Data Science, d’autres approches permettent d’avoir dès le départ des modélisations avancées.
Bien entendu, certaines approches ne seront pas applicables à votre contexte ou votre Use Case. Vous pouvez aussi en combiner, ou bien démarrer par l’une pour enchaîner avec l’autre (ex : démarrer par des règles métier, puis un modèle simple, puis du Transfer Learning).
Et vous ? Quelles sont vos approches pour rapidement apporter de la valeur en production pour votre Produit Data Science ?
---
### Produits Data Science - N’attendez pas le modèle parfait avant d’industrialiser !
Source : https://www.hymaia.com/blog/produits-data-science-nattendez-pas-le-modele-parfait-avant-dindustrialiser/
Passez rapidement au MVP de bout en bout plutôt que de perfectionner votre modèle de ML.

Ou autrement dit : _“Est-ce que je dois continuer à passer du temps à améliorer mon modèle de Machine Learning pour obtenir de meilleures performances, ou bien peut-on passer à l’industrialisation du Use Case ?”._
Notre conviction est qu’**un modèle de Machine Learning (ML) n’a que très peu de valeur en soi, c’est son utilisation en production et en réponse à une problématique métier précise qui est importante.** Et pour cela, rien de mieux que de rapidement passer à la création d’un MVP de bout en bout.
Avant toute chose, précisons que la notion de MVP (Minimum Viable Product) que nous utilisons ici se réfère à un produit minimaliste (découpé via une Story Map) mais implémenté en production, qui peut être différent d’autres notions de MVP du Lean Startup par exemple.
## Pourquoi il ne faut pas attendre trop longtemps avant de penser MVP ?
### Éviter de se rendre compte _in fine_ que le modèle n’est pas exploitable en production
Plusieurs raisons peuvent amener à cette conclusion : un temps de latence trop élevé, une taille du modèle trop grande, un modèle qui n’est pas adapté pour le temps réel, qui n’est pas compatible avec les contraintes techniques des environnements de production, une dégradation trop rapide des performances ou encore une interprétabilité très limitée.
### Votre modèle de Machine Learning n’est pas votre seule préoccupation
Un modèle de ML n’est qu’un tout petit morceau de l’ensemble de la chaîne de traitement nécessaire pour implémenter un produit Data Science de bout en bout.
Il est nécessaire de voir un produit Data Science comme un ensemble, et pas uniquement sous le spectre du modèle de Machine Learning. Passer rapidement à la création d’un MVP permet de se rendre compte au plus tôt de la difficulté potentielle de créer une chaîne de traitement complète, de l’ingestion de données à l’activation des résultats par un utilisateur final.

### Lever les principales incertitudes
Dans la majorité des cas, votre objectif dans une phase initiale d’un projet Data Science ne doit pas être de savoir quelle performance maximale du modèle vous pouvez atteindre, mais plutôt de **lever les principales incertitudes inhérentes à un projet Data Science** : _ma donnée est-elle de qualité ? puis-je croiser mes différentes sources ? Est-il techniquement possible de faire ce type de prédiction ? Quel niveau de performance puis-je atteindre sans effort ? Voyons-nous un fort potentiel d’amélioration de ces performances ?_
### Valider la faisabilité technique de bout en bout
Une fois que vous avez obtenu des réponses à ces questions et baissé votre niveau d’incertitude sur le potentiel business de votre Use Case, il est grand temps de **lever les obstacles liés à la faisabilité technique à travers l’implémentation d’un MVP de bout en bout.** C’est en reliant toutes les briques entre elles que vous vous rendrez compte de vos principaux obstacles, et que vous réaliserez probablement que le fait de gagner 0.2% de performance dans votre modèle n’est que le cadet de vos soucis !
### Faire simple ne veut pas dire faire moins performant
Il n’est pas forcément nécessaire de se restreindre à l’option “modèle simple et moins performant” pour créer rapidement un MVP d’un produit Data Science, [**d’autres approches permettent d’avoir dès le départ des performances tout à fait intéressantes**](https://www.hymaia.com/post/produits-data-science-6-approches-de-modelisation-pour-creer-rapidement-votre-mvp).

## La mesure de l’impact doit être votre North Star
### Être au clair sur la problématique à résoudre
Si vous êtes clair sur la **problématique à résoudre** et sur la **manière de mesurer votre impact** (la valeur apportée par votre produit), alors le fait de vous lancer rapidement dans la réalisation d’un MVP est un moyen très efficace de vous assurer que vous apportez réellement de la valeur à ce problème.
Et parfois, oui, lorsque l’on a passé un temps conséquent à **réellement comprendre la problématique de nos utilisateurs**, une Data Visualisation claire ou quelques règles métier bien pensées pourront apporter une incroyable valeur.
Au contraire, lorsque votre focus est principalement axé sur le modèle sans être absolument certain qu’il aidera parfaitement à répondre à la problématique métier, vous risquez de **créer de la confusion et de la frustration**.
### Prioriser sur l’apport de valeur de votre produit, pas les performances de votre modèle
Avoir rapidement un MVP avec une chaîne de traitement de bout en bout d’implémenté en production permet de se poser les bonnes questions et de **faire les bonnes priorisations.** Est-ce vraiment sur l’amélioration des performances du modèle que je dois concentrer toute mon énergie ? Grâce à la boucle de feedback mise en place, n’y a-t-il pas d’autres zones de travail permettant de faire un **plus grand gain en apport de valeur** (focus sur la qualité de la donnée, incorporation de nouvelles sources de données, retravail de la mise à disposition des résultats, etc.) ?
### Dimensionner votre projet sous plusieurs angles
Au-delà des approches concernant la partie modélisation, pensez aussi à **dimensionner votre MVP en termes de scope d’intervention**. Afin d’apporter de la valeur, avez-vous besoin d’avoir un modèle performant sur l’ensemble de vos catégories de produits ? Ne peut-on pas nous limiter dans un premier temps aux catégories les plus vendues ou les plus à potentiel ?
Ajouter des dimensions ajoute de la complexité, et potentiellement des difficultés à bien comprendre nos erreurs et nos zones d’amélioration.
En conclusion, il nous paraît essentiel de penser son produit Data Science comme un tout dès son début d’implémentation, et non pas le regarder par le seul et unique prisme du modèle de Machine Learning.
---
### Produits d’IA - Kit de survie pour Product Managers Ambitieux
Source : https://www.hymaia.com/blog/produits-dia---kit-de-survie-pour-product-managers-ambitieux/
Le kit de survie pour Product Managers qui se lancent dans les Produits d’IA.
## Naviguer dans le monde des Produits d’IA en tant que Product Manager
Intelligence Artificielle, Data Science, Deep Learning, IA Générative, Machine Learning, …
En tant que Product Manager, tu as forcément entendu parler de ces termes au cours des dernières années, et probablement encore plus fortement récemment avec les dernières avancées en matière d’IA.
Et il y a fort à parier que ces mots évoquent chez toi un mélange d’excitation et de peur. Encore plus si tu dois maintenant sur travailler un Produit d’IA.
Le but de ce kit de survie est de te permettre de démêler le vrai du faux et de te donner le bagage essentiel pour collaborer efficacement avec des équipes Data afin de créer des Produits d’IA apportant une réelle valeur et répondant à de vrais problèmes utilisateurs.
Il y a quelques spécificités inhérentes au monde de la Data qu’il est intéressant pour toi d’intégrer à ton arsenal afin d’avancer sereinement. Cependant, n’oublie jamais que la base reste la même et que les bonnes pratiques de Product Management s’appliquent toujours.
Mais avant toute chose, c’est quoi un Produit d’IA ?
Tout simplement un Produit comme un autre, au sein duquel est exploité des capacités d’Intelligence Artificielle. L’IA peut aussi bien être le coeur névralgique du produit (ChatGPT en est un bon exemple) qu’un tout petit composant d’un ensemble bien plus vaste (pense à la recommandation de produits qui pourraient aussi te plaire sur Amazon ou Netflix).
En lisant cela, tu pourrais très bien te dire “bin, c’est un Produit comme un autre quoi, pas besoin de lui donner un nom particulier juste pour faire joli !”. Et au fond, tu as raison.
Mais, sois honnête, aurais-tu ouvert ce billet de blog si le terme IA n’était pas écrit dans le titre ?
Plus sérieusement : notre conviction est que demain, tous les Produits incorporeront de l’IA, et donc tous les Produits seront en quelque chose des Produits d’IA. Viendra un jour où, c’est certain, il ne sera plus nécessaire de leur donner une appellation particulière puisque ce sera le nouveau standard. Mais ce jour n’est pas encore arrivé, et donner une appellation particulière permet de se concentrer pleinement sur ce qui fait d’un Produit d’IA quelque chose de particulier à appréhender.
## Le kit de survie pour Product Manager ambitieux
De la collaboration avec les équipes Data à la manière d’appliquer une démarche Produit aux spécificités de l’IA, nous avons rédigé un livre qui se veut simple et actionnable afin de t’aider à éviter certains pièges et créer des Produits d’IA à forte valeur ajoutée.
Pour te le procurer, rien de plus simple. Tu peux te le procurer en version imprimée sur [Amazon](https://www.amazon.fr/Produit-dIA-survie-pour-ambitieux/dp/B0CRPZBFKF).
Tu trouveras ci-dessous l’ensemble des thématiques qui sont abordées dans le livre, les sources citées ainsi que des ressources additionnelles utiles.
Tu as devant toi de merveilleux challenges à relever, et nous espérons que ce livre t’accompagnera dans ce chemin.
## Sources citées dans le livre et ressources utiles pour aller plus loin
### 1 - Entrer en contact sans se faire rejeter
5 phrases pour briller en soirée auprès d’experts Data
- [DataFrames PySpark & Pandas : très similaires à l'usage, mais un fonctionnement interne très différent](https://www.hymaia.com/blog/dataframes-pyspark-pandas)
- [Qu'est-ce que l'Error Analysis ?](https://www.hymaia.com/qu-est-ce-que/error-analysis)
- [Qu’est-ce que la Data Literacy ?](https://www.hymaia.com/qu-est-ce-que/data-literacy)
- [Qu’est-ce que Spark ?](https://www.hymaia.com/qu-est-ce-que/spark)
- [Data Literacy - 4 actions pour démocratiser la Data](https://www.hymaia.com/blog/data-literacy-4-actions-pour-commencer-a-democratiser-la-data-au-sein-de-votre-entreprise)
- [L’acculturation à la data n’est pas un travail unidirectionnel](https://www.hymaia.com/blog/lacculturation-a-la-data-nest-pas-un-travail-unidirectionnel)
- [La Data n’est pas une fin en soi](https://www.hymaia.com/blog/la-data-nest-pas-une-fin-en-soi)
### 2 - Etablir une vision produit
Comment cadrer et créer une vision produit pour un Produit d’IA ?
- [Interview - Data Product Management chez Aramis Group](https://www.youtube.com/watch?v=Flx9rCNdz3k)
- [The Business Model Canvas](https://www.strategyzer.com/library/the-business-model-canvas)
### 3 - Se préparer aux échecs
Pourquoi 80% des projets d’IA ne vont pas en production ?
- [Plus de 80% des projets data ne partent pas en production, et alors ?](https://www.hymaia.com/blog/plus-de-80-des-projets-data-ne-partent-pas-en-production)
- [Why do 87% of data science projects never make it into production?](https://venturebeat.com/ai/why-do-87-of-data-science-projects-never-make-it-into-production/)
- [Gartner Top Strategic Predictions](https://www.gartner.com/smarterwithgartner/gartner-top-strategic-predictions-for-2019-and-beyond)
### 4 - Rassembler une team
Quelle équipe-type pour créer un Produit d’IA ?
- [Data Product Manager, un métier en pleine expansion](https://www.hymaia.com/blog/pm-data-un-metier-en-pleine-expansion)
- [3 enseignements à connaître avant de créer son équipe data](https://www.hymaia.com/blog/3-enseignements-a-connaitre-avant-de-creer-son-equipe-data)
### 5 - Construire un MVP
Comment convaincre un.e Data Scientist qu’une règle métier ce n’est pas sale ?
- [Produits Data Science - N’attendez pas le modèle parfait avant d’industrialiser !](https://www.hymaia.com/blog/produits-data-science-nattendez-pas-le-modele-parfait-avant-dindustrialiser)
- [Produits Data Science - 6 approches de modélisation pour créer rapidement votre MVP](https://www.hymaia.com/blog/produits-data-science-6-approches-de-modelisation-pour-creer-rapidement-votre-mvp)
- [Hidden Technical Debt in Machine Learning Systems](https://proceedings.neurips.cc/paper_files/paper/2015/file/86df7dcfd896fcaf2674f757a2463eba-Paper.pdf)
### 6 - Être sur ses gardes
Pourquoi les performances des modèles se dégradent dès qu’on a le dos tourné ?
- [Qu’est-ce que le Data Drift ?](https://www.hymaia.com/qu-est-ce-que/data-drift)
- [Qu’est-ce que le MLOps ?](https://www.hymaia.com/qu-est-ce-que/mlops)
- [MLOps : les principes du DevOps appliqués au Machine Learning](https://www.hymaia.com/blog/mlops-les-principes-du-devops-appliques-au-machine-learning)
- [MLOps and Model Governance](https://ml-ops.org/content/model-governance)
### 7 - Construire sa roadmap
Comment éviter d’en arriver à “faire une V2 du modèle” comme objectif ?
### 8 - Mind the Gap
Comment éviter que mon Produit d’IA ne se transforme en monstre raciste et mysogyne ?
- [Qu'est-ce que l'AI Act ?](https://www.hymaia.com/qu-est-ce-que/ai-act)
- [L’IA Responsable en 8 enjeux majeurs](https://www.hymaia.com/blog/lia-responsable-en-8-enjeux-majeurs)
- [Qu’est ce que l’IA Responsable?](https://www.hymaia.com/blog/quest-ce-que-lia-responsable)
- [Talk : Comment auditer ses algorithmes d’IA ?](https://www.youtube.com/watch?v=nlJuut_YskE)
- [9 problèmes de qualité des données qui menacent vos projets IA](https://www.lemagit.fr/conseil/9-problemes-de-qualite-des-donnees-qui-menacent-vos-projet-IA)
- [Amazon abandonne son IA de recrutement qui discrimine les femmes](https://www.lebigdata.fr/amazon-abandonne-ia-misogyne)
- Hub France IA : [L’IA éthique en pratique - Opérationnaliser votre système d’IA avec une démarche éthique](https://www.hub-franceia.fr/wp-content/uploads/2023/05/Livre_Blanc_IA_Ethique.pdf)
## 9 - Alerte hype
En quoi l’IA Générative change-t-elle la donne ?
- [Qu’est-ce que l’IA Générative ?](https://www.hymaia.com/qu-est-ce-que/definition-ia-generative)
- [Talk : Qu’est-ce que l’IA Générative ?](https://www.youtube.com/watch?v=Xmr1qQfMfzk)
- [Qu'est ce que ChatGPT?](https://www.hymaia.com/qu-est-ce-que/chatgpt)
- [Talk : How to keep your head about generative AI (when everyone is losing theirs) by Claire Woodcock](https://www.mindtheproduct.com/how-to-keep-your-head-about-generative-ai-when-everyone-is-losing-theirs-by-claire-woodcock/)
# 👉[**télécharger le kit de survie gratuitement**](https://www.hymaia.com/ressources/produit-dia-kit-de-survie-pour-pm-ambitieux)👈
# Formations Data & AI Product
Voici un ensemble de formations qui pourront t’accompagner dans ton évolution vers des rôles de Data & AI Product Manager.
- [Devenir Data & AI Product Manager](https://www.hymaia.com/formation/devenir-data-ai-product-manager)
- [IA pour Product Managers](https://www.hymaia.com/formation/ai-product-manager)
- [Introduction à l’IA Responsable](https://www.hymaia.com/formation/formation-introduction-a-lia-responsable)
- [Get your Data Governance Strategy to the next level](https://www.hymaia.com/formation/get-your-data-governance-strategy-to-the-next-level)
- [Machine Learning Strategy](https://www.hymaia.com/formation/machine-learning-strategy)
Formations techniques en lien avec ces sujets :
- [Formation Generative AI & LLM](https://www.hymaia.com/formation/generative-ai-llm)
- [MLOps & Machine Learning End-To-End](https://www.hymaia.com/formation/mlops-machine-learning-end-to-end)
---
### Qu’est-ce que le Data Mesh ?
Source : https://www.hymaia.com/blog/quest-ce-que-le-data-mesh/
Le Data Mesh décrypté : pourquoi et comment décentraliser la gestion de vos données.
Le **Data Mesh**, nouveau paradigme, nous propose aujourd’hui d’exploiter ce qui a été fait précédemment en proposant un **_shift_ technologique et organisationnel.**
**Alors est-ce un effet de mode ou une réelle innovation?**
Nous parlerons principalement dans ce billet de blog des concepts qui définissent le **Data Mesh,** les technologies pour mettre en place cette architecture ne seront pas abordées. En effet, il est aujourd’hui trop tôt pour en parler car nous sommes aux prémices de cette nouvelle méthode.
## Le Data Mesh: Pourquoi ?
Nous rencontrons actuellement des difficultés à exploiter les données d’une entreprise de manière simple et sans investissement colossal dans des équipes et infrastructures massives.
Les plateformes data construites aujourd’hui autour d’une équipe dédiée n’arrivent pas vraiment à passer à l’échelle par rapport aux nouvelles demandes d’intégration et d’exploitation des données. Cette équipe data devient un goulot d’étranglement composée de personnes très spécialisées dans les technologies dédiées à la data mais pour qui le sens fonctionnel de ce qu’ils manipulent est secondaire.
Cette façon de faire implique deux problèmes :
- Une **pénurie des profils data** du fait qu’ils doivent être très spécialisés dans leur domaine de compétence pour pouvoir mener à bien leurs missions ;
- Des **data pipelines difficiles à maintenir** car elles n’ont pas été construites sur des données métier. Les évolutions demandées sont de plus en plus complexes à implémenter.
Pour contourner ces problématiques, la façon dont on produit, manipule et exploite la data doit être repensée pour faciliter l’accès à la donnée son exploitation et ainsi la valeur qu’elle contient.
## Le Data Mesh: Comment ?
Ces problématiques de gestion d’un monolithe souvent ingérable et que l’on n’arrive pas à passer à l’échelle par rapport à l’évolution de l’entreprise sont des questionnements auxquels le monde de l’informatique a déjà répondu notamment grâce au [Domain-Driven Design](https://en.wikipedia.org/wiki/Domain-driven_design). **Le Data Mesh** **est l’application du DDD au monde de la data.**
Succinctement, le DDD est une méthodologie de développement logiciel qui vise à structurer les développements par domaine métier.
Néanmoins, les besoins data ont des particularités, notamment le fait que l’on doive croiser et transformer ses données pour [en créer une valeur business](https://www.hymaia.com/blog/la-data-nest-pas-une-fin-en-soi), l’ensemble des data doit donc être accessible pour en tirer des bénéfices, **le Data Mesh propose donc de fournir la data en mode self-service**.
De plus, si on doit appliquer le **DDD** à la data, toute la donnée générée par un domaine devient sa responsabilité. **L’approche** **Data Mesh considère donc la donnée comme étant un produit.**
Pour mettre en place cette approche, nous devons repenser la manière d’utiliser mais aussi de **servir** (i.e. mettre à disposition) la donnée. Les data engineer qui sont responsables de la production et de la qualité de la donnée sont dispersés dans l’entreprise, et la donnée est générée au niveau de chaque domaine. Le cluster Hadoop n’est donc plus forcément le centre de vérité de la donnée
En résumé, le concept de Data Mesh est la convergence des trois principes suivants: **Data Ownership By Domain**, **Data As a Product** et **Data As a Self-Service**. Détaillons ces principes un à un.
### Data Ownership By Domain
Avec le Data Mesh, plutôt que d’avoir de la donnée qui se déverse dans une plateforme data unifiée à partir de chaque domaine de l’entreprise et qu’une unique équipe data en soit responsable pour l’exploiter, la donnée doit être gérée et servie par le domaine métier qui la génère. Un domaine pourra donc produire un ensemble de _datasets_ dont il maîtrise l’aspect fonctionnel et est tenu de le gérer pour en faciliter le plus possible sa mise à jour ainsi que l’accès à cette donnée aux différents consommateurs de l’entreprise.
Les _datasets_ dont on parle à ce niveau diffèrent des données opérationnelles du système interne du domaine en question, il s’agit là des différents ensemble de données que peut exposer un domaine dans le but d‘être exploité par d’autres équipes. Ces datasets auront un volume plus conséquent du fait que l’historique est gardé et leurs schémas évoluent moins dans le temps par rapport aux données du système source.
Imaginons par exemple une équipe web qui peut génèrer les données des _clickstreams_ ainsi que les données utilisateurs, elle créera deux _datasets._ Le premier à travers un _event stream_ puisque que les données sont en en temps réel et \*\*le second sous forme de fichiers déposés dans un _object storage_.
**Un _dataset_ source issue d’un domaine ne doit en aucun cas être modelé pour correspondre aux particularités d’un de ses consommateurs**. Un _dataset_ source doit représenter fidèlement la donnée du domaine tout en étant qualitatif en vue de son exploitation. Il doit donc respecter des [SLO](https://en.wikipedia.org/wiki/Service-level_objective) définis au préalable. C’est dans ce cadre que vont être utilisés les différents pipelines de données pour nettoyer, construire et garantir la qualité et l’exploitation des datasets générés et servis au reste de l’entreprise.
### Data As a Product
Du fait qu’un domaine construit, nettoie et expose des données qui ont été créées par son activité, il doit incorporer **un service ou un produit data**. La data est donc considérée comme un produit à part entière d’un domaine de l’entreprise et est exploitée par le reste de l’organisation. De plus, du fait que les datasets générés sont distribués, des problématiques d’**accessibilité** et d’**harmonisation** émergent.
Pour y palier, l’architecture Data Mesh propose de considérer la data comme un produit et d’y appliquer les règles du [**_Product Thinking_**](https://uxmag.com/articles/what-is-product-thinking-and-why-does-it-matter) le plus rigoureusement possible pour que les consommateurs aient une entière satisfaction des datasets produits.
Un produit data doit être :
- **Découvrable** : C’est à dire que les datasets générés s’inscrivent dans un Data Catalog centralisé qui peut être vu par le reste de l’organisation.
- **Facile d’accès :** Un produit data doit être facilement accessible aux consommateurs. Il doit respecter les conditions de nommage et doit avoir une adresse unique pour en faciliter son exploitation de manière programmatique.
- **Fiable** : Un produit data doit être fiable, chaque dataset exposé doit atteindre un niveau de SLO respectable. Il doit être nettoyé et peut par exemple contenir dans ses métadonnées l’intégralité des transformations qui lui ont été appliqués.
- **Non ambigüe** : \*\*\*\*Comme la donnée peut être utilisée par une multitude d’équipes du moment qu’elle est disponible à toute l’entreprise, elle doit générer le moins de frustration possible pour sa compréhension, le schéma de la donnée doit être fournit avec une explication de chaque champ et idéalement un dataset d’exemple pour illustrer.
- **Gouverné par les standards de l’entreprise et sécurisé** : Pour être exposée, la donnée doit respecter les standards de nommage de l’entreprise et notamment de la sécurité. L’accès à la donnée doit être géré par des _policy_ très fines pour pouvoir donner l’accès à la donnée que l’on veut à qui on veut. La donnée sensible doit être anonymisée notamment dans ce contexte.
### Data As a Self Service
Le fait que l’on construise un produit data par domaine métier implique une complexité à rajouter lors de la construction d’une architecture Data Mesh. En effet, construire des data pipelines qui sont souvent redondantes entre domaine n’a pas l’air d’être une bonne idée.
L’architecture Data Mesh propose donc de construire une infrastructure data utilisée en tant que plateforme (_Data Infra as a Platform_).
Cette plateforme doit être agnostique aux domaines métiers et ne doit incorporer aucune logique business. Elle aura pour responsabilité de fournir des services et ressources aux différents produits data à construire.
Elle doit fournir à minima les services suivants:
- Stocker la donnée de manière scalable ;
- Un catalogue de données unifié pour visualiser mais aussi modifier le schéma des données ;
- Mesurer la qualité des données ;
- Une couche applicative pour standardiser les données ;
- Pouvoir gérer qui a accès à quelle donnée ;
- Proposer des services pour monitorer et alerter si besoin les produits data.
Une _data infra as a platform_ réussie est une plateforme qui aide les équipes à créer des produits de manière simple et automatisée.
Ce type d’infrastructure peut être mis en place avec des services managés des différents fournisseurs de Cloud, mais il faudrait y apporter une surcouche d’automatisation et de simplification en terme d’accès à ces services.
Pour mener à bien ce type d’architecture distribuée, il faudra changer l’organisation de l’entreprise concernant la data.
## Data Mesh: d’un point de vue organisationnel
Comme on l’a vu, pour éviter d’avoir une équipe data qui gère à elle seule toutes les données de l’entreprise, les données générées doivent être rattachées à leurs domaines respectif. Chaque domaine aura une responsabilité en plus pour garantir l’accès et la qualité à son produit data. **Un domaine qui produit des données doit intégrer dans son équipe des profils de Data Engineers et un Product Owner acculturé aux produits data.**
**Le PO data prendra des décisions concernant la vision qu’il a sur le dataset de données qu’il doit produire** et cela en fonction de la richesse et de la qualité de celles-ci. Il doit se baser sur des KPIs mesurables pour s’assurer que le dataset exposé assure le niveau de qualité requis. Un des KPIs qui peut être intéressant est le temps requis par un consommateur de la donnée pour découvrir et utiliser le dataset exposé. Il doit en continu récupérer du feedback des consommateurs pour améliorer son produit.
**Le Data Engineer s’occupera quant à lui de la construction et de l’exposition (ou _serving_) de ce dataset.** Il n’est plus isolé dans une équipe data où la compréhension métier des données qu’il manipule est secondaire. Il est placé au cœur technique d’une organisation Data Mesh. Il lui faut cette connaissance métier pour pouvoir délivrer un dataset utile et de qualité.
L’ogranisation en Data Mesh contribuera à favoriser les échanges et mutualiser les bonnes pratiques et les connaissances etre les Data Engineers et Software Engineers. En effet, l’écart est mince et le but est de créer des synérgies pour que la production de ces datasets soit faite avec les outils data tout en respectant les normes de développement du software engineering (CI/CD, tests automatisés …).
Des formations doivent être proposées pour préparer les Software Engineers mais aussi les Ops à travailler avec des outils data.
Pour construire et gérer la _data infrastructure as a platform,_ il faut aussi des D\_ata Infra Engineers\_ qui s’occuperont de la mise en place de cette plateforme de ressources et de service. Ils auront un rôle tout aussi primordial pour fluidifier la création des dataset. On retrouve ce rôle chez les SRE (_Site Reliability Engineers_) ayant de l’éxpériences sur des architectures data traditionelles.
## Conclusion
Pour conclure, le but d’une architecture **Data Mesh** et de permettre aux entreprises de passer à l’échelle l’exploitation de leurs données de manière synchrone avec la mise en place de nouveaux domaines fonctionnels. Elle vise à distribuer la responsabilité de la création et du maintient de la qualité de la donnée à chaque domaine qui la produit.
Basé sur une approche _DDD_ appliquée à la data, il est utile d’avoir déjà mis en place une organisation de ce type au sein de votre entreprise avant de se jeter à l’eau pour la partie data. Un effort doit aussi être fournit dans la formation des différents collaborateurs notamment les S\_oftware Engineers\_ qui doivent avoir des compétences data pour construire ces _datasets_ métier ou encore à former des POs pour qu’ils puissent être à l’aise dans la vision qu’ils doivent avoir pour concevoir des _datasets_ qui ont du sens et de qualité.
Technologiquement parlant, les outils sont déjà disponibles sur le marché pour construire une telle architecture. C’est maintenant aux ingénieurs de mettre en place des services pour pouvoir créer et exploiter les données de manière fluide et ainsi avoir une plateforme data décentralisée au sein de l’entreprise, où les données ont été créées de manière collaborative et harmonisée quel que soit le service qui en est responsable.
### Sources pour en savoir plus:
- [https://martinfowler.com/articles/data-monolith-to-mesh.html](https://martinfowler.com/articles/data-monolith-to-mesh.html)
- [https://developer.confluent.io/learn-kafka/data-mesh/intro/](https://developer.confluent.io/learn-kafka/data-mesh/intro/)
- [https://www.amazon.fr/Data-Mesh-Delivering-Data-driven-Value/dp/1492092398](https://www.amazon.fr/Data-Mesh-Delivering-Data-driven-Value/dp/1492092398)
---
### Qu’est ce que l’IA Responsable?
Source : https://www.hymaia.com/blog/quest-ce-que-lia-responsable/
Les fondamentaux de l’IA Responsable : définition, enjeux et bonnes pratiques pour des produits d’IA éthiques.
**Si le potentiel incroyable de l’Intelligence Artificielle est maintenant compris et exploité depuis plusieurs années, son impact - voire sa dangerosité - sur nos vies, nos sociétés et notre environnement est de plus en plus scruté et débattu.**
L’IA Responsable n’est aujourd’hui plus seulement un sujet de débat, c’est devenu une réalité qu’il est nécessaire de prendre en compte dès les premières phases des projets à base de Machine Learning (ML). Mais qu’y a-t-il vraiment derrière ?
Cet article a pour objectif de faire un tour d’horizon des **principaux piliers de l’IA Responsable** mis en avant par quelques-uns de ses principaux acteurs, pour ensuite proposer une ouverture sur le sujet qui se veut optimiste, afin de montrer que le fait d’appliquer les principes de l’IA Responsable n’est pas qu’une question de restrictions à se donner, mais bien une opportunité pour **créer des produits responsables à haute valeur ajoutée.**
## Différents piliers de l’IA Responsable mis en avant
Pour définir l’IA Responsable, nous pouvons partir de la définition donnée dans le livre \*\*_“Responsible Artificial Intelligence”_ (Springer) \*\*: _“Responsible Artificial Intelligence is about human responsibility for the development of intelligent systems along fundamental human principles and values, to ensure human-flourishing and well-being in a sustainable world.”_.
L’IA Responsable est devenu un enjeu stratégique pour beaucoup d’entreprises. Pour s’en convaincre, il suffit de faire un tour du côté de quelques géants du web qui ont publié des pages dédiées au sujet.
**Google** structure ses efforts sur le sujet autour de [4 concepts fondamentaux](https://ai.google/responsibilities/responsible-ai-practices/?category=fairness) : **Fairness** (que l’on pourrait traduire par “équité” ou “justice”), **Interpretability**, **Privacy** et **Security**. Ces 4 piliers spécifiques sont accompagnés de propositions de bonnes pratiques, qui viennent s’ajouter à l’ensemble de celles autour du développement logiciel et du Machine Learning que Google publie régulièrement.
De son côté, **Facebook** s’organise autour de [5 concepts clés](https://ai.facebook.com/blog/facebooks-five-pillars-of-responsible-ai/) pour concentrer et organiser ses travaux sur le sujet : **Privacy & Security**, **Fairness & Inclusion**, **Robustness & Safety**, **Transparency & Control** et **Accountability & Governance**. L’entreprise met notamment en avant, en plus des concepts techniques, des notions de rôles, d’organisation et de gouvernance qui sont clés dans le développement d’une réelle stratégie autour de l’IA Responsable.
Quant aux équipes de **Microsoft**, elles parlent de [6 axes essentiels](https://www.microsoft.com/en-us/ai/responsible-ai) pour une IA Responsable : **Fairness**, **Inclusiveness**, **Reliability & Safety**, **Transparency**, **Privacy & Security** et **Accountability**.
D’une manière similaire, d’autres organisations apparaissent et se structurent autour de ces principes fondamentaux. C’est le cas de l’**Institute for Ethical AI & Machine Learning**, un centre de recherche anglais engagé dans la structuration du sujet de l’IA Responsable, et proposant des principes et des méthodologies pour aller dans cette voie. Ils ont publié à cet égard 8 [“_Responsible Machine Learning Principles_”](https://ethical.institute/principles.html) : **Human Augmentation**, **Bias Evaluation**, **Explainability by justification**, **Reproducible Operations**, **Displacement Strategy**, **Practical Accuracy**, **Trust by Privacy** et **Data Risk Awareness**. Comme on peut le voir, si certains piliers sont similaires, un focus fort est aussi largement présent sur les impacts de l’IA par et sur les humains.
## L’IA Responsable ouvre de nouvelles opportunités
Bien que nous percevons de plus en plus les dangers que peuvent susciter les systèmes de Machine Learning, les prises de conscience et le poids de plus en plus important de l’IA Responsable permettent de voir plusieurs lueurs d’espoir pour l’avenir en termes d’impacts positifs de ces produits.
L’un des avantages majeurs de la mise en place des bonnes pratiques autour des principaux piliers développés plus haut réside dans le fait de **pouvoir prendre des décisions éclairées**, permettant notamment d’éviter (ou de diminuer) les risques de décisions “black-box”, les discriminations et perpétuation de biais, les atteintes à la vie privée ou encore les décroissances de performances des modèles dans le temps. **Ces piliers permettent donc de construire des IA robustes et compréhensibles afin de gagner en confiance et en transparence dans la prise de décision**.
Pour aller plus loin sur le risque majeur lié à la perpétuation ou l'amplification des biais, la mise en place de bonnes pratiques autour de l’IA Responsable permettrait de la voir comme un moyen **d’inverser la tendance**. En effet, il a été prouvé par les sciences cognitives que les raisonnements humains ne sont pas toujours rationnels et emploient des heuristiques de prise de décision rapides, souvent portés par de nombreux biais inconscients. Incorporé dans les systèmes de prise de décision, **le Machine Learning peut alors nous mettre face à nos propres incohérences et nos propres biais, en les mesurant de manière qualitative et en prenant des décisions basées sur ces révélations**.
Ce dont nous pouvons être certains, c’est qu’**il est impossible de considérer l’IA Responsable comme un simple sujet à traiter par l’angle technique et mathématique**. Ce sujet touche à l’ensemble de la chaîne de prise de décision et nous force à nous poser des questions difficiles que nous n’aurions pas forcément vues au premier abord. Nous n’en sommes qu’au début de l’histoire, et chaque acteur a une responsabilité pour tendre vers un impact plus positif de l’Intelligence Artificielle au sens large.
---
### Serverless Inference : Quand AWS SageMaker rencontre AWS Lambda
Source : https://www.hymaia.com/blog/serverless-inference-quand-aws-sagemaker-rencontre-aws-lambda/
Combiner AWS SageMaker et Lambda pour des prédictions ML en temps réel, sans gérer de serveurs.
Avec une tarification à l’utilisation, ce mode Serverless permet ainsi une réduction significative des coûts pour bon nombre de cas d’usage, au prix de quelques compromis. Dans quel cas ce nouveau mode est-il le plus adapté ?
## L’inférence en Machine Learning
En Machine Learning, l’inférence est la phase qui suit l'entraînement et la validation du modèle. Celle-ci consiste à déployer le modèle et à l’appliquer sur de nouvelles données “live” afin d’obtenir des prédictions.

Sur AWS, [Amazon SageMaker](https://aws.amazon.com/fr/sagemaker/) est un service de Machine Learning entièrement managé. Celui-ci permet de développer, entraîner et déployer facilement des modèles, sans avoir à se préoccuper de la gestion de l'infrastructure. Concernant le déploiement, on distingue différents modes d’inférence pour répondre à différents cas d’usage :
- [**Mode batch**](https://docs.aws.amazon.com/sagemaker/latest/dg/batch-transform.html) **:** pour effectuer des prédictions sur un jeu de données en une fois. Le mode batch applique le modèle entraîné au travers d’un script d’inférence sur un jeu de données stocké sous S3. Ce mode est idéal pour les grands volumes de données et cas d’usage hors temps réel. Par exemple, pour une exécution quotidienne sur les nouvelles observations de la veille ;
- [**Inférence temps réel**](https://docs.aws.amazon.com/sagemaker/latest/dg/realtime-endpoints.html) : déploie le modèle sur un point de terminaison (_endpoint_) afin de traiter rapidement des requêtes par web service. Les requêtes “live” sont traitées au fil de l’eau et les latences sont en millisecondes. Ce mode d’inférence peut traiter des requêtes allant jusqu’à 6 MO de données. Revers de la médaille, le _endpoint_ doit rester la plupart du temps allumé, ce qui coûte cher. En ordre de grandeur, un endpoint AWS allumé 24h/24 sur une machine [ml.t2.medium](https://aws.amazon.com/fr/sagemaker/pricing/) _(4GB de RAM, 4 vCPU - la moins chère)_ coûte la modique somme de 45 USD par mois ;
- [**Inférence asynchrone**](https://docs.aws.amazon.com/sagemaker/latest/dg/async-inference.html) **:** sorti en août 2021, le mode asynchrone permet une inférence live pour les requêtes dont les données sont particulièrement volumineuses _(jusqu’à 1 GO)_ ou longues à calculer _(jusqu’à 15 minutes)_. Pour cela, le mode asynchrone va stockerles différentes requêtes dans une file d’attente avec des données chargées depuis S3. Les latences sont plus élevées qu’avec le mode temps réel _(> 1 seconde)_ ;
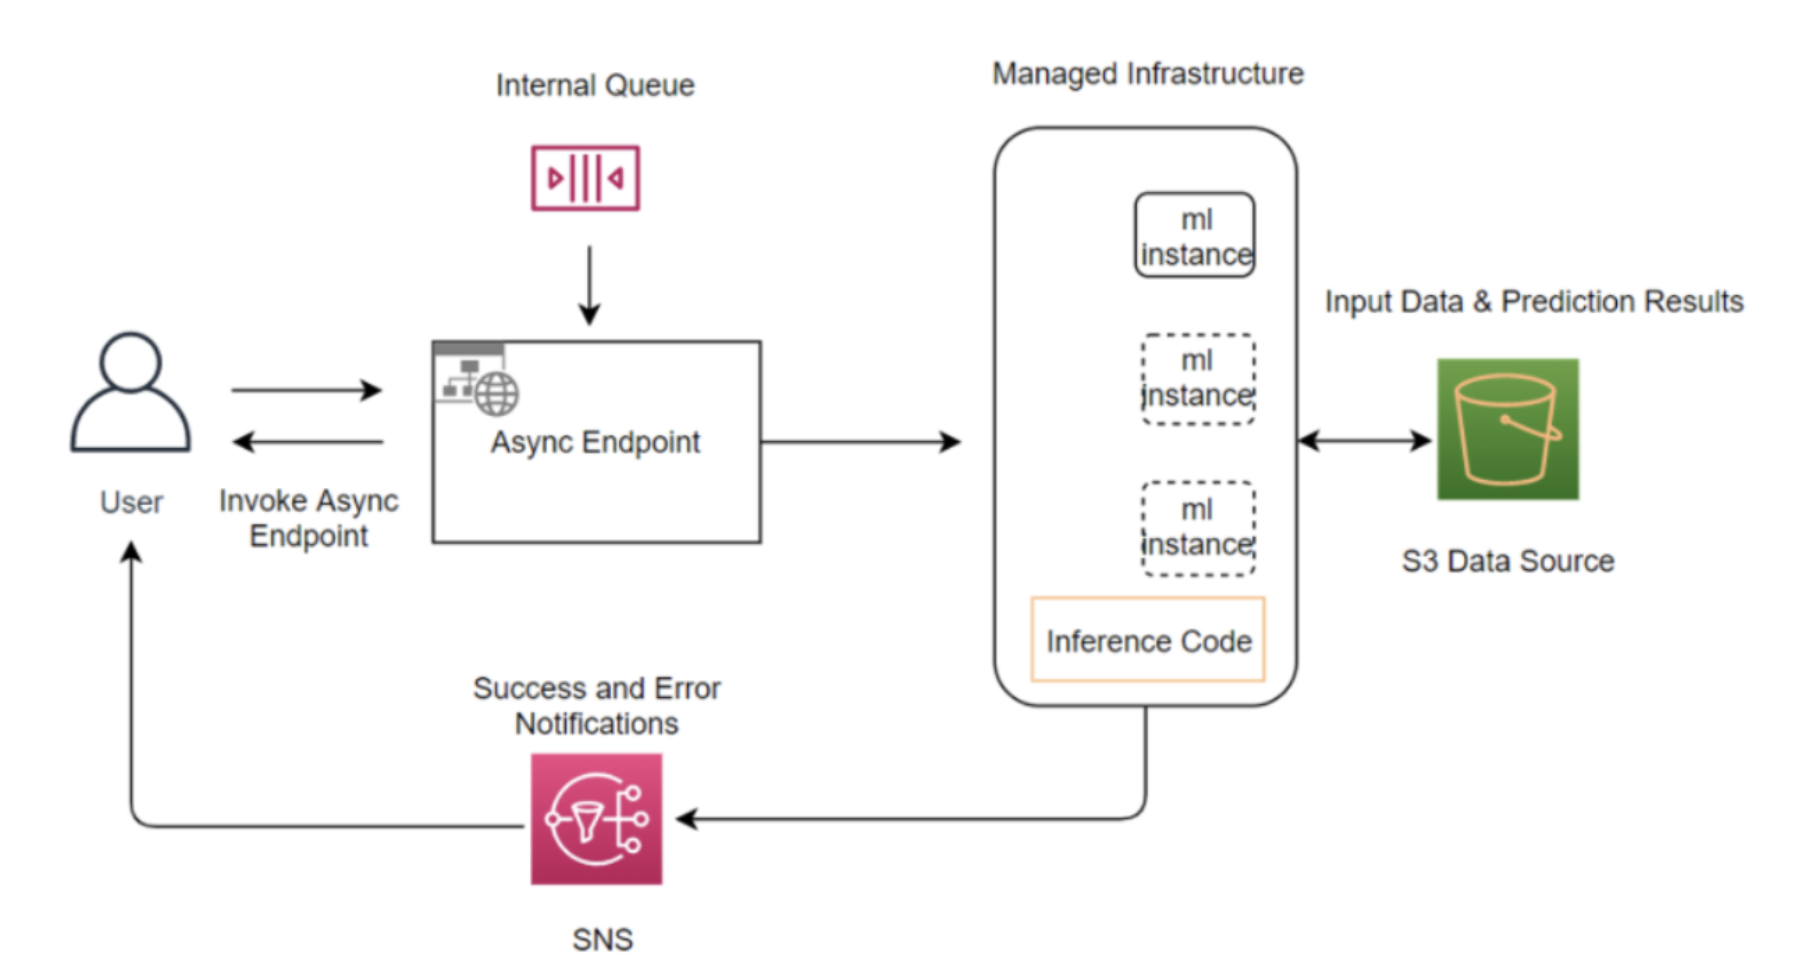
[****](https://docs.aws.amazon.com/sagemaker/latest/dg/serverless-endpoints.html)
- [**Inférence serverless**](https://docs.aws.amazon.com/sagemaker/latest/dg/serverless-endpoints.html)**,** avec déploiement _serverless_ au travers d’AWS lambda. Le tarif est bien moins élevé qu’en inférence temps réel avec une tarification au temps à partie de 0,00002 USD par seconde pour une petite instance + une tarification au volume traité de 0,016 USD par Go entrant ou sortant (zone Paris, [août 2022](https://aws.amazon.com/fr/sagemaker/pricing/)). Cela étant, ce mode comprend un _cold start_, c’est-à-dire un temps de préparation du modèle. Un modèle suffisamment léger sera plus avantagé. Ainsi, ce mode est idéal pour des données peu fréquentes, un trafic peu prédictible, ou des besoins de latences peu critiques.
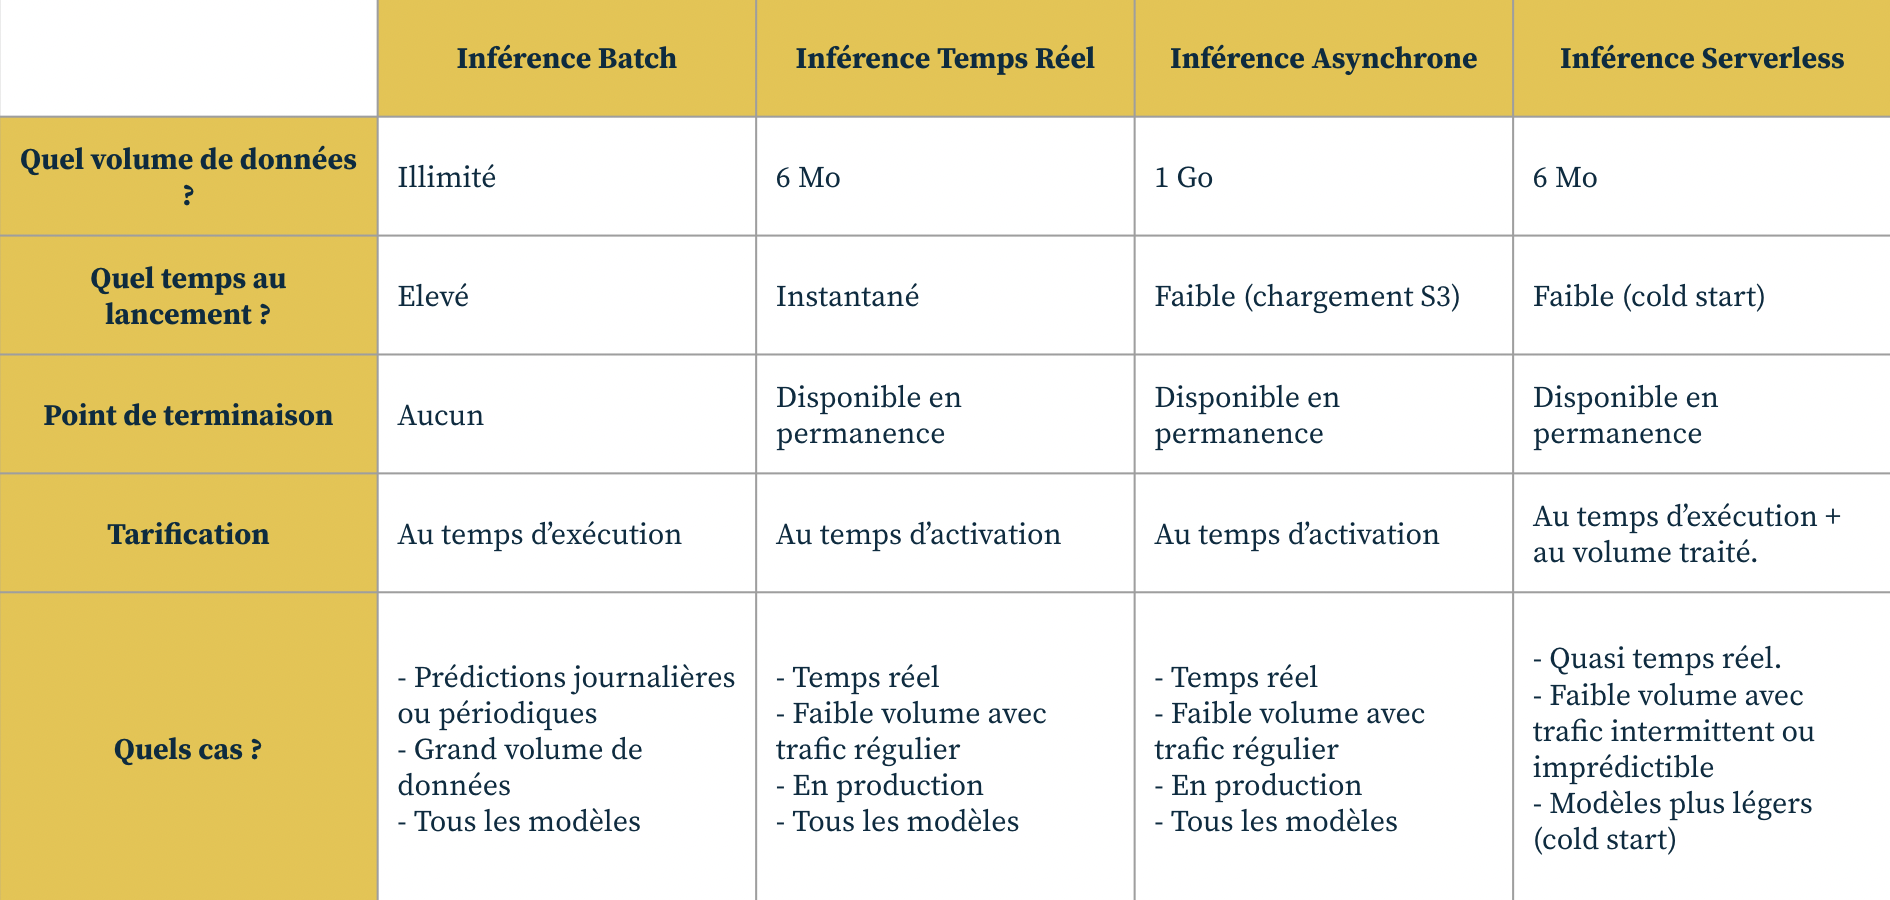
## Avantages et limites
L’inférence serverless permet ainsi de grandement réduire les coûts par rapport au mode temps réel. Revers de la médaille, le problème du _cold start_ qui pénalise les modèles volumineux. Ainsi, le mode serverless se révèle particulièrement utile dans les cas suivants :
- **Réalisation d’un POC,** afin de réduire au maximum les coûts. Les temps de latence liés à l’inférence y sont généralement peu importants ;
- **Trafic intermittent ou imprévisible,** pour lequel le _endpoint_ doit pouvoir être disponible en permanence. Dans le cas d’une inférence en temps réel, laisser le _endpoint_ allumé en permanence coûte relativement plus cher ;
- **Modèles légers,** afin de permettre un chargement suffisamment rapide du modèle pour éviter les latences liées au _cold start_. Avec ce type de modèle, il est possible d’obtenir des prédictions en quelques millisecondes.
## Exemple d’utilisation
Dans l’exemple ci-dessous (disponible sur [Github](https://github.com/tvienne/demo-tensorflow-serverless)), nous allons comparer le mode “temps réel” et le mode “serverless” sur le jeu de données [fashion MNIST](https://github.com/zalandoresearch/fashion-mnist). Ces données, publiées par Zalando, contiennent 70 000 images de vêtements. Chaque image est en niveaux de gris et de taille 28x28 pixels. A chacune d’entre elles est associé un des 10 labels existants (_trouser, pullover, dress, coat...)._ L’objectif est ainsi de pouvoir entraîner un modèle de Machine Learning à classer des images dans la bonne catégorie de vêtement.
Notre exemple comprend le chargement des données, l'entraînement d’un réseau de neurones avec Tensorflow, puis le déploiement de deux _endpoints_ : l’un en mode temps réel et l’autre en mode serverless.
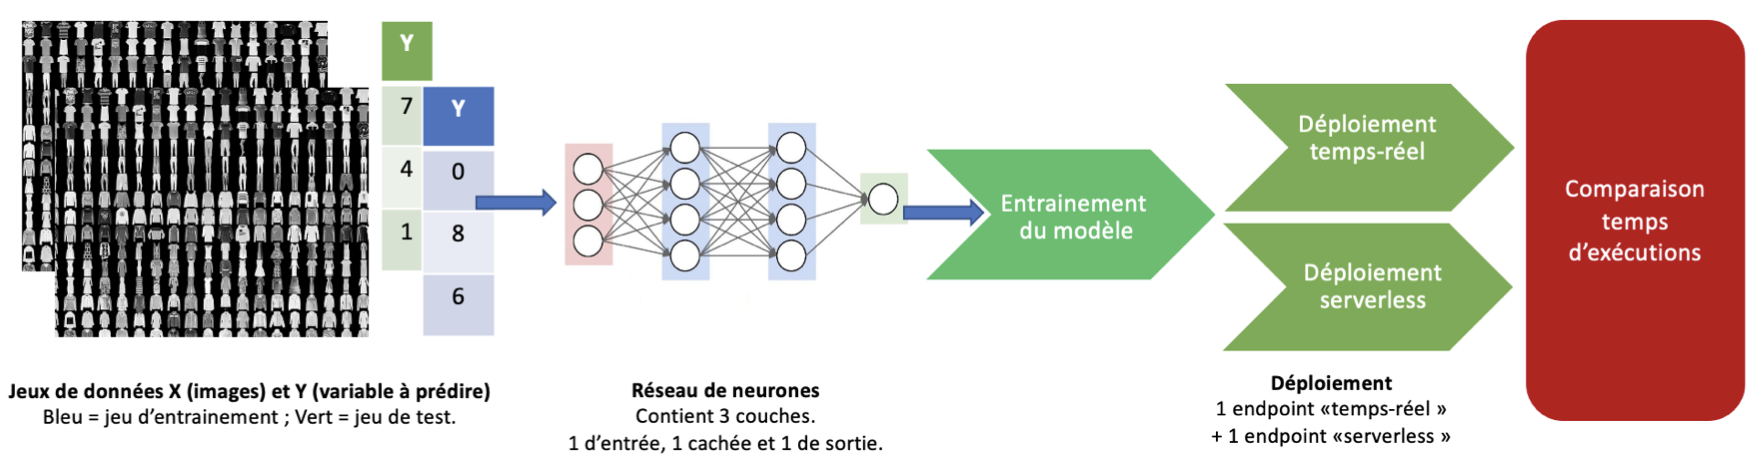
Pour démarrer, nous chargeons les images. Comme ce jeu de données fait partie des [jeux de données par défaut de TensorFlow](https://www.tensorflow.org/datasets?hl=fr), nous pouvons le charger simplement avec :
CODE: [https://gist.github.com/Hymaia22/9d65ae384f90a90c213d09a4c06eb303.js](https://gist.github.com/Hymaia22/9d65ae384f90a90c213d09a4c06eb303.js)
Pour visualiser les images :
CODE: [https://gist.github.com/Hymaia22/9626347a758952378caea7d2350ef79c.js](https://gist.github.com/Hymaia22/9626347a758952378caea7d2350ef79c.js)
Nous avons ensuite écrit un script **train.py** afin de pouvoir définir, entrainer et sauvegarder le modèle. Dans notre exemple, celui-ci est un simple réseau de neurones contenant une couche d’entrée, une couche cachée de 128 neurones, puis une couche de sortie. En fin de script, le modèle est sauvegardé sur Amazon S3.
CODE:[https://gist.github.com/Hymaia22/2b30e5a913b4b9fab117618390c9802b.js](https://gist.github.com/Hymaia22/2b30e5a913b4b9fab117618390c9802b.js)
_train.py : définition, entraînement et sauvegarde du modèle. La variable d’environnement ‘SM\_MODEL-DIR’ est définie par défaut sur la machine distante AWS où est exécuté le script_
Avec Amazon SageMaker, les utilisateurs développent sur une petite instance avec un environnement Jupyter déjà prête _(appelée_ [_SageMaker Studio_](https://aws.amazon.com/fr/sagemaker/studio/)_)_. Les tâches (_jobs_) plus conséquentes sont exécutées à la demande sur une machine distante plus grande.
Pour ce faire, nous appelons la classe [_sagemaker.tensorflow.TensorFlow_](https://sagemaker.readthedocs.io/en/stable/frameworks/tensorflow/sagemaker.tensorflow.html) qui agit comme un wrapper afin de configurer l'exécution à distance.
CODE:[https://gist.github.com/Hymaia22/4537ca3d0aca2277b80fe61d5a0ff626.js](https://gist.github.com/Hymaia22/4537ca3d0aca2277b80fe61d5a0ff626.js)
_notebook serverless.ipynb : la classe TensorFlow est un wrapper. Celle-ci permet de configurer l'exécution sur une machine distante en définissant un point d’entrée (train.py), le rôle IAM associé, le type de machine et la version de Tensorflow._
Une fois l’estimateur entraîné, il est alors possible de déployer facilement le _endpoint_. Pour le mode inférence en temps réel, il suffit d'exécuter les instructions suivantes :
CODE:[https://gist.github.com/Hymaia22/4fa575cc88c08f9fd8a7b7dda01d460c.js](https://gist.github.com/Hymaia22/4fa575cc88c08f9fd8a7b7dda01d460c.js)
_notebook serverless.ipynb : déploiement en mode temps réel. On spécifie le nom du endpoint et le type d’instance (ici ml.t2.medium)_
Après quelques minutes, le endpoint devient opérationnel. Dans le cas du **mode serverless**, on ajoute une classe de configuration _ServerlessInferenceConfig_. Celle-ci prend deux paramètres :
- **MemorySize**, la RAM allouée au _endpoint_. Elle peut aller de 1024 MO à 6144 MO. Les ressources de calcul sont allouées proportionnellement à la mémoire. Un _endpoint_ avec une grande RAM aura plus de vCPU ;
- **MaxConcurrency**, le nombre maximum d’invocations possibles en même temps. Celui-ci peut aller de 1 à 200 pour un même _endpoint_.
Après quelques minutes, le endpoint devient opérationnel. Dans le cas du **mode serverless**, on ajoute une classe de configuration _ServerlessInferenceConfig_. Celle-ci prend deux paramètres :
- **MemorySize** la RAM allouée au _endpoint_. Elle peut aller de 1024 MO à 6144 MO. Les ressources de calcul sont allouées proportionnellement à la mémoire. Un _endpoint_ avec une grande RAM aura plus de vCPU ;
- **MaxConcurrency**, le nombre maximum d’invocations possibles en même temps. Celui-ci peut aller de 1 à 200 pour un même _endpoint_.
CODE:[https://gist.github.com/Hymaia22/a582c2d4c188ffb26525897014fb7cfe.js](https://gist.github.com/Hymaia22/a582c2d4c188ffb26525897014fb7cfe.js)
_notebook serverless.ipynb : déploiement en mode serverless_
Une fois les _endpoints_ activés, il est alors possible de les requêter. Pour les deux _endpoints_, nous pouvons par exemple utiliser les instructions suivantes. Celles-ci vont invoquer le _endpoint_ choisi, puis afficher la prédiction et le label (variable à prédire) associés :
CODE:[https://gist.github.com/Hymaia22/e37d7eafc7e578b33a04a2dbe77b2c1c.js](https://gist.github.com/Hymaia22/e37d7eafc7e578b33a04a2dbe77b2c1c.js)
_serverless.ipynb : on invoque le endpoint au travers de la classe Predictor. La méthode .predict() permet ensuite d’obtenir une prédiction_

Nous pouvons aussi mesurer des temps de latences avec un chronomètre et une boucle for... in.
CODE:[https://gist.github.com/Hymaia22/9dc33cf72ef2cded5e0c37177104ce3d.js](https://gist.github.com/Hymaia22/9dc33cf72ef2cded5e0c37177104ce3d.js)
Ce qui donne, pour le _endpoint_ en temps réel, des latences de l’ordre de 15 ms.

Pour le _endpoint_ en mode serverless, des latences de l’ordre de 45 ms dû à l’effet _cold start_.

Au niveau de la tarification, le endpoint serverless permet de fortes économies par rapport au endpoint temps-réel. En effet, 1 million d’appels au endpoint serverless coûtent 3,68 USD, tarif dû aux 1M x 45 millisecondes de temps de calcul _(soit 3,6 USD, facturé 0,00008 USD par seconde de calcul)_ et au volume de données entrant 1M x 0,5 Ko par image _(soit 0,008 USD, facturé 0,016 SD par GO entrant ou sortant)._
En comparaison, le endpoint temps-réel est un instance ml.t2.medium est facturé à 0,063 USD par heure, soit 1,51 USD par jour, le endpoint serverless reste ainsi avantageux jusqu’à 410k appels par jour.
**Note** : Bien entendu, ce calcul est effectué sur un cas d’usage relativement modeste (petit modèle et images comprenant 784 pixels). Pour des images plus conséquentes ou un modèle plus volumineux / plus complexe, les temps de calcul et chargement s’allongerait, ce qui augmenterait le prix de l’inférence serverless. Ce sont ainsi des critères importants à prendre en compte dans le choix de ce type de endpoint.
## Conclusion
L'inférence serverless apporte une flexibilité supplémentaire pour le déploiement de modèles de Machine Learning. Par rapport à l’inférence en temps réel, celle-ci permet de réduire grandement les coûts pour la plupart des cas d'usage. En contrepartie, le mode serverless peut souffrir de latences plus importantes au démarrage (_cold start_).
C’est donc un mode de déploiement particulièrement adapté aux projets en phase de POC, avec un trafic intermittent ou bien faisant intervenir des modèles suffisamment légers pour répondre aux temps de latences demandés.
---
### Spark : quand faire un cache sur une DataFrame ?
Source : https://www.hymaia.com/blog/spark-quand-faire-un-cache-sur-un-dataframe/
Quand et comment utiliser le cache Spark sur vos DataFrames pour de vrais gains de performance.
Vous ne réfléchissez plus trop, vous ne savez plus vraiment pourquoi, mais après avoir lu une **DataFrame** et fait quelques opérations dessus, hop c’est mis en cache. Or, c’est une très mauvaise idée et nous allons découvrir pourquoi dans cet article.
## Que se passe-t-il quand je cache une DataFrame ?
Tout d’abord, il faut savoir que la méthode cache() est un alias pour la fonction persist(StorageLevel.MEMORY\_ONLY).
Contrairement à ce que l’on pourrait _penser_, cette fonction est une transformation. Cela signifie que le traitement sera **lazy** et attendra qu’une action soit effectuée pour se faire.
Quand une action sera demandée, la **DataFrame** va être calculé et à l’instruction cache() la donnée sera stockée dans la **Spark Memory**, plus précisément la **Storage Memory :**

Si vous souhaitez en savoir plus sur ce point précis, je vous invite à lire [Spark memory management](https://0x0fff.com/spark-memory-management/), un article un peu vieux (les valeurs par défaut citées ne sont plus à jour) mais qui reste quand même valable sur le principe.
Comme vous le voyez, la **Storage Memory** représente moins de 30% de la mémoire totale qu’on attribue à un **executor**. Sur 4 Go, cela représenterait 1 423.5 Mo. En cachant trop de **DataFrames**, même si vous avez beaucoup d’**executor**, la **Storage Memory** sera rapidement pleine.
Il reste toujours la possibilité d’augmenter le nombre d’**executor** ou la quantité de mémoire vive par **executor**, mais si vous êtes dans le cloud vous paierez plus cher votre infra, et si vous gérez votre propre infrastructure, vous atteindrez rapidement la limite. La meilleure solution est toujours d’optimiser son code quand c’est possible.
## Que se passe-t-il quand La Storage Memory est pleine ?
Quand la **Storage memory** est pleine et qu’il reste de la place dans l’**Execution memory**, **Spark** fera déborder le cache dans l’**Execution memory**. Si tout est plein, **Spark** fera de la place dans la **Storage Memory** en déplaçant des blocs de mémoire sur le disque dur de l’**executor**. Une opération qui fait perdre du temps.
Lorsque **Spark** a besoin d’utiliser un bloc mémoire qui a été déplacé sur disque dur, c’est comme si le niveau du cache avait été réglé sur StorageLevel.DISK\_ONLY. On gagne toujours du temps parce que la **DataFrame** n’a pas besoin d’être recalculé, mais moins que si le cache avait été fait en mémoire vive.
Il faut donc faire attention au nombre de **DataFrames** que l’on cache afin éviter de trop remplir la **Storage Memory** et perdre en efficacité de cache.
## Quand faire un cache sur une DataFrame ?
Il y a deux questions simples à se poser pour déterminer quand il est pertinent de cacher une **DataFrame**. Cependant l’approche reste empirique, beaucoup de facteurs sont à prendre en compte pour bien répondre à ces questions.
### **Combien d’actions vont être appelées sur la DataFrame ?**
Si vous n’avez pas au moins 2 actions, c’est totalement inutile. La **DataFrame** sera mis en cache à la première action mais jamais réutilisée par une seconde. À 2 actions, on peut se poser la question. À partir de 3 actions, cela devient pertinent dans la majorité des cas.
### **Quelles transformations sont appliquées sur ma DataFrame ?**
Si vous ne faites que lire un fichier et filtrer une partie de la donnée, vous ne gagnerez pas beaucoup de temps à appliquer un cache sur le résultat. Sauf si vous l’utilisez de nombreuses fois derrière ou que votre lecture est couteuse (gros fichier texte non partitionné par exemple).
Dans le cas nominal, si vous lisez un fichier parquet bien partitionné, un cache devient pertinent après au moins une transformation de type **reduce** qui provoquera du **shuffle**.
## La méthode unpersist
Il existe une méthode qui sert à [supprimer une DataFrame du cache](https://spark.apache.org/docs/latest/api/python/reference/pyspark.sql/api/pyspark.sql.DataFrame.unpersist.html) : unpersist(). Cette méthode prend un paramètre optionnel, un **boolean** qui définit s’il faut bloquer tous les traitements le temps de vider le cache ou pas.
Par défaut, c’est seulement une indication pour **Spark** que tous les blocs mémoires correspondant à une **DataFrame** peuvent être supprimés. Ce comportement est à privilégier car il laisse à Spark la liberté de supprimer un bloc seulement s’il a besoin de récupérer de l’espace mémoire. Ainsi on respecte la philosophie de **Spark** qui est : être feignant et ne faire quelque chose que quand c’est utile.
À titre personnel, j’utilise peu la méthode unpersist() que **Spark** gère très bien seul si on reste raisonnable sur l’utilisation du cache. Je recommande donc d’aider **Spark** à nous aider en prenant le temps de réfléchir à ces deux questions avant d’utiliser la fonction cache(). Je rappelle aussi que la **Spark UI** vous permettra de récupérer toutes les informations nécessaires à une meilleure prise de décision pour optimiser vos traitements.
---
### Tomber dans le piège du PoC infini
Source : https://www.hymaia.com/blog/tomber-dans-le-piege-du-poc-infini/
Pourquoi tant de projets Data restent bloqués au stade du PoC sans jamais partir en production.
- Un rapport de [VentureBeat AI](https://venturebeat.com/2019/07/19/why-do-87-of-data-science-projects-never-make-it-into-production/) indique que 87% des projets Data Science ne vont pas en production ;
- [Gartner](https://blogs.gartner.com/andrew_white/2019/01/03/our-top-data-and-analytics-predicts-for-2019/) estimait en 2019 que 80% des projets d’IA de 2020 allaient rester à l’état de POC, menés par des “sorciers” dont les talents ne sont pas compatibles avec un passage à l’échelle de l’organisation ;
- Ce même rapport Gartner estime que seulement 20% des insights d’analytics vont réellement délivrer de la valeur en 2022.
Pendant la réalisation de PoCs en Data, se pose régulièrement la question : “_stop ou encore ?_”. Ou autrement dit : “_Dois-je continuer à passer du temps à analyser ces données / améliorer ce modèle de Machine Learning / croiser ces différentes sources / benchmarker cette plateforme pour être sûr de mon choix, ou bien dois-je m’arrêter là et penser industrialisation ?_”.
Notre conviction est qu’**une brique Data n’a que très peu de valeur en soi, c’est son utilisation dans un Produit en production et en réponse à une problématique métier précise qui est importante**. Et pour cela, rien de mieux que de passer rapidement à la création d’un MVP (Minimum Viable Product) fonctionnel de bout en bout.
La question à vous poser : Avez-vous souvent du mal à savoir s’il faut continuer d’investir du temps dans un PoC ou bien s’il faut s’arrêter et envisager l’industrialisation ?
Citons quatre raisons pour lesquelles il ne faut pas attendre trop longtemps avant de penser à la création d’un MVP.
## Raison #1 : Éviter de se rendre compte in fine que le travail réalisé n’est pas exploitable en production
Plusieurs raisons peuvent amener à cette conclusion : un temps de latence trop élevé, une taille de modèle trop grande, une implémentation qui n’est pas adaptée pour le temps réel ou qui n’est pas compatible avec les contraintes techniques des environnements de production, etc.
## Raison #2 : Un Produit Data est constitué de multiples briques logicielles
Ce que vous allez tester dans un PoC ne représente souvent qu’un tout petit morceau de l’ensemble de la chaîne de traitement nécessaire pour implémenter un Produit Data de bout en bout.
Il est nécessaire de voir un Produit Data comme un ensemble, et pas uniquement sous le spectre d’une seule brique précise (ne se concentrer que sur un modèle de Machine Learning par exemple). Passer rapidement à la création d’un MVP permet de se rendre compte au plus tôt de la difficulté potentielle de créer une chaîne de traitement complète, de l’ingestion de données à l’activation des résultats par un utilisateur final.
## Raison #3 : Lever les principales incertitudes
Dans la majorité des cas, votre objectif dans une phase initiale d’un projet Data ne doit pas être de savoir quelle performance maximale vous pouvez atteindre, mais plutôt de lever vos principales incertitudes : “_La donnée est-elle de qualité ?_”, “_Pouvons-nous croiser les différentes sources ?”_, “_Est-il techniquement possible de faire ce type de prédiction ?_”, “_Quel niveau de performance pouvons-nous atteindre sans effort ?_”, “_Voyons-nous un fort potentiel d’amélioration de ces performances ?_”
Vous l’aurez compris, il n’y a pas forcément besoin de plusieurs mois d’investigation pour répondre à ces questions.
## Raison #4 : Faire simple ne veut pas dire faire moins performant
De nombreuses approches et solutions permettent d’avoir dès le départ des performances tout à fait intéressantes. L’utilisation de services managés ou bien de briques logicielles déjà implémentées sur d’autres projets en sont des exemples.
Notre recommendation : Être convaincu que la valeur d’un Produit Data réside dans sa capacité à **r**épondre à une problématique business précise et exploitable en production\*\*.\*\*

Votre North Star pour un Produit Data doit être la mesure de son **impact business**.
Il est donc essentiel d’être au clair sur la problématique à résoudre. Dans ce cas de figure, le fait de vous lancer rapidement dans la réalisation d’un MVP est un moyen très efficace de vous assurer que vous apportez réellement de la valeur à ce problème. Et parfois, ou devrait-on dire souvent, lorsque l’on a passé un temps conséquent à réellement comprendre la problématique de ses utilisateurs, une visualisation de données claire ou bien quelques règles métier bien pensées pourront apporter une valeur incroyable.
Avoir rapidement un MVP avec une chaîne de traitement de bout en bout en production permet de se poser les bonnes questions et de considérer les bonnespriorités pour la suite. Est-ce vraiment sur l’amélioration des performances de votre modèle que vous devez concentrer toute votre énergie ? La boucle de feedback mise en place ne met-elle pas en évidence d’autres zones permettant de faire un plus grand gain en apport de valeur (focus sur la qualité de la donnée, incorporation de nouvelles sources de données, retravail de la mise à disposition des résultats, etc.) ?
Ne concluez pas de ces constats qu’il faut éviter de faire des PoCs. Il existe d’ailleurs selon nous deux principaux cas de figure pour lesquels le fait de ne pas aller en production est en réalité une bonne nouvelle :
## Lorsque le PoC en question est en fait une étude
Cette étude a pour but de répondre à une question précise par la donnée et de générer des enseignements à partir de celle-ci. Il n’est pas question ici de Produit, mais bien d’une analyse exploratoire. Toute la difficulté pour ne pas retomber dans l’écueil de l’exploration infinie est alors d’avoir une question précise à laquelle répondre.
## Lorsque le PoC a démontré que le projet n’apporte pas de valeur en l’état
Il n’est pas rare qu’en effet, un PoC permette de conclure qu’en l’état, il ne vaut pas la peine d’investir du temps et de l’argent dans la création d’un produit industrialisé. Est-ce un échec ? Aucunement, si vous avez bien structuré votre PoC et qu’il vous permet d’en tirer des enseignements concrets. Le PoC aura alors rempli entièrement son rôle : vous permettre de prendre une décision.
Après cette phase de PoC bien cadrée, le projet peut :
- Passer en phase MVP (Minimum Viable Product) ;
- Être mis en standby (par exemple faute de données, ressources disponibles ou changement de priorité) ;
- S’arrêter.
Les causes d’un arrêt peuvent être nombreuses : des validations des hypothèses non concluantes, un manque de données ou d’historique nécessaire, un apport minime par rapport à l’investissement, un outil du marché existant à moindre coût qui répond à la problématique, etc.
Nous sommes conditionnés par la crainte de l’échec, et tentons parfois de poursuivre des projets coûte que coûte bien que le gain potentiel soit très marginal, voire inexistant. Or, répondre “non” à la question “faut-il investir sur ce sujet ?” n’est pas un échec. C’est un enseignement à condition que ce “non” soit accompagné d’explications qui, elles, apportent une réelle valeur. **La décision de l’abandon d’un PoC fait partie du processus de Discovery en Data.**
C’est cette discipline de “**fail fast**” qui au final compte le plus, afin de tirer des enseignements au plus tôt et pivoter et garantir les succès futurs.
**Retrouvez l’ensemble des écueils limitant l’impact de la Data sur les produits et organisations dans notre** [**eBook**](https://eu1.hubs.ly/H01QVgc0) **dédié.**
---
### Tour d’horizon de l’IA Responsable
Source : https://www.hymaia.com/blog/tour-dhorizon-de-lia-responsable/
Tour d'horizon des piliers de l'IA Responsable et de ses 8 enjeux majeurs.
**“Responsible AI”, “Explainable AI”, “AI Fairness”, “Ethical AI”**, etc. Tous ces termes prennent de plus en plus d’ampleur dans les discussions mais aussi dans les investissements des entreprises qui créent des produits incorporant de l’Intelligence Artificielle.
Que ce soit d’un point de vue business pour mieux comprendre le raisonnement derrière certains modèles “Black Box” et prendre de meilleures décisions, ou d’un point de vue sociétal ou environnemental, une réelle prise de conscience est en train de se dessiner autour de ce sujet. **Si le potentiel incroyable de l’Intelligence Artificielle est maintenant compris et exploité depuis plusieurs années, son impact - voire sa dangerosité - sur nos vies, nos sociétés et notre environnement est de plus en plus scruté et débattu.**
L’IA Responsable n’est aujourd’hui plus seulement un sujet de débat, c’est devenu une réalité qu’il est nécessaire de prendre en compte dès les premières phases des projets à base de Machine Learning (ML). Mais qu’y a-t-il vraiment derrière ?
Cet article a pour objectif de démystifier ce qu’il se cache derrière ce sujet pour pouvoir en mesurer toute son étendue et sa complexité. Nous y aborderons des thématiques comme l’interprétabilité des modèles de Machine Learning, la place de l’humain dans les prises de décision à base d’IA, la gouvernance autour du ML, l’éthique, les biais présents à chaque étape du workflow du ML, la privacité et la sécurité.
Nous commencerons par un tour d’horizon des **principaux piliers de l’IA Responsable** mis en avant par quelques-uns de ses principaux acteurs, pour ensuite proposer une **catégorisation de ce domaine en 8 principaux enjeux**. Nous terminerons par une ouverture sur le sujet qui se veut optimiste, afin de montrer que le fait d’appliquer les principes de l’IA Responsable n’est pas qu’une question de restrictions à se donner, mais bien une opportunité pour **créer des produits responsables à haute valeur ajoutée.**
## Différents piliers de l’IA Responsable mis en avant
Pour définir l’IA Responsable, nous pouvons partir de la définition donnée dans le livre **\_“\_Responsible Artificial Intelligence”** (Springer) : _“Responsible Artificial Intelligence is about human responsibility for the development of intelligent systems along fundamental human principles and values, to ensure human-flourishing and well-being in a sustainable world.”_.
L’IA Responsable est devenu un enjeu stratégique pour beaucoup d’entreprises. Pour s’en convaincre, il suffit de faire un tour du côté de quelques géants du web qui ont publié des pages dédiées au sujet.
**Google** structure ses efforts sur le sujet autour de [4 concepts fondamentaux](https://ai.google/responsibilities/responsible-ai-practices/?category=fairness) : **Fairness** (que l’on pourrait traduire par “équité” ou “justice”), **Interpretability**, **Privacy** et **Security**. Ces 4 piliers spécifiques sont accompagnés de propositions de bonnes pratiques, qui viennent s’ajouter à l’ensemble de celles autour du développement logiciel et du Machine Learning que Google publie régulièrement.
De son côté, **Facebook** s’organise autour de [5 concepts clés](https://ai.facebook.com/blog/facebooks-five-pillars-of-responsible-ai/) pour concentrer et organiser ses travaux sur le sujet : **Privacy & Security**, **Fairness & Inclusion**, **Robustness & Safety**, **Transparency & Control** et **Accountability & Governance**. L’entreprise met notamment en avant, en plus des concepts techniques, des notions de rôles, d’organisation et de gouvernance qui sont clés dans le développement d’une réelle stratégie autour de l’IA Responsable.
Quant aux équipes de **Microsoft**, elles parlent de [6 axes essentiels](https://www.microsoft.com/en-us/ai/responsible-ai) pour une IA Responsable : **Fairness**, **Inclusiveness**, **Reliability & Safety**, **Transparency**, **Privacy & Security** et **Accountability**.
D’une manière similaire, d’autres organisations apparaissent et se structurent autour de ces principes fondamentaux. C’est le cas de l’**Institute for Ethical AI & Machine Learning**, un centre de recherche anglais engagé dans la structuration du sujet de l’IA Responsable, et proposant des principes et des méthodologies pour aller dans cette voie. Ils ont publié à cet égard 8 [“_Responsible Machine Learning Principles_”](https://ethical.institute/principles.html) : **Human Augmentation**, **Bias Evaluation**, **Explainability by justification**, **Reproducible Operations**, **Displacement Strategy**, **Practical Accuracy**, **Trust by Privacy** et **Data Risk Awareness**. Comme on peut le voir, si certains piliers sont similaires, un focus fort est aussi largement présent sur les impacts de l’IA par et sur les humains.
Dans un effort de structuration et de synthèse, nous allons revenir sur les principaux critères qui ressortent régulièrement pour bien représenter l’IA Responsable, et parler de leurs enjeux respectifs. Cette structuration se veut la plus représentative possible du sujet, mais ne se vante pas d’être exhaustive dans un domaine aussi mouvant que celui-ci.
---
### De la data science à la data analyse, une transition à reculons ?
Source : https://www.hymaia.com/blog/transition-data-science-data-analyse/
Passer de data scientist à data analyst, un retour en arrière ? Pas du tout. Retour d’expérience.
“_Tu vas commencer en tant que data analyst et d’ici 1 ou 2 ans tu seras data scientist, vu que data analyst est le junior de data scientist_” - 2019
_“Mais je ne comprends pas, tu étais data scientist et tu es passée data analyste ? C’est pas l’inverse normalement?”_ - 2023
En 2023, après 7 ans en data science j’ai décidé de bifurquer vers la data analyse, et j’ai envie d’expliquer pourquoi c’est aussi un choix logique, que non, ce n’est pas le mauvais sens et que data analyst is a sexy job too même si ce n’est pas un gros titre de Harvard Business Review.([https://hbr.org/2012/10/data-scientist-the-sexiest-job-of-the-21st-century](https://hbr.org/2012/10/data-scientist-the-sexiest-job-of-the-21st-century))
## Mon quotidien de data scientist
Être data scientist, qu’est ce que c’est ?
C’est construire un produit ou un outil constitué d’algorithmes de machine learning pour répondre à un problème métier. Les algorithmes sont là pour guider la machine à trouver d’elle même (apprentissage automatique) une logique dans les données pour produire un résultat comme une prédiction.__

### Les étapes classiques des projets de Data science
Pour chaque projet on commence par comprendre le besoin métier et prendre en main les données que l’on doit manipuler (les dimensions, qualité des données, liens entre variables…) pour s’assurer de la fiabilité de ce que l’on construit. S’en suit une partie recherche où l’on va tâtonner pour trouver une solution, essayer plusieurs possibilités, **sans garantie au départ de trouver une solution qui va répondre au besoin**.
Si l’essai est concluant et que l’on réussit à susciter l’intérêt des demandeurs métiers il faut industrialiser l’outil : s’occuper du passage à l’échelle (comment il fonctionne avec plus de données), être sûr de son fonctionnement dans le temps, le ré-entrainer … Toute cette phase (qui concerne davantage le Machine Learning Engineer) est indispensable si on ne veut pas créer des produits jetables, jamais utilisés et rester dans la sphère POC. Mais c’est aussi la phase qui m’intéressait le moins, une fois la solution imaginée, quand le problème réside dans la performance et le déploiement.
## Pourquoi aller vers la data analyse ?
Ce que j’aime faire, c’est aider à la décision : fouiller dans les données, en trouver des infos utiles et les communiquer de façon simple et claire pour les décideurs.
Cela s’apparente à être une “traductrice des données” : rendre l’information contenue sous un format “indigeste” dans un état plus accessible pour tous. \[Pour qu’ils en fassent bon usage bien sûr\]. Telle une archéologue, il y a une petite partie de moi qui aimerait faire une découverte sensationnelle qui changerait la face du monde / de l’entreprise ou au moins de mon équipe. Plus l’information est partagée au plus grand nombre, plus il y a de chance pour que quelqu’un l’exploite de façon intelligente.
Et il se trouve que c’est plus proche de la data analyse et de la data viz que mon quotidien en data science.
**Quelle serait ma définition de la data analyse alors ?**
C’est l’analyse de la donnée (👍 captain obvious) : faire un constat de ce qu’il se passe au présent et dans le passé dans le but de générer une action de la part des demandeurs ou pour les informer sur l’état de leurs activités.
L’idée n’est pas de faire une analyse descriptive de tout ce qu’on peut déduire d’un jeu de données mais plutôt de faire le tri dans ce qui est important, de relever les principaux indicateurs nécessaires pour suivre une activité ou aider à prendre une décision. Cela consiste donc à trouver les infos intéressantes dans un jeu de données et les exposer sous forme de dashboard ou autre pour les rendre vite accessibles et compréhensibles.
## Les différences et similitudes entre les deux métiers
Dans le cas de la data science, on a **construit un outil** qui repose sur la capacité de la machine à apprendre des règles basées sur des exemples de données et à tirer des conclusions pour faire une prédiction / une recommandation / générer du texte / autre.
En data analyse **on fait un constat** basé sur les données pour prendre des décisions business les plus éclairées possibles. **C’est donner des infos pour aider à agir** (vs construire un outil pour répondre à un besoin).

Voici un aperçu non exhaustif sur les compétences que j’ai apprises lors de mon parcours en data science qui m’ont été utiles pour la data analyse, celles que je n’utilise plus ou moins et enfin celles que j’ai du apprendre ou perfectionner.


## Conclusion
Les deux métiers sont issus de la même famille, sans relation hiérarchique entre les deux. Ils reposent sur une base commune mais ils ont bifurqué chacun vers sa route, chacun vers son chemin, pour répondre à des besoins différents - comme deux cousins germains qui s’entendent bien.
Lorsque j’ai voulu changer de domaine, je ne me suis pas fiée au nom de poste. Ils changent très vite, sont sujets à beaucoup d’effets de mode et sont assez spécifiques à l’entreprise.
J’ai vu des offres pour lesquelles le rôle de data analyste n’était exclusivement lié qu’à la qualité de la donnée sans la partie aide à la décision, pour d’autres ce poste était nommé data owner.
Il y a aussi l’émergence du poste d’Analytics Engineer dont le rôle est de créer des datasets et datapipeline robustes (s’appuyant sur les bonnes pratiques du software engineering) afin de donner plus de possibilités aux équipes métiers de faire leurs propres analyses et leurs suivis.
Ma technique a donc été de lister les choses que je souhaitais faire dans mon prochain métier et de regarder les descriptions de poste qui s’y approchaient le plus, peu importe leur libellé.
Je me suis rendue compte que j’étais davantage intéressée par la mission finale que par les techniques à utiliser et je ne suis pas fermée à réemployer du machine learning (surtout le non supervisé !) si je vois que ça peut servir mon analyse !
---